Fundamentos de IA
O que é uma Rede Generativa Adversarial (GAN)?

 Adicione Unite.AI às suas fontes preferidas no Google
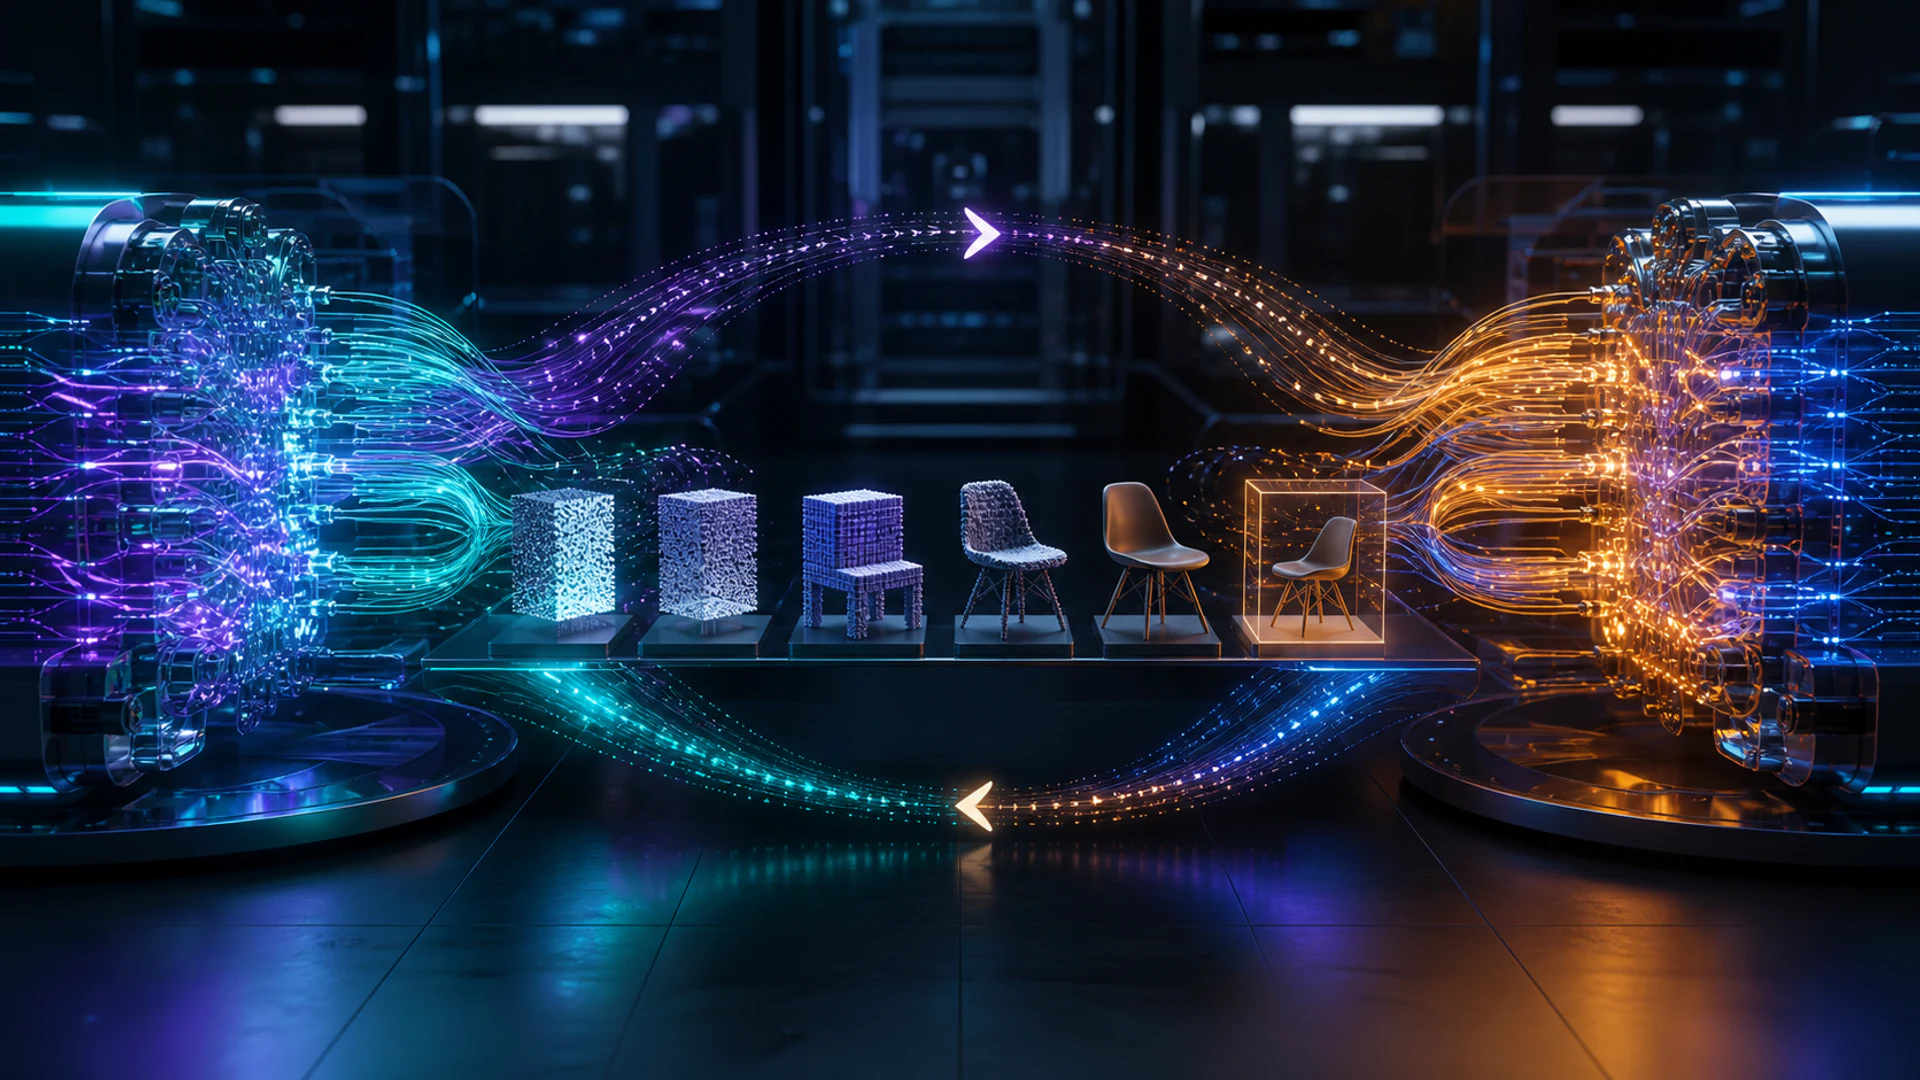
Uma rede generativa adversarial (GAN) treina duas redes neurais em competição. Um gerador converte entrada aleatória ou condicionada em amostras sintéticas. Um discriminador tenta distinguir as amostras geradas das exemplares reais de treinamento. O feedback de cada rede altera o problema de aprendizado da outra.
As GANs podem criar imagens nítidas e dados sintéticos controláveis, mas o treinamento adversarial é difícil de estabilizar. O realismo visual não comprova diversidade, validade factual ou permissão para usar os dados de treinamento.
Principais pontos
- O gerador produz amostras; o discriminador aprende um sinal de decisão real versus gerado.
- O treinamento busca um equilíbrio, mas mudar os oponentes pode causar instabilidade, oscilação ou colapso de modo.
- GANs condicionais controlam a geração com rótulos, texto ou outro contexto.
- A avaliação deve testar fidelidade, cobertura, memorização e risco subsequente — não apenas a qualidade da imagem.
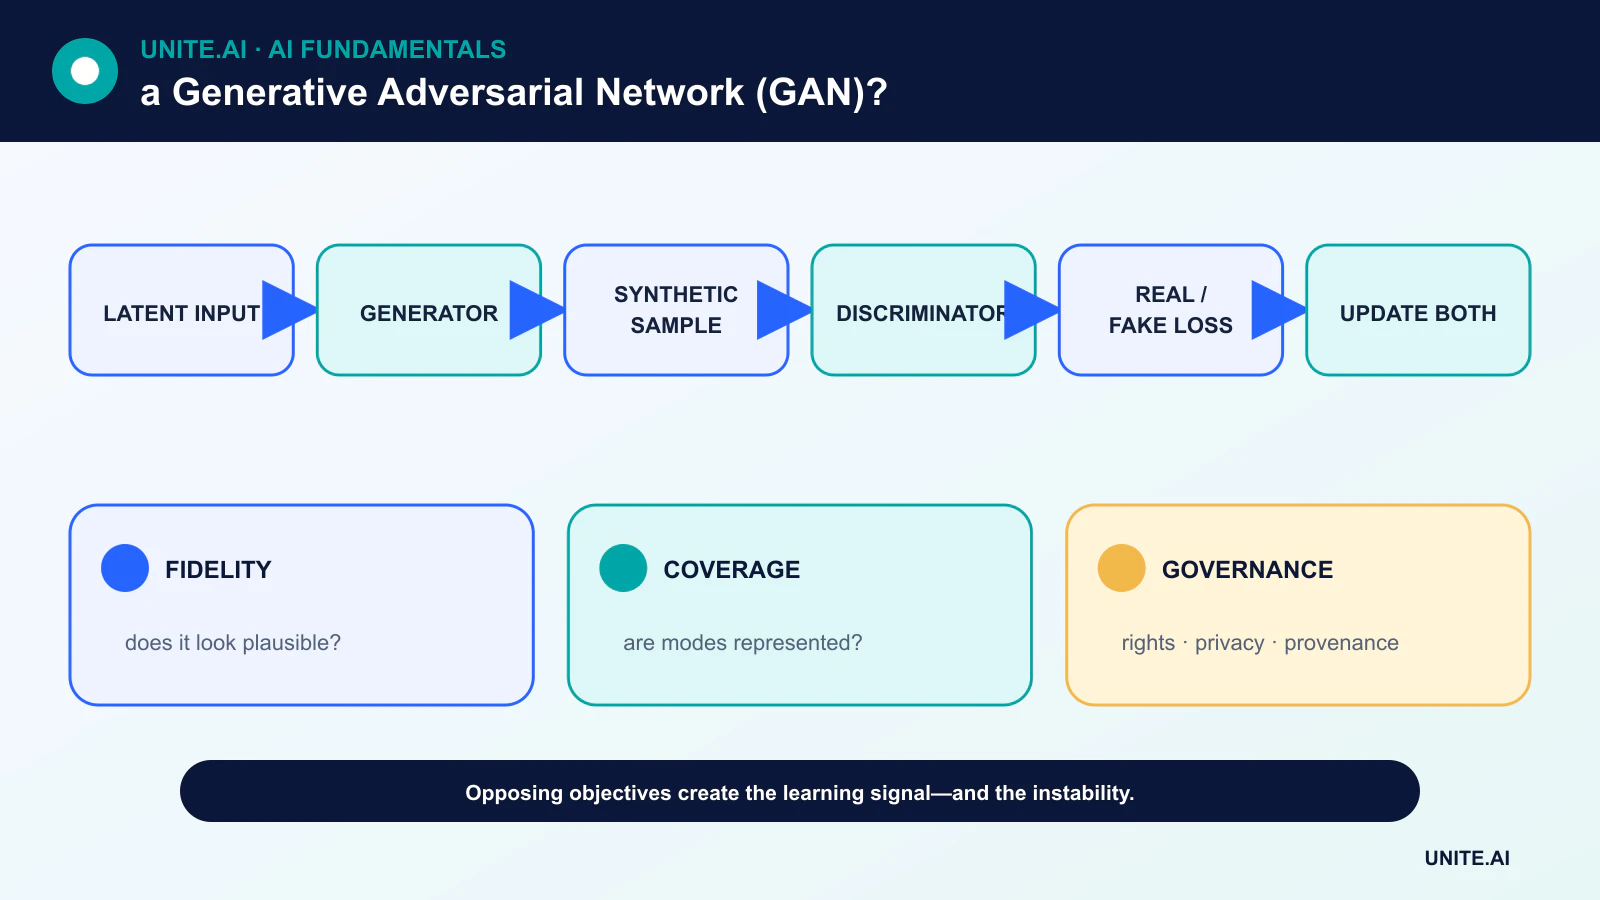
O jogo adversarial
A formulação original é um jogo minimax de dois jogadores. O discriminador melhora em separar dados reais dos gerados, enquanto o gerador aprimora a criação de amostras que o discriminador classifica como reais. Ambos são treinados com backpropagation.
Se o discriminador se tornar muito preciso, seu feedback ao gerador pode ser pouco útil. Se for muito fraco, o gerador pode explorar atalhos fáceis. Portanto, o treinamento alterna atualizações e equilibra cuidadosamente capacidade, perdas e configurações de otimização.
Colapso de modo e estabilidade de treinamento
O colapso de modo ocorre quando muitas entradas latentes produzem saídas semelhantes, de modo que as amostras parecem plausíveis, mas cobrem apenas parte da distribuição de dados. Outras falhas incluem oscilação, gradientes explosivos e sensibilidade à inicialização aleatória.
Objetivos Wasserstein, penalidades de gradiente, normalização espectral, mudanças de arquitetura e razões de atualização ajustadas podem melhorar a estabilidade. Eles não eliminam a necessidade de inspecionar a diversidade e repetir experimentos com múltiplas sementes.
Geração condicional e controle latente
Uma GAN condicional fornece ao gerador e ao discriminador um rótulo ou outro contexto, permitindo classes ou atributos direcionados. Arquiteturas baseadas em estilo separam aspectos do controle latente em diferentes resoluções e têm produzido imagens altamente realistas.
Direções latentes podem correlacionar‑se com conceitos humanos, mas editar um atributo pode alterar outros porque os dados de treinamento contêm características correlacionadas. Alegações de controlabilidade devem ser testadas em diversas identidades e contextos.
Avaliação, privacidade e proveniência
Métricas como Fréchet Inception Distance comparam distribuições de características, mas herdam suposições do modelo de características e podem perder memorização ou falhas em subgrupos. Análises de vizinho mais próximo, testes de cobertura no estilo precisão/recall e revisão humana fornecem evidências complementares.
Uma GAN pode memorizar exemplos raros, reproduzir vieses ou gerar mídia enganosa. As equipes devem documentar conjuntos de dados, direitos, filtragem, marca d’água ou mecanismos de proveniência e controles de uso indevido. Dados sintéticos não são automaticamente anônimos.
GANs, VAEs e modelos de difusão
Variational autoencoders otimizam um objetivo latente baseado em verossimilhança e frequentemente trocam nitidez das amostras por um espaço latente estruturado. Modelos de difusão aprendem a reverter um processo de ruído e se tornaram uma base comum para geração de imagens.
As GANs permanecem úteis quando amostragem rápida de passagem única, mapeamentos específicos de imagem para imagem ou implantação compacta são importantes. O método adequado depende de qualidade, diversidade, latência, estabilidade de treinamento e governança — não de qual arquitetura é a mais recente.
Objetivos adversariais e dinâmica de treinamento
Uma rede generativa adversarial treina um gerador para produzir amostras e um discriminador para distinguir dados gerados dos reais. No jogo minimax original, o discriminador estima um sinal relacionado à razão de densidade e o gerador tenta enganá‑lo. O treinamento alterna atualizações, de modo que cada rede aprende contra um oponente em movimento em vez de uma perda fixa. Se o discriminador ficar muito forte, os gradientes do gerador podem tornar‑se pouco úteis; se for muito fraco, a qualidade das amostras geradas estagna. O valor da perda por si só não corresponde diretamente à qualidade da amostra.
O colapso de modo ocorre quando o gerador produz variedades limitadas que enganam o discriminador. Oscilação, sensibilidade a hiperparâmetros e normalização instável também são comuns. Objetivos Wasserstein, penalidades de gradiente, normalização espectral, correspondência de características, estatísticas de minibatch e cronogramas de atualização cuidadosamente equilibrados abordam diferentes mecanismos de falha. GANs condicionais usam rótulos, texto ou imagens para orientar a saída; arquiteturas baseadas em estilo separam influências latentes. A qualidade e a cobertura do conjunto de dados permanecem fundamentais porque o gerador reproduz e recombina a distribuição que observa.
Avaliação e uso responsável
Avalie fidelidade e diversidade separadamente. Fréchet Inception Distance compara distribuições de características, mas depende do tamanho da amostra, modelo de características, pré‑processamento e domínio; Inception Score omite a comparação com dados reais. Precisão e recall para modelos generativos, análise de vizinho mais próximo, verificações de memorização e avaliação de tarefas humanas adicionam evidências. Para síntese científica ou médica, use métricas de domínio e validação subsequente. Mantenha um conjunto real reservado e compare com linhas de base de difusão ou autoregressivas com computação e resolução equivalentes.
As GANs podem ampliar dados, traduzir domínios, super‑resolver imagens, sintetizar mídia e apoiar simulação, mas dados sintéticos podem amplificar vieses ou vazar exemplos de treinamento. Verifique licenças, consentimento, identidade e proveniência. Proteja contra impersonação não consensual e uso enganoso, rotule ou assine as saídas quando apropriado e mantenha metadados da geração. Uma imagem fotorrealista não é prova documental; a incerteza e a origem sintética devem permanecer visíveis quando as saídas influenciam decisões.
Implantação e reprodutibilidade
Registre gerador, discriminador, otimizador, conjunto de dados, semente aleatória, truncamento e configurações de amostragem. Quantização ou exportação podem alterar a normalização e a saída, portanto valide o artefato de serviço. Monitore a distribuição de prompts ou condições, filtros de segurança, diversidade de saída, latência e relatórios. Use limites de taxa e salvaguardas de identidade em sistemas públicos. O treinamento de GAN é um experimento de otimização acoplada: imagens de demonstração selecionadas não podem estabelecer robustez, cobertura ou ausência de memorização, e um modelo deve ser avaliado sobre a distribuição completa das tarefas de geração pretendidas.
Exemplo prático: imagens sintéticas de defeitos com uma GAN
Um fabricante treina uma GAN condicional para criar imagens raras de defeitos de superfície. Verifica que as imagens de treinamento possuem direitos e separa lotes de produção antes do treinamento e da avaliação. As amostras geradas são verificadas quanto à memorização de vizinho mais próximo, geometria do defeito, artefatos de fundo, diversidade e plausibilidade por especialistas. Um classificador treinado com aumento sintético é avaliado apenas em defeitos reais independentes, comparado ao mesmo classificador com aumento convencional.
Dados sintéticos são aceitos somente se a taxa de recall no mundo real melhorar sem aumentar rejeições falsas ou erros em subgrupos. Configurações de geração e proveniência permanecem anexadas a cada imagem, e arquivos sintéticos nunca entram no conjunto de teste ou no arquivo de evidências como inspeções reais. Operadores não podem usar o gerador para fabricar registros de auditoria. A equipe compara alternativas de difusão e o custo de coletar mais exemplos reais, reconhecendo que aparência realista não prova que a GAN capturou o processo físico de falha.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais que uma demonstração bem‑sucedida. Defina os usuários pretendidos, o ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limite para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e aposentadoria. Use um lançamento em etapas, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, o comportamento da saída, a versão do modelo ou regra, a saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação em vez de presumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e de um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
Um GAN entende as imagens que cria?
Uma GAN aprende a estrutura estatística útil para geração. Isso não estabelece, por si só, compreensão semântica ou causal semelhante à humana.
Amostras geradas por GAN são seguras para uso como dados de treinamento?
Somente após verificar cobertura, validade dos rótulos, memorização, viés e se a distribuição sintética ajuda em um conjunto de teste real reservado.
Referências principais