
Fundamentos de IA
O que é a retropropagação?

 Adicione Unite.AI às suas fontes preferidas no Google
Retropropagação é o algoritmo usado para calcular como a perda de uma rede neural varia em relação aos seus parâmetros treináveis. Ele aplica a regra da cadeia do cálculo de forma reversa através das operações registradas durante uma passagem forward.
A retropropagação calcula gradientes; ela não decide, por si só, a atualização. Um otimizador como gradiente estocástico descendente ou AdamW usa esses gradientes para alterar pesos, vieses e outros parâmetros treináveis.
Principais pontos
- A passagem forward constrói valores intermediários e produz uma predição.
- A função de perda converte a predição e o alvo em um objetivo de treinamento escalar.
- A retropropagação usa derivadas locais e a regra da cadeia para calcular gradientes dos parâmetros de forma eficiente.
- Frameworks modernos implementam diferenciação automática em modo reverso sobre um grafo computacional.
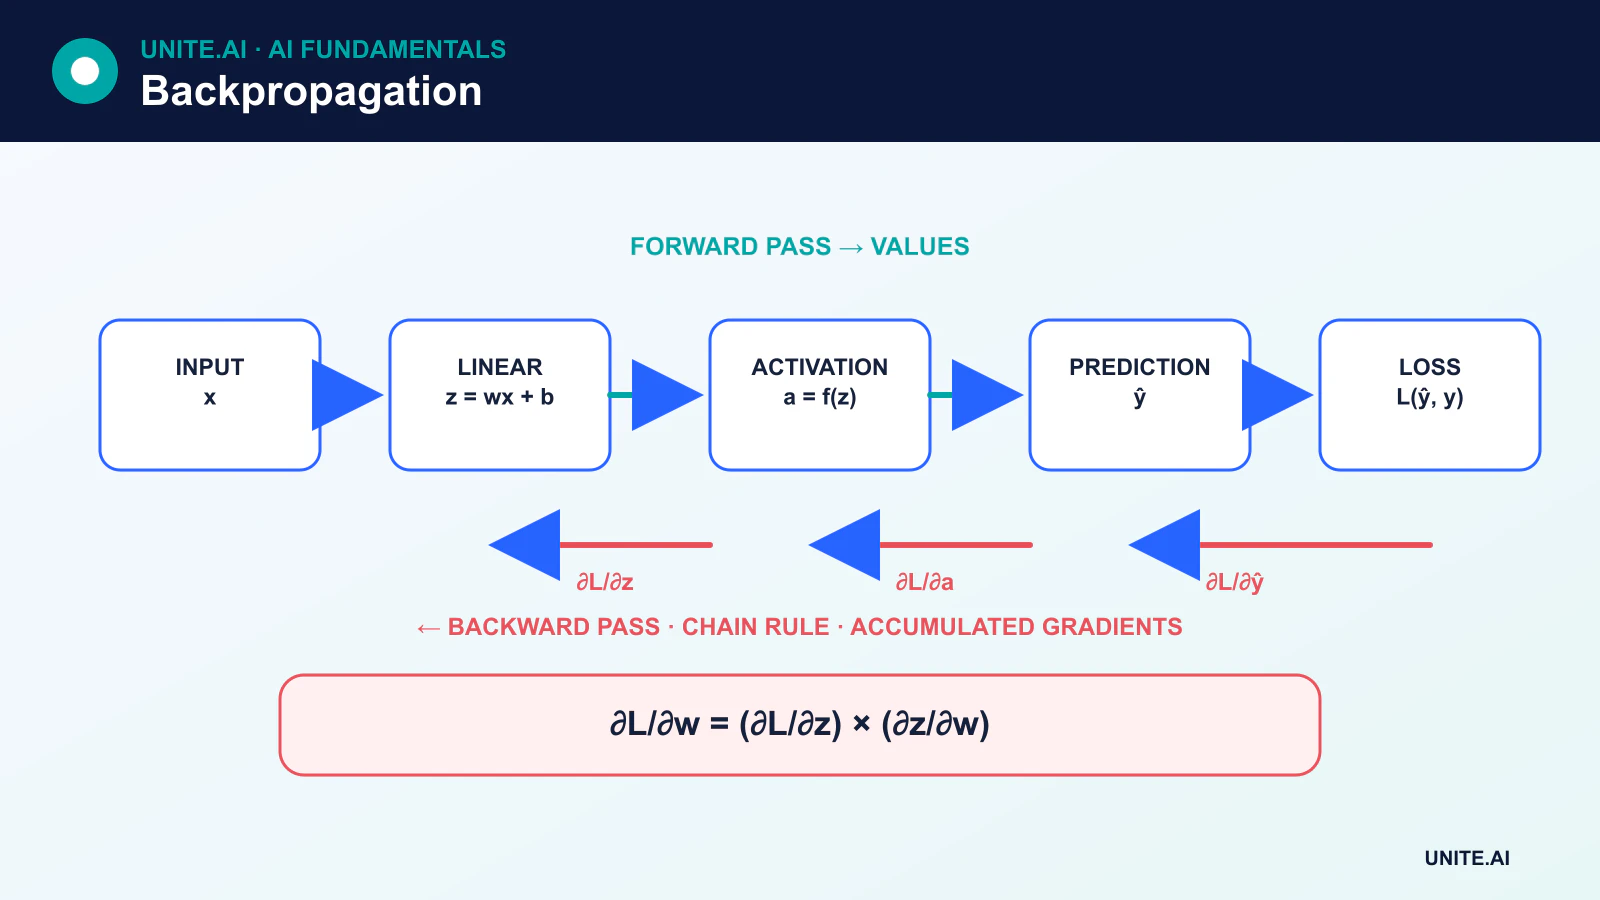
A passagem forward
Considere uma unidade simples:
z = wx + bŷ = activation(z)
A entrada é x, enquanto w e b são parâmetros treináveis de peso e viés. Os vieses normalmente mudam durante o treinamento assim como os pesos. Uma rede combina muitas dessas operações, além de normalização, atenção, convoluções, conexões residuais ou outros blocos diferenciáveis.
A passagem forward avalia essas operações e produz uma predição. Uma perda como entropia cruzada ou erro quadrático médio mede o objetivo. A melhor perda depende da tarefa e da interpretação da saída.
A regra da cadeia
Se a perda L depende de um valor intermediário z, e z depende do parâmetro w, a regra da cadeia fornece:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
Uma rede profunda contém muitos caminhos. A retropropagação percorre o grafo computacional em sentido reverso, acumulando contribuições quando um valor afeta a perda por mais de um caminho. O resultado é um gradiente para cada parâmetro treinável que participou da computação forward.
Um pequeno exemplo numérico
Suponha ŷ = wx + b, com x = 2, w = 3 e b = 1. A predição é 7. Se o alvo é 5 e a perda é L = ½(ŷ - y)², então:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
O otimizador pode então mover w e b na direção do gradiente negativo. Essa fórmula é específica da unidade linear escolhida e da perda de erro quadrático; uma regra universal de retropropagação é a regra da cadeia sobre o grafo real, não uma equação fixa de “erro”.
Retropropagação versus gradiente descendente
Gradiente descendente é um método de otimização. A retropropagação fornece os gradientes necessários. Um passo de treinamento geralmente segue:
- Limpar ou redefinir os gradientes armazenados.
- Executar a passagem forward.
- Calcular a perda.
- Executar a passagem backward.
- Aplicar a atualização do otimizador.
Separar esses conceitos facilita a compreensão de momentum, AdamW, acumulação de gradientes e treinamento de precisão mista.
Diferenciação automática
Frameworks como PyTorch registram operações e constroem um grafo durante a passagem forward. A diferenciação automática em modo reverso então calcula produtos vetor‑Jacobiano de forma eficiente dos resultados de volta aos parâmetros. Isso é mais geral que codificar manualmente derivadas para uma rede fixa e é fundamental para os frameworks modernos de aprendizado profundo.
Algumas operações são não diferenciáveis ou têm derivadas instáveis. Os frameworks definem subgradientes ou convenções documentadas em certos casos, mas os praticantes ainda precisam entender tensores destacados, operações in‑place e precisão numérica.
Gradientes que desaparecem e explodem
Multiplicações repetidas através de muitas camadas ou etapas de tempo podem tornar os gradientes extremamente pequenos ou grandes. Gradientes que desaparecem retardam o aprendizado nas camadas iniciais; gradientes que explodem desestabilizam as atualizações. Ativações da família ReLU, inicialização cuidadosa, conexões residuais, normalização, recorrência com portas e clipping de gradiente ajudam, mas nenhum é uma cura universal.
Verificando gradientes
A verificação de gradientes por diferenças finitas compara um gradiente analítico ou automático com uma aproximação numérica. É lenta, mas útil para depurar operações personalizadas. Monitorar normas de gradiente e detectar valores NaN ou infinitos pode revelar instabilidade durante o treinamento.
A regra da cadeia através de um grafo computacional
A retropropagação calcula eficientemente gradientes de uma perda escalar em relação a todos os parâmetros diferenciáveis. Uma passagem forward registra valores intermediários em um grafo computacional. Partindo da perda, a diferenciação automática em modo reverso aplica a regra da cadeia, multiplicando derivadas locais e acumulando contribuições onde os caminhos se encontram. Para uma camada y=f(x,w), a sensibilidade ascendente a y combina‑se com derivadas parciais para produzir sensibilidades para x e w. A retropropagação calcula gradientes; o otimizador decide como os parâmetros mudam.
Uma camada afim simples produz y=Wx+b. O gradiente para W é o produto externo do gradiente ascendente e da entrada, o gradiente para b soma os valores ascendentes, e o gradiente da entrada multiplica pela matriz de pesos transposta. Ativações adicionam derivadas elemento a elemento. Convolução, normalização, atenção e reutilização recorrente seguem o mesmo princípio de grafo, mas exigem formas corretas de tensores, broadcasting, mascaramento e compartilhamento de parâmetros. Os frameworks liberam as ativações salvas após o backward, a menos que sejam retidas, de modo que a memória costuma crescer com o tamanho do lote, profundidade e comprimento da sequência.
Falhas de gradiente, verificação e prática de engenharia
Produtos de muitas derivadas podem desaparecer ou explodir. Ativações semelhantes a ReLU, inicialização cuidadosa, normalização, conexões residuais, portas e clipping de gradiente abordam diferentes mecanismos. Ativações saturadas e operações não diferenciáveis podem bloquear sinais úteis; retropropagação truncada limita o histórico da sequência; precisão mista pode subfluxar sem escalonamento da perda. Gradientes que explodem são um sintoma, portanto o clipping deve ser acompanhado de investigação da taxa de aprendizado, dados, arquitetura e erros numéricos, em vez de apenas mascará‑los.
Verifique operações personalizadas com verificações de gradiente por diferenças finitas em pequenas entradas de precisão dupla, evitando pontos não diferenciáveis. Inspecione normas de gradiente, NaNs, parâmetros inativos e se os gradientes chegam aos módulos esperados. Limpe gradientes acumulados deliberadamente e distinga comportamento de treinamento e avaliação para dropout e normalização. O checkpoint recomputa ativações para economizar memória; treinamento distribuído deve agregar gradientes de forma consistente. Uma perda de treinamento decrescente mostra que existe um caminho de otimização, não que os gradientes estejam conceitualmente corretos, que os dados estejam livres de vazamento ou que o modelo generalize.
Exemplo prático: verificando uma camada neural personalizada
Um engenheiro implementa uma camada espectral diferenciável para uma rede de áudio. Um teste minúsculo de precisão dupla compara gradientes automáticos com diferenças finitas centrais ao longo de entradas e parâmetros, excluindo pontos onde a operação é intencionalmente não diferenciável. Forma, broadcasting, preenchimento e conversão complexo‑para‑real recebem casos separados. O teste verifica gradientes acumulados quando um parâmetro é reutilizado e confirma que quadros de áudio mascarados não produzem gradiente.
Durante o treinamento, painéis acompanham normas de gradiente e ativação, NaNs, parâmetros inativos e escalonamento da perda. Um lote deliberadamente corrompido confirma que a validação captura saída não finita antes de uma atualização do otimizador. Precisão mista e implementações exportadas são comparadas com a referência. Testes de retomada de checkpoint incluem estado do otimizador e ordem aleatória. A camada não é aceita apenas porque a perda total diminui; gradientes unitários, estabilidade numérica e generalização downstream devem todos fornecer evidência consistente.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes de ajustar. Teste casos ordinários, condições de fronteira, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa junto com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre toda transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, rollback e aposentadoria. Use um rollout escalonado, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, então revise evidências do mundo real após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
A retropropagação atualiza os pesos?
A retropropagação calcula gradientes. O otimizador aplica uma atualização usando esses gradientes, sua taxa de aprendizado e, possivelmente, estado como momentum ou momentos adaptativos.
A retropropagação é biologicamente realista?
A retropropagação padrão é um algoritmo de engenharia e não é aceita como um modelo detalhado de aprendizado em cérebros biológicos. A analogia neural histórica não deve ser tratada como equivalência biológica.
Referências principais












