
Fundamentos de IA
O que é Visão Computacional?

 Adicione Unite.AI às suas fontes preferidas no Google
Visão computacional é o campo de construção de sistemas que extraem informações úteis de imagens e vídeos. Um modelo de visão pode classificar uma imagem inteira, localizar objetos, rotular cada pixel, ler texto, estimar pose, rastrear movimento ou conectar conteúdo visual com linguagem.
Os sistemas de visão modernos não reproduzem simplesmente o processo inicial de detecção de bordas da percepção humana. Eles aprendem representações específicas da tarefa a partir de dados, frequentemente usando redes neurais convolucionais, transformadores de visão ou modelos de fundação multimodais.
Principais pontos
- Classificação, detecção, segmentação, OCR, rastreamento e geração são tarefas de visão distintas.
- CNNs incorporam localidade e compartilhamento de pesos; transformadores de visão usam atenção entre patches de imagem.
- Rótulos podem vir de humanos, supervisão fraca, dados sintéticos ou objetivos auto‑supervisionados.
- Precisão isolada é insuficiente: robustez, latência, privacidade, viés e custos de falha são importantes.
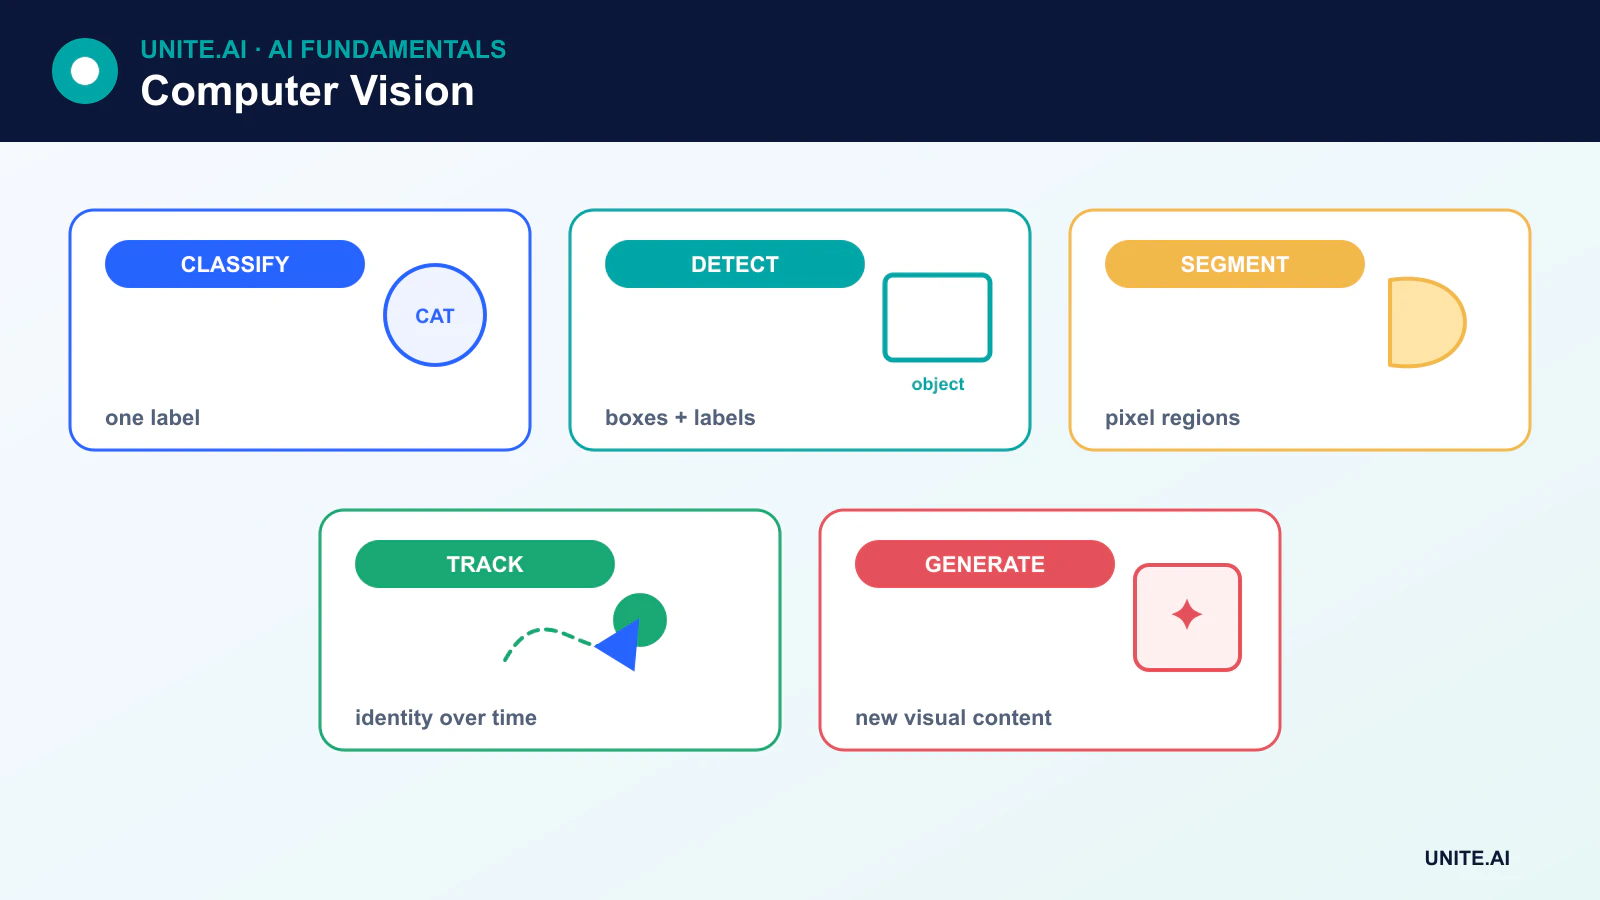
As principais tarefas de visão computacional
- Classificação de imagens atribui um ou mais rótulos a uma imagem. Veja como funciona a classificação de imagens.
- Detecção de objetos prevê categorias e caixas delimitadoras para múltiplos objetos.
- Segmentação semântica rotula cada pixel por classe, enquanto a segmentação de instâncias separa objetos individuais.
- Reconhecimento óptico de caracteres (OCR) detecta e transcreve texto.
- Estimativa de pose prevê marcos corporais ou de objetos.
- Rastreamento associa detecções ao longo de quadros de vídeo.
- Geração e edição de imagens produz ou transforma conteúdo visual, frequentemente usando modelos de difusão.
Como as imagens se tornam entradas de modelo
Uma imagem digital já é dados numéricos: um tensor contendo valores de pixel ao longo de dimensões espaciais e canais. O pré‑processamento pode redimensionar, normalizar, recortar ou aumentar a imagem. Vídeo adiciona uma dimensão temporal, enquanto imagens médicas e científicas podem acrescentar profundidade, comprimento de onda ou outras modalidades.
A visão computacional clássica utilizava recursos de borda, canto e textura projetados manualmente. Modelos profundos modernos geralmente aprendem recursos conjuntamente com a tarefa, embora métodos clássicos ainda sejam úteis quando os dados são limitados, as regras bem compreendidas ou o poder computacional deve ser mínimo.
CNNs e recursos locais aprendidos
Uma CNN aplica kernels aprendidos em vizinhanças locais. Camadas iniciais podem responder a padrões locais, enquanto blocos posteriores os combinam em representações relevantes para a tarefa. Operações de pooling ou stride reduzem a resolução espacial, e conexões residuais facilitam a otimização de redes profundas.
Um classificador CNN moderno costuma usar pooling global em vez de uma grande pilha de camadas totalmente conectadas. Detectores e redes de segmentação adicionam cabeças especializadas ou caminhos decodificadores que preservam informações espaciais.
Transformadores de visão e modelos de fundação
Um transformador de visão divide uma imagem em patches, incorpora‑os e usa atenção para modelar suas relações. Transformadores podem escalar efetivamente com grandes conjuntos de dados e pré‑treinamento, enquanto CNNs frequentemente oferecem suposições incorporadas mais fortes e eficiência em escalas menores.
Modelos multimodais alinham imagens com texto para que os usuários possam buscar, gerar legendas, responder perguntas ou orientar segmentação usando linguagem. Esses modelos ampliam a capacidade, mas também herdaram fraquezas de dados em escala web ampla, incluindo estereótipos, material protegido por direitos autorais e cobertura desigual de populações e ambientes.
Rótulos, auto‑supervisão e dados sintéticos
Caixas delimitadoras, máscaras, marcos e legendas podem ser caros de criar. Aprendizado auto‑supervisionado deriva objetivos das próprias imagens, enquanto supervisão fraca usa rótulos ruidosos ou indiretos. Dados sintéticos podem acrescentar cenários raros, mas lacunas de simulação podem impedir que o desempenho sintético se transfira ao mundo real.
A qualidade da anotação deve ser medida. Rótulos ambíguos, limites inconsistentes e objetos ausentes impõem um teto ao desempenho e podem ocultar falhas em subgrupos.
Como os sistemas de visão são avaliados
Classificação usa métricas como acurácia, precisão, recall, F1 e calibração. Detecção costuma usar interseção sobre união e média de precisão média (mAP). Segmentação usa interseção sobre união ou medidas no estilo Dice. Rastreamento adiciona métricas de identidade e trajetória.
A métrica deve corresponder ao cenário de implantação. Um modelo pode obter boa pontuação em um benchmark curado e ainda falhar em chuva, baixa iluminação, ângulos de câmera incomuns, novos dispositivos ou populações desconhecidas. A avaliação deve incluir mudança de distribuição, condições adversárias e latência operacional.
Privacidade, viés e implantação
Rostos, placas de veículos, residências, exames médicos e vídeos de ambientes de trabalho podem revelar informações sensíveis. A coleta e retenção devem seguir uma base legal e ética definida, com controles de acesso e minimização de dados. Análises faciais e identificação biométrica merecem atenção especial, pois erros e vigilância podem impor danos desiguais.
A implantação na borda pode reduzir latência e transferência de dados. Edge AI, quantização, podas e aceleradores especializados podem tornar os sistemas de visão práticos em câmeras, veículos, robôs e dispositivos móveis, mas a compressão deve ser reavaliada quanto à acurácia e ao viés.
De pixels a tarefas visuais
Visão computacional transforma imagens ou vídeos em saídas de tarefa como classificação, detecção, segmentação, rastreamento, pose, profundidade, fluxo óptico ou reconhecimento de texto. A definição da tarefa determina a anotação: um rótulo de imagem não pode treinar localização precisa, e uma caixa delimitadora não pode descrever completamente uma máscara de segmentação. Geometria da câmera, lentes, exposição, iluminação, movimento, compressão e ponto de vista moldam a distribuição dos dados. Defina o ambiente operacional e as consequências de erro antes de selecionar um modelo, pois uma coleção de imagens de benchmark pode não representar o sensor ou a cena implantados.
Um pipeline decodifica e orienta a mídia, redimensiona ou divide em blocos, normaliza valores, aplica aumentos que preservam rótulos, executa um modelo e pós‑processa logits, caixas, máscaras ou rastros. Detectores de objetos usam limiares de confiança e supressão; rastreadores associam detecções ao longo do tempo; segmentação pode exigir limpeza morfológica. Preserve transformações de coordenadas para que as saídas se alinhem à imagem original. Divida os dados por pessoa, câmera, localização ou sessão de captura para evitar que quadros quase idênticos apareçam tanto no conjunto de treinamento quanto no de teste.
Avaliação, viés, privacidade e operações
As métricas devem corresponder à tarefa e ao uso. Classificação requer precisão e recall específicos por classe; detecção usa interseção‑sobre‑união e precisão média em diferentes limiares; segmentação usa IoU ou Dice; rastreamento adiciona trocas de identidade; latência e duração de eventos perdidos são importantes para vídeo. Relate resultados por iluminação, distância, dispositivo, oclusão, tom de pele, idade e outras condições relevantes. Inspecione a calibração e erros de alta confiança. Dados sintéticos ou aumentados podem preencher lacunas, mas exigem comparação com dados reais de implantação e não devem vazar cenas de teste.
A visão pode coletar espectadores, locais, biometria e comportamentos sensíveis. Minimize a captura e retenção, assegure fluxos, restrinja o uso secundário e forneça aviso ou consentimento quando necessário. Teste patches adversariais, replay, oclusão, falha de câmera e mudança de domínio. Monitore a saúde do sensor, estatísticas de entrada, taxas de saída e resultados confirmados; mantenha revisão humana para decisões críticas. Desfocar ou recortar pode reduzir a exposição, mas também pode remover evidências. Uma alta pontuação em laboratório não justifica alegações de identidade, emoção ou intenção além da tarefa validada.
Perguntas frequentes
As câmeras monitoram uma passagem restrita de veículos, e o modelo detecta pessoas em vez de identificá-las. Os dados abrangem dia e noite, condições meteorológicas, roupas, oclusão, usuários de cadeira de rodas, posições das câmeras e cenas vazias, com a divisão feita por sessão de gravação. O detector é avaliado quanto à revocação de eventos, falsos alarmes, localização, antecedência do aviso e desempenho a distância. A engenharia de segurança define a latência máxima tolerada e controles físicos independentes.
O alerta de visão pode desacelerar um veículo, mas as paradas de emergência e as barreiras não dependem do modelo aprendido. Obstrução da câmera, quadros congelados, perda de rede e tempo limite do modelo geram falhas explícitas. A retenção de vídeo bruto é minimizada e o acesso é registrado. O monitoramento acompanha a integridade dos sensores, as taxas de alerta, os incidentes revisados e os quase acidentes por condição. Qualquer reposicionamento da câmera ou alteração do layout exige nova validação, pois a semelhança aparente das imagens não garante a mesma geometria nem o mesmo risco.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entrada malformada ou ausente, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, rollback e aposentadoria. Use um rollout em fases, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
Visão computacional é a mesma coisa que reconhecimento de imagens?
Não. Reconhecimento de imagens geralmente se refere à classificação ou identificação. Visão computacional também inclui localização, segmentação, medição, rastreamento, reconstrução, geração e raciocínio sobre informações visuais.
Um sistema de visão vê como um ser humano?
Não. Um modelo processa entradas numéricas de acordo com sua arquitetura e objetivo de treinamento. Ele pode superar pessoas em um benchmark restrito, mas falha em pequenas mudanças que uma pessoa lida facilmente.
Referências principais












