Fundamentos de IA
O que é IA Generativa?

 Adicione Unite.AI às suas fontes preferidas no Google
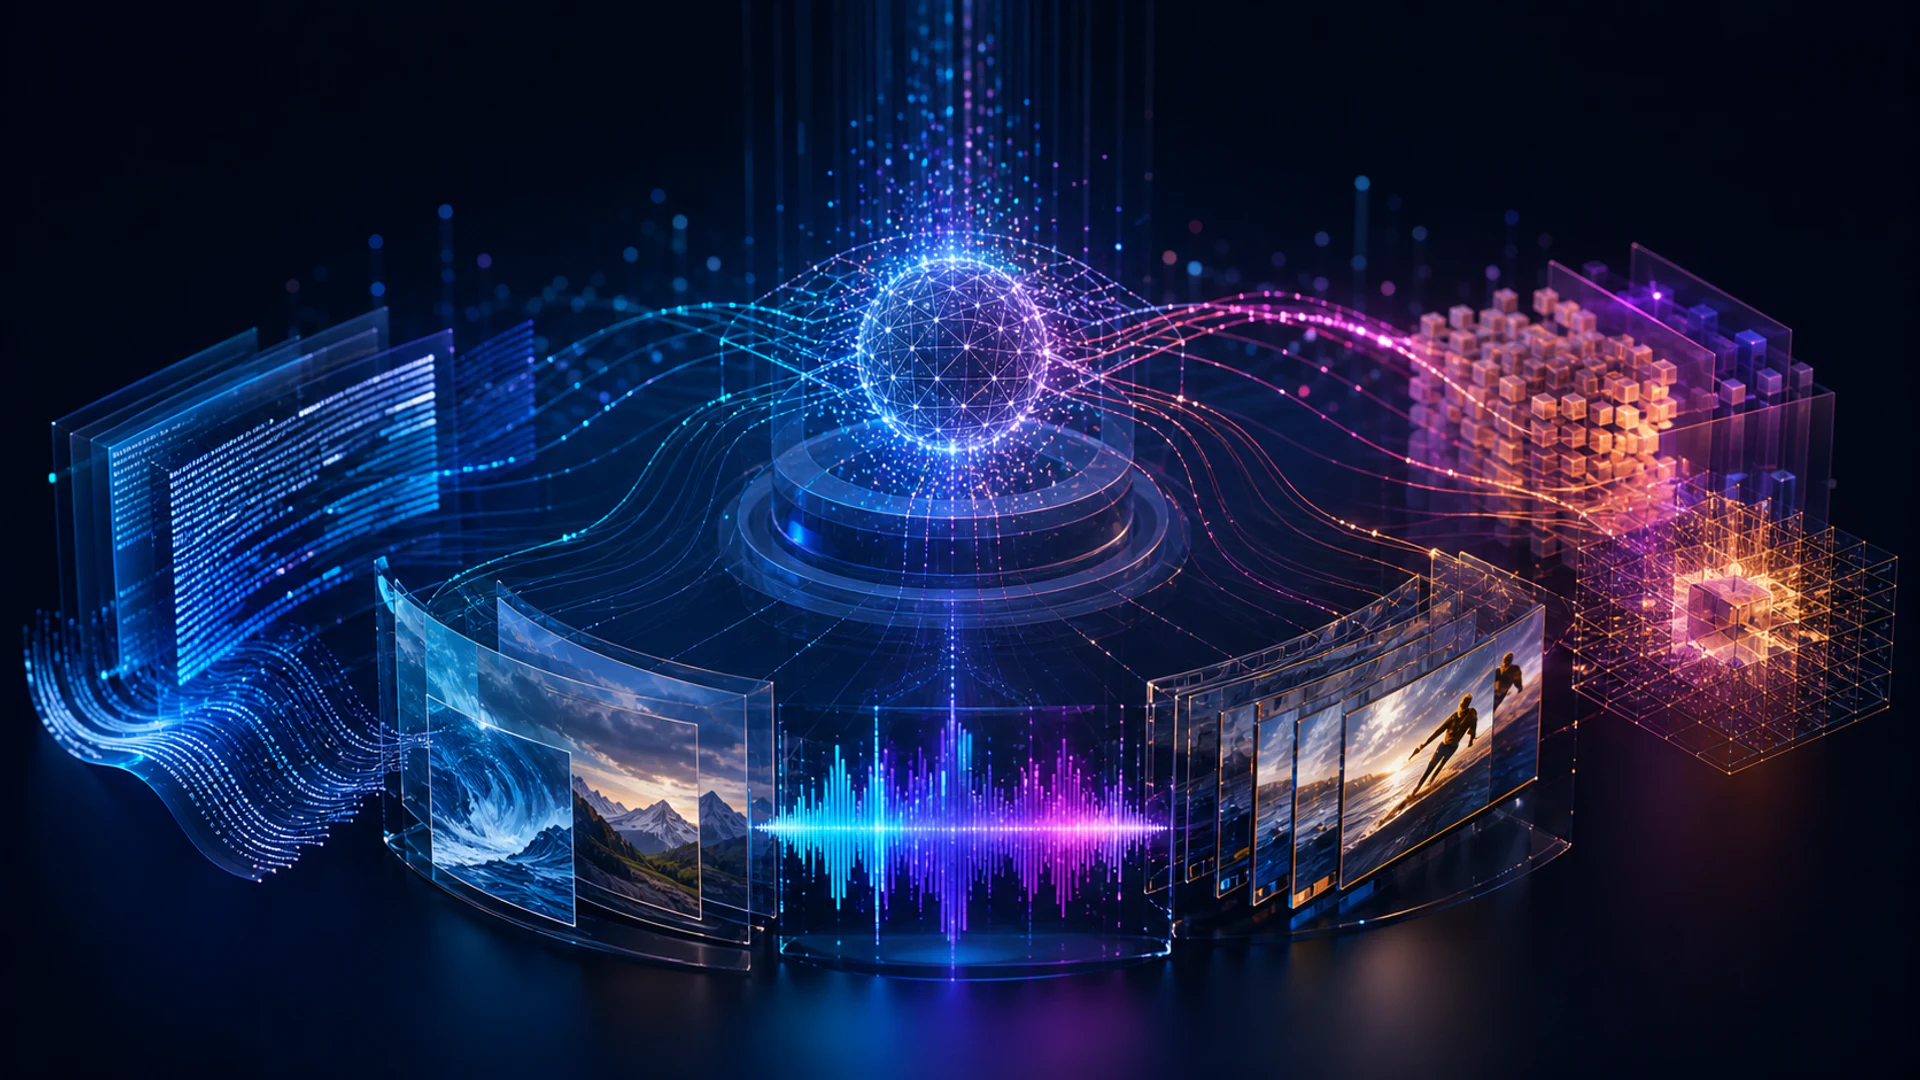
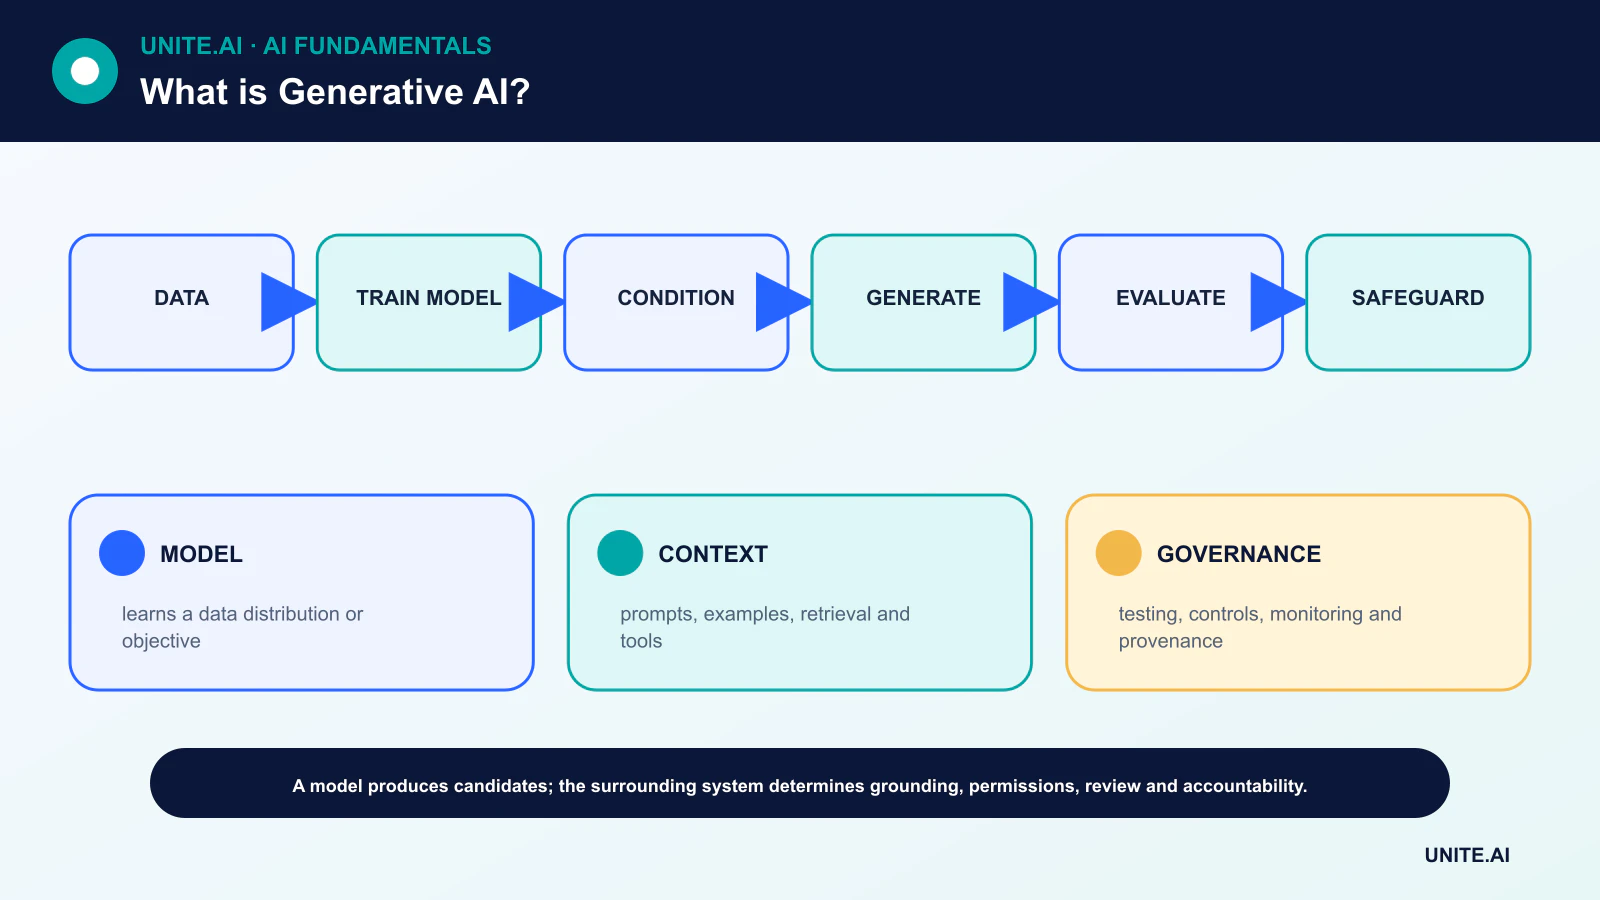
IA generativa refere‑se a modelos que aprendem padrões em dados e produzem novo texto, imagens, áudio, vídeo, código ou outras representações quando condicionados por instruções ou exemplos. A saída é sintetizada a partir de um modelo probabilístico; não é recuperada intacta de um banco de dados, embora ferramentas de recuperação possam fornecer evidências externas.
Diferentes famílias de modelos geram de maneiras distintas. Transformers autorregressivos preveem uma sequência um token por vez, modelos de difusão removem ruído iterativamente de uma amostra, e redes adversariais generativas aprendem por meio de um concurso entre um gerador e um discriminador.
Principais conclusões
- A geração é amostragem condicional de uma distribuição aprendida, não garantia de recordação factual.
- Transformers, modelos de difusão, GANs e autoencoders variacionais apresentam compensações diferentes.
- Recuperação e ferramentas podem fundamentar um sistema, mas suas saídas e permissões ainda exigem validação.
- A gestão de riscos abrange dados, modelo, interface, implantação, monitoramento e proveniência do conteúdo.
Como os modelos generativos aprendem
Os objetivos de treinamento recompensam um modelo por prever ou reconstruir padrões nos exemplos. Um modelo de linguagem estima o próximo token; um modelo de difusão aprende a reverter um processo de ruído; um autoencoder variacional aprende uma distribuição latente estruturada e um decodificador.
Esse treinamento cria generalização estatística, mas também pode reproduzir vieses, memorizar sequências incomuns ou falhar fora da distribuição dos dados. Documentação de conjuntos de dados, desduplicação, controles de privacidade e avaliação em dados reservados são, portanto, importantes antes da implantação.
Principais famílias de arquitetura
Autoregressive transformers dominam texto e suportam sequências multimodais. Modelos de difusão são amplamente usados para geração de imagens e áudio de alta fidelidade. GANs podem criar amostras nítidas e sistemas de imagem controláveis, mas podem ser difíceis de treinar.
Autoencoders variacionais fornecem modelagem de variáveis latentes e representações eficientes, às vezes atuando dentro de pipelines generativos maiores. Produtos reais frequentemente combinam vários modelos com recuperação, filtros, ferramentas e código determinístico.
Condicionamento, amostragem e controle
Um prompt, rótulo de classe, imagem, clipe de áudio ou registro estruturado pode condicionar a geração. Parâmetros de amostragem alteram diversidade e determinismo. Temperatura mais baixa pode concentrar as probabilidades dos tokens, mas não torna uma resposta incorreta verdadeira.
O controle melhora quando o sistema utiliza esquemas explícitos, decodificação restrita, material de referência e validação. Prompt engineering altera o contexto; o ajuste fino modifica parâmetros; a recuperação fornece informações externas. Cada um aborda um modo de falha diferente.
A avaliação é específica da aplicação
Sistemas de texto podem precisar de testes de factualidade, conclusão de tarefas, suporte a citações, toxicidade e calibração. Sistemas de imagem ou áudio podem precisar de fidelidade, alinhamento semântico, diversidade, segurança de identidade e revisão perceptual. Combine métricas automatizadas com avaliação humana representativa.
Construa um conjunto de avaliação versionado que inclua casos comuns, raros, adversariais e relevantes para políticas. Monitore latência, custo e comportamento de recusa, bem como a qualidade da saída. Uma demonstração selecionada por seu criador não é evidência de confiabilidade em nível populacional.
Riscos, salvaguardas e proveniência
Riscos importantes incluem alucinação, injeção de prompt, conteúdo nocivo, personificação, uso inseguro de ferramentas, vazamento de privacidade, disputas de direitos autorais, viés de automação e cadeias de suprimento opacas. O Perfil de IA Generativa da NIST organiza ações em governança, proveniência de conteúdo, testes pré‑implantação e divulgação de incidentes.
Utilize ferramentas de privilégio mínimo, controles de entrada/saída, revisão humana para decisões consequenciais, registro de logs, reversão e reporte de usuários. Marcas d’água ou credenciais de conteúdo podem adicionar sinais, mas nenhum detector ou rótulo único estabelece a verdade. O fluxo de trabalho mais amplo de mídia sintética deve preservar o contexto e a responsabilidade.
Famílias de modelos e mecanismos de geração
Modelos de IA generativa estimam ou aprendem um processo que pode produzir novo texto, imagens, áudio, vídeo, código ou dados estruturados. Modelos autorregressivos preveem o próximo token ou elemento; modelos de difusão aprendem a reverter um processo de ruído; autoencoders variacionais aprendem variáveis latentes probabilísticas; GANs treinam um gerador contra um discriminador. Sistemas multimodais conectam representações entre diferentes mídias. A saída é amostrada da estrutura estatística aprendida condicionada a prompts, contexto, ferramentas ou outras entradas — não é recuperada como um fato garantido.
Modelos de base são pré‑treinados em dados amplos e adaptados por meio de prompting, recuperação, ajuste fino, otimização de preferências, redes de controle ou cabeçalhos específicos de tarefa. Tokenizadores, codificadores, decodificadores, espaços latentes e configurações de amostragem moldam os resultados. Temperatura e filtragem de candidatos negociam entre determinismo e diversidade. Prompts mais longos fornecem contexto, mas podem conflitar, distrair ou conter instruções maliciosas. A recuperação pode fundamentar conhecimento em mudança, enquanto código determinístico deve lidar com cálculos exatos e regras.
Avaliação, proveniência e direitos
Avalie por tarefa: correção factual e citação para respostas, execução e segurança para código, fidelidade e diversidade para mídia, e resultado humano para assistência criativa. Inclua recusa, calibração, latência, custo, idiomas, acessibilidade e testes adversariais. Uma saída fluente ou fotorrealista pode estar errada. Preserve modelo, prompt, semente, evidência de origem, chamadas de ferramentas e pós‑processamento para reproducibilidade. Separe a qualidade da recuperação da geração para que uma resposta polida não possa ocultar evidências ausentes.
Treinamento e saídas levantam questões de direitos autorais, licenças, consentimento, privacidade, publicidade e confidencialidade. Estabeleça a proveniência e uso permitido dos dados de entrada; impeça usuários de expor segredos; teste a memorização; e forneça processos de reporte e remoção. Mídia sintética deve portar proveniência durável ou divulgação quando viável, especialmente quando pode ser confundida com evidência. Não use semelhança, voz ou estilo de maneira que viole direitos ou engane.
Controles de implantação
Trate a saída do modelo como entrada não confiável. Valide esquemas, higienize código e arquivos, isole a execução, autorize cada ferramenta externamente, limite custo e taxa, e exija confirmação para ações consequenciais. Monitore falhas, abusos, deriva e correções de usuários, com reversão e uma alternativa não generativa. Documente usos pretendidos e proibidos. IA generativa amplia a interface para criar e transformar informação, mas a confiabilidade e responsabilidade provêm dos dados circundantes, avaliação, segurança, proveniência e processo de decisão humana.
Exemplo prático: um assistente generativo de descrição de produto
Um varejista permite que editores gerem rascunhos de descrições apenas a partir de atributos de produto aprovados e diretrizes de marca. O prompt inclui fatos estruturados, enquanto a recuperação fornece a política atual. A saída deve seguir um esquema e é validada contra valores de origem; dimensões não suportadas, alegações de segurança ou certificações provocam rejeição. A avaliação cobre precisão factual, estilo, duplicação, qualidade multilíngue, acessibilidade, latência e correção do editor, comparada com modelos e escrita manual.
Os editores aprovam cada publicação e podem ver os campos de origem. O modelo não tem capacidade de alterar preço, estoque ou publicar diretamente. Prompts e dados de produto são protegidos contra injeção, e notas confidenciais de fornecedores são excluídas. O monitoramento rastreia alegações não suportadas, edições, reclamações, custos e versões do provedor. O texto gerado é armazenado com proveniência. O sistema economiza tempo de redação apenas se correções e revisões não anularem o benefício e a veracidade do produto permanecer governada por dados autoritativos.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limite para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e desativação. Use um rollout em etapas, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade das entradas, comportamento das saídas, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, então revise evidências do mundo real após a implantação ao invés de presumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
IA generativa é a mesma coisa que um grande modelo de linguagem?
Não. LLMs são uma classe de modelo generativo. IA generativa também inclui sistemas de imagem, áudio, vídeo e dados estruturados construídos com várias arquiteturas.
Um modelo copia seus dados de treinamento?
Normalmente, ele sintetiza a partir de padrões aprendidos, mas a memorização e a quase duplicação podem ocorrer. Riscos de privacidade e proveniência devem ser avaliados, não presumidos como inexistentes.
Referências principais