
Fundamentos de IA
O que é um Autoencoder?

 Adicione Unite.AI às suas fontes preferidas no Google
Um autoencoder é uma rede neural treinada para reconstruir sua entrada. Um codificador mapeia a entrada para uma representação latente; um decodificador mapeia essa representação de volta para uma reconstrução. O treinamento minimiza uma perda de reconstrução, às vezes com restrições adicionais.
Copiar a entrada perfeitamente não é automaticamente útil. A arquitetura ou o objetivo deve criar um gargalo, adicionar ruído, impor esparsidade ou, de outra forma, impedir um mapeamento identidade trivial, de modo que o código latente capture uma estrutura útil.
Principais pontos
- O codificador comprime ou transforma uma entrada; o decodificador a reconstrói a partir de um código latente.
- Um gargalo subcompleto, ruído ou regularização incentivam o modelo a aprender estrutura em vez de copiar.
- O erro de reconstrução pode apoiar a detecção de anomalias, mas as anomalias não têm garantia de apresentar erro elevado.
- Autoencoders variacionais aprendem um modelo latente probabilístico e diferem dos autoencoders determinísticos.
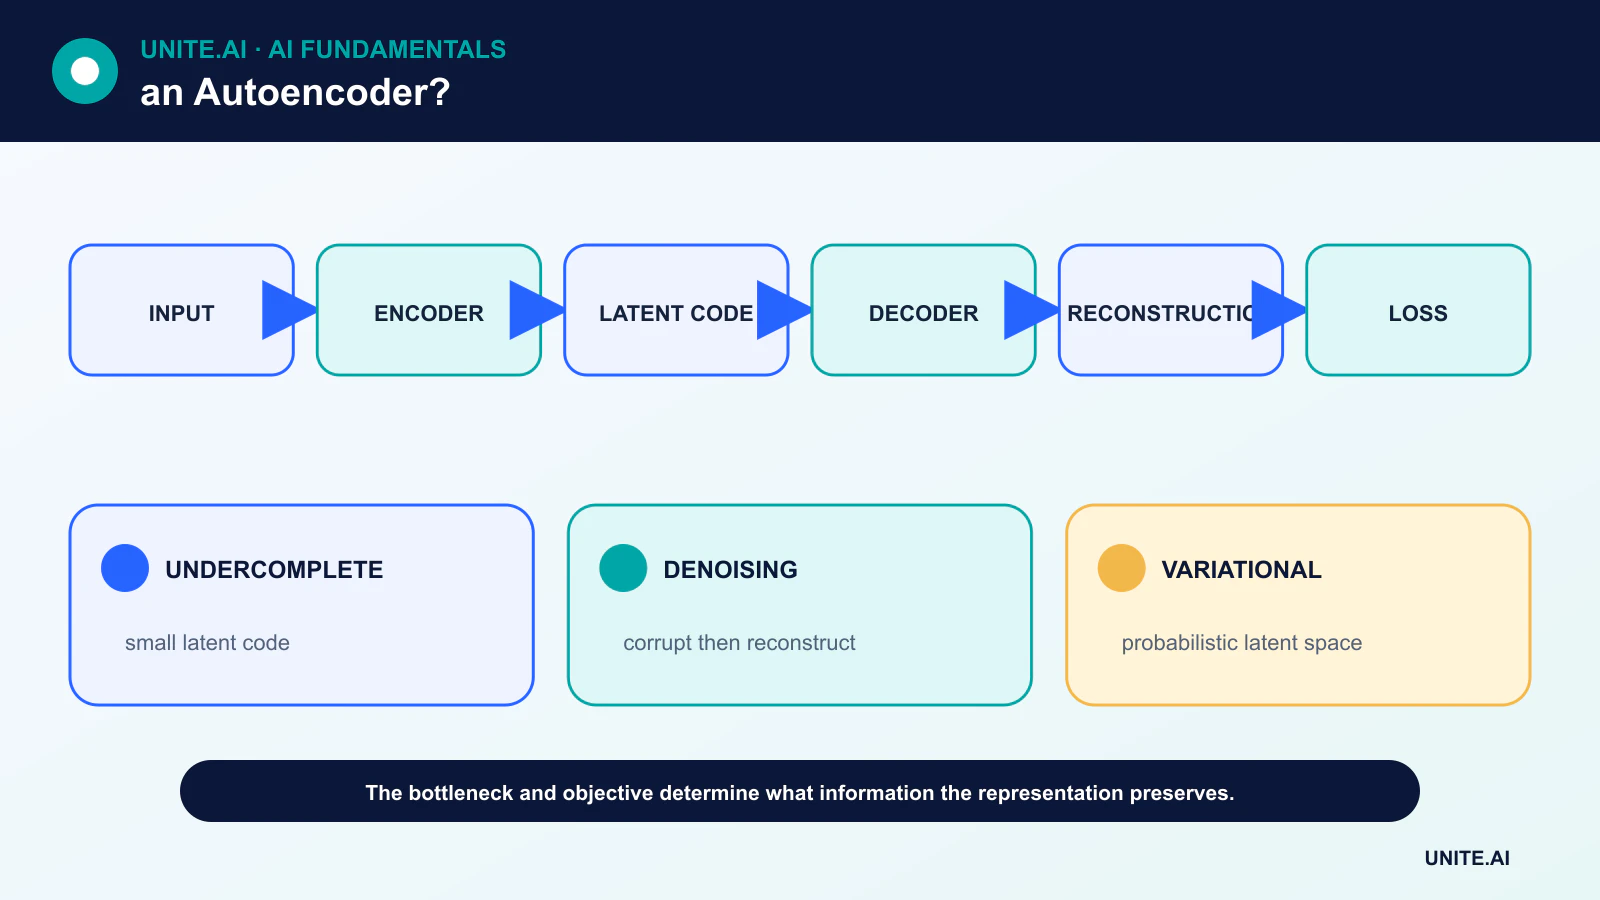
Codificador, espaço latente e decodificador
Para a entrada x, o codificador produz o código latente z = f(x) e o decodificador produz a reconstrução x̂ = g(z). A perda compara x e x̂, por exemplo usando erro quadrático médio para valores contínuos ou uma verossimilhança adequada aos dados.
A dimensão latente pode ser menor que a entrada, criando um autoencoder subcompleto. Uma rede profunda também pode aprender representações não lineares, ampliando a ideia por trás da redução de dimensionalidade.
Variantes comuns de autoencoders
Um autoencoder esparso penaliza ativações generalizadas. Um autoencoder de denoising recebe uma entrada corrompida e reconstrói a versão limpa. Um autoencoder contrativo penaliza a sensibilidade do código a pequenas mudanças na entrada.
Um autoencoder variacional (VAE) codifica parâmetros de uma distribuição de probabilidade, amostra um valor latente e equilibra a reconstrução com um termo de regularização que modela o espaço latente. Isso permite amostragem, mas altera o objetivo e a interpretação.
Treinamento e evitando soluções triviais
Autoencoders utilizam propagação reversa como outras redes neurais. Uma rede com capacidade excessiva pode memorizar exemplos de treinamento ou aprender uma função quase identidade. O tamanho do gargalo, a corrupção, as penalizações e a validação em dados não vistos o restringem.
A escolha da perda importa. Uma perda pixel a pixel pode gerar reconstruções de imagens borradas, enquanto perdas perceptuais herdam suposições de outra rede. A melhor métrica de reconstrução não é necessariamente a melhor medida de similaridade semântica.
Usos e limitações
Autoencoders podem aprender características, remover ruído de sinais, comprimir dados, inicializar modelos e produzir variáveis latentes para visualização. Para detecção de anomalias, um modelo treinado com dados normais pode atribuir erro de reconstrução maior a entradas incomuns.
Essa abordagem pode falhar quando o autoencoder também reconstrói bem as anomalias ou quando variações inofensivas são mais difíceis de reconstruir que a anomalia alvo. Os limiares precisam de dados de validação rotulados ou cuidadosamente revisados, e o erro deve ser monitorado por subgrupo e condição operacional.
Autoencoders versus outros modelos generativos
Um autoencoder determinístico não é automaticamente um modelo generativo probabilístico. VAEs definem uma distribuição latente estruturada; GANs treinam um gerador contra um discriminador; modelos de difusão aprendem um processo de denoising.
A escolha depende de se o objetivo é reconstrução, representação, verossimilhança, fidelidade da amostra, controlabilidade ou pontuação de anomalias. Um modelo menor e específico para a tarefa costuma ser mais prático do que um grande gerador de imagens.
Objetivos codificador–decodificador e representações latentes
Um autoencoder aprende um codificador que mapeia a entrada x para um código latente z e um decodificador que reconstrói x a partir de z. Se a capacidade for ilimitada, ele pode aprender um mapeamento identidade com pouca estrutura útil. Gargalos, regularização, corrupção, esparsidade ou restrições arquiteturais forçam uma representação que preserva informações selecionadas. A perda de reconstrução define o que conta como semelhante: o erro quadrático médio favorece a fidelidade média dos pixels, enquanto perdas perceptuais ou específicas de modalidade enfatizam diferentes características. Uma perda baixa não garante significado semântico.
Autoencoders subcompletos restringem a dimensão latente. Autoencoders de denoising reconstrõem dados limpos a partir de entrada corrompida. Variantes esparsas penalizam a ativação; variantes contrativas penalizam a sensibilidade. Autoencoders variacionais aprendem uma distribuição latente probabilística combinando reconstrução com um termo de divergência, permitindo amostragem, mas alterando o objetivo. Autoencoders convolucionais, sequenciais, de grafos e baseados em transformadores codificam a estrutura da modalidade. Escolha o tamanho latente e a regularização por meio de validação downstream, não apenas por gráficos bidimensionais atraentes.
Detecção de anomalias, compressão e avaliação
Para detecção de anomalias, treine com dados normais representativos e avalie o erro de reconstrução ou a verossimilhança latente, mas as anomalias às vezes podem ser bem reconstruídas e casos normais raros podem ser mal reconstruídos. Selecione limiares em casos de validação rotulados ou revisados, relate recall em nível de evento e falsos alarmes, e teste mudanças no estado operacional. Compare com linhas de base estatísticas simples e de classe única. Para compressão, contabilize o codec completo — incluindo tamanho do modelo, quantização, metadados e computação de decodificação — e compare a qualidade em taxa de bits equivalente com codecs estabelecidos.
A qualidade da representação pode ser avaliada por meio de sondas lineares, estabilidade de agrupamento, recuperação, reconstrução e tarefas downstream, cada uma respondendo a uma pergunta diferente. Evite vazamento ao aprender o codificador e ao selecionar limiares. Inspecione quais características a perda ignora e se atributos sensíveis permanecem codificados. Um latente comprimido não é automaticamente anonimizado; inversão e inferência de atributos podem recuperar informações privadas. Reconstruções geradas também podem parecer plausíveis enquanto alteram detalhes críticos.
Implantação e monitoramento
Versione o codificador e o decodificador juntos, valide alterações numéricas após a exportação e preserve a escala de entrada. Monitore a distribuição da reconstrução, deriva latente, alertas de limiar e resultados confirmados. No monitoramento industrial, condicione o modelo ao modo operacional para que transições normais não sejam tratadas como falhas. Para reconstrução médica ou científica, nunca apresente um detalhe gerado como evidência medida sem validação e procedência. Autoencoders são aprendizes de representação flexíveis, mas as restrições e a perda — não o nome da arquitetura — determinam quais informações são retidas, descartadas ou fabricadas.
Exemplo prático: um autoencoder para anomalias em bombas
Um autoencoder subcompleto aprende janelas de vibração a partir de operações de bombas saudáveis verificadas, abrangendo diferentes cargas e temperaturas. Ele é comparado com limiares estatísticos e métodos de classe única, e seu limiar de reconstrução é selecionado em transições normais revisadas e falhas conhecidas. A avaliação usa recall de eventos, tempo de antecedência de aviso, falsos alertas por hora de operação e resultados por bomba, não janelas aleatórias que colocam amostras adjacentes em treinamento e teste.
O modelo de produção condiciona-se ao estado operacional e expõe padrões residuais aos engenheiros. Um erro alto solicita inspeção; ele não diagnostica a peça nem interrompe a bomba automaticamente. Desconexão de sensor, recorte e carga não vista produzem estados explicitamente inválidos. O monitoramento acompanha a distribuição da reconstrução, a confirmação de alertas e a saúde dos sensores. Quando a manutenção ou mudanças de hardware alteram a linha de base, o modelo antigo permanece disponível enquanto um candidato é treinado com dados revisados e testado contra incidentes históricos.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais que uma demonstração bem‑sucedida. Defina os usuários pretendidos, o ambiente operacional, entradas, saídas, dependências, responsável e as consequências de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa junto com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre toda transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e aposentadoria. Use um lançamento em fases, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, o comportamento da saída, a versão do modelo ou regra, a saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, então revise evidências do mundo real após a implantação em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
Os autoencoders são compressão sem perdas?
Não, geralmente. Eles costumam aprender representações com perdas específicas da tarefa e da distribuição e exigem que o decodificador treinado reconstrua os dados.
Todo gargalo é interpretável?
Não. Um código compacto pode ser útil sem que cada dimensão corresponda a um conceito legível por humanos.
Referências principais












