
Fundamentos de IA
O que é o agrupamento K-Means?

 Adicione Unite.AI às suas fontes preferidas no Google
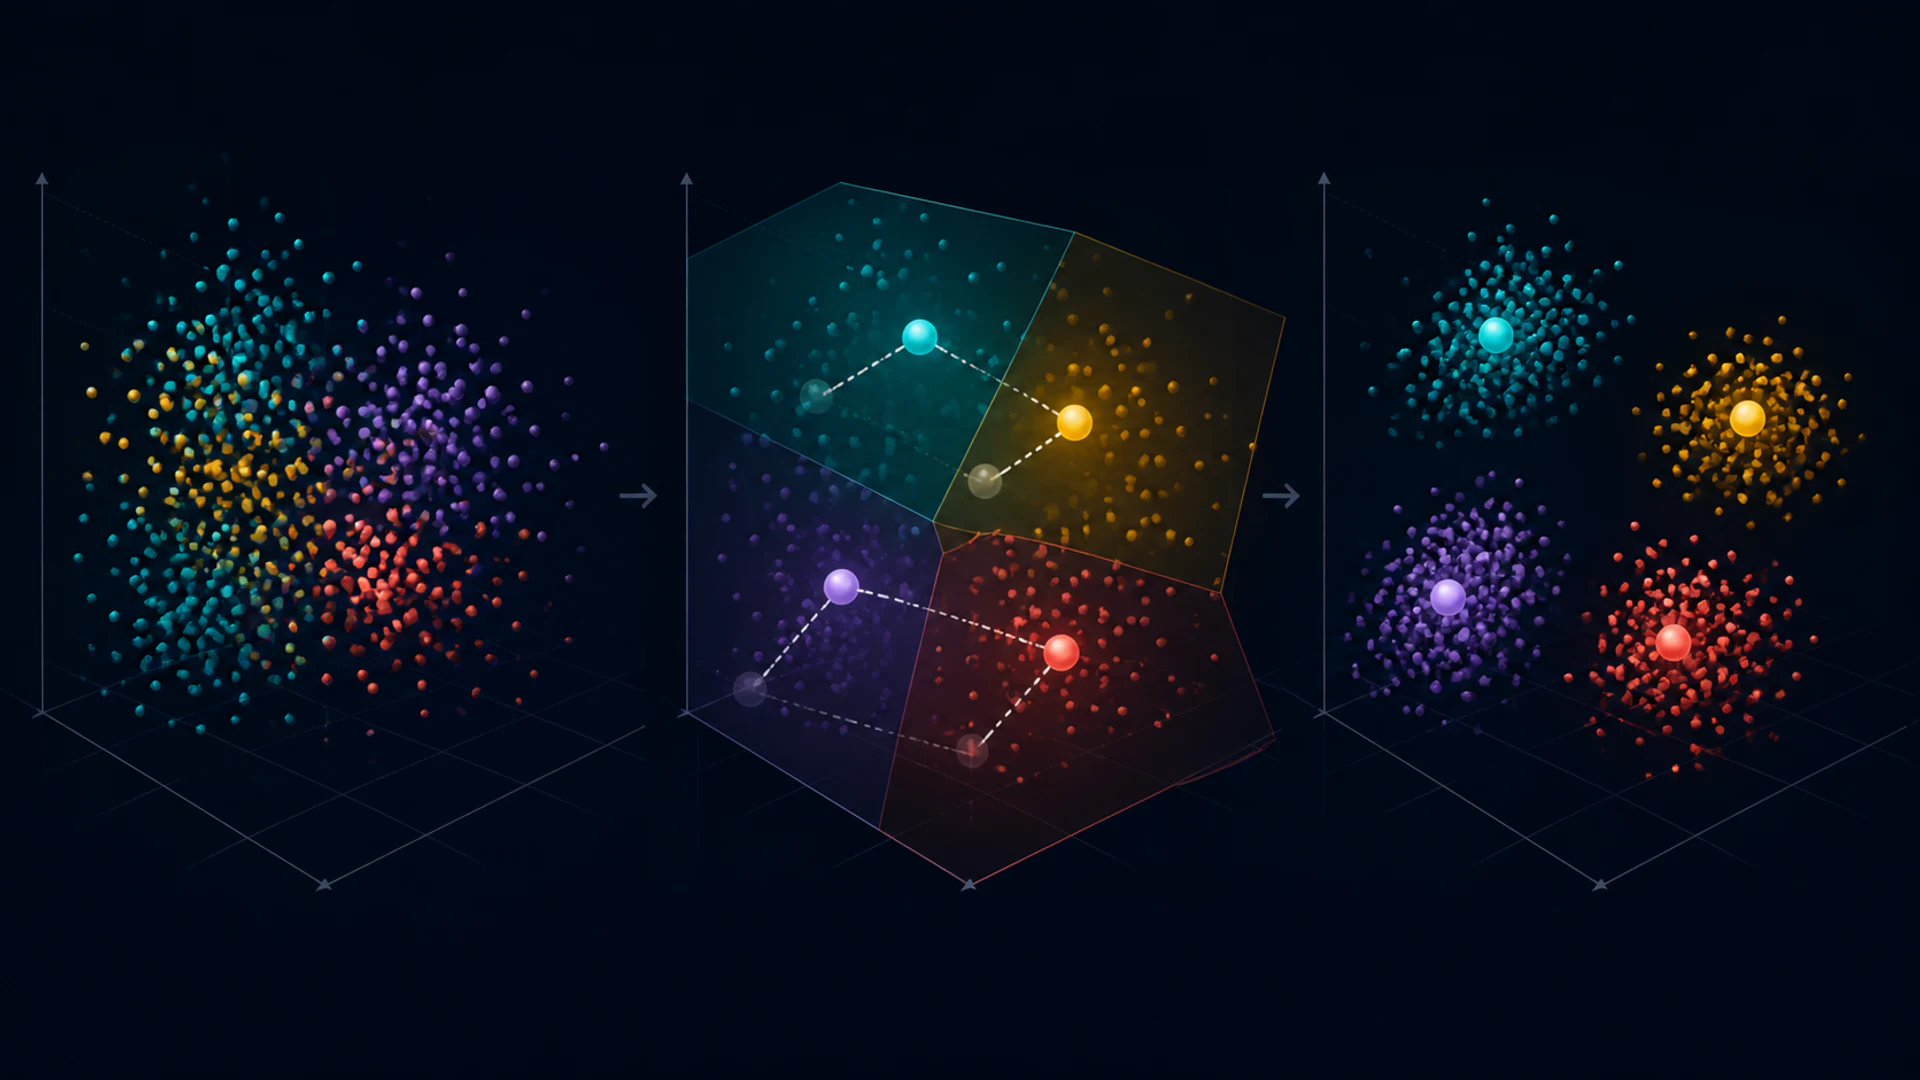
K-means é um algoritmo não supervisionado que particiona observações numéricas em k clusters. Ele alterna entre atribuir cada ponto ao seu centróide mais próximo e recalcular cada centróide como a média dos pontos atribuídos.
O algoritmo é rápido e útil, mas seu resultado é influenciado por escala, distância, inicialização e o k escolhido. Um cluster é uma partição matemática, não automaticamente uma categoria do mundo real.
Principais conclusões
- K-means minimiza a distância euclidiana quadrada dentro do cluster em relação aos centróides.
- A inicialização é importante; k-means++ distribui os centróides iniciais e geralmente melhora os resultados.
- Padronize as características quando suas unidades ou escalas devem contribuir de forma comparável.
- K-means tem dificuldades com outliers, clusters não esféricos, densidades desiguais e dados categóricos.
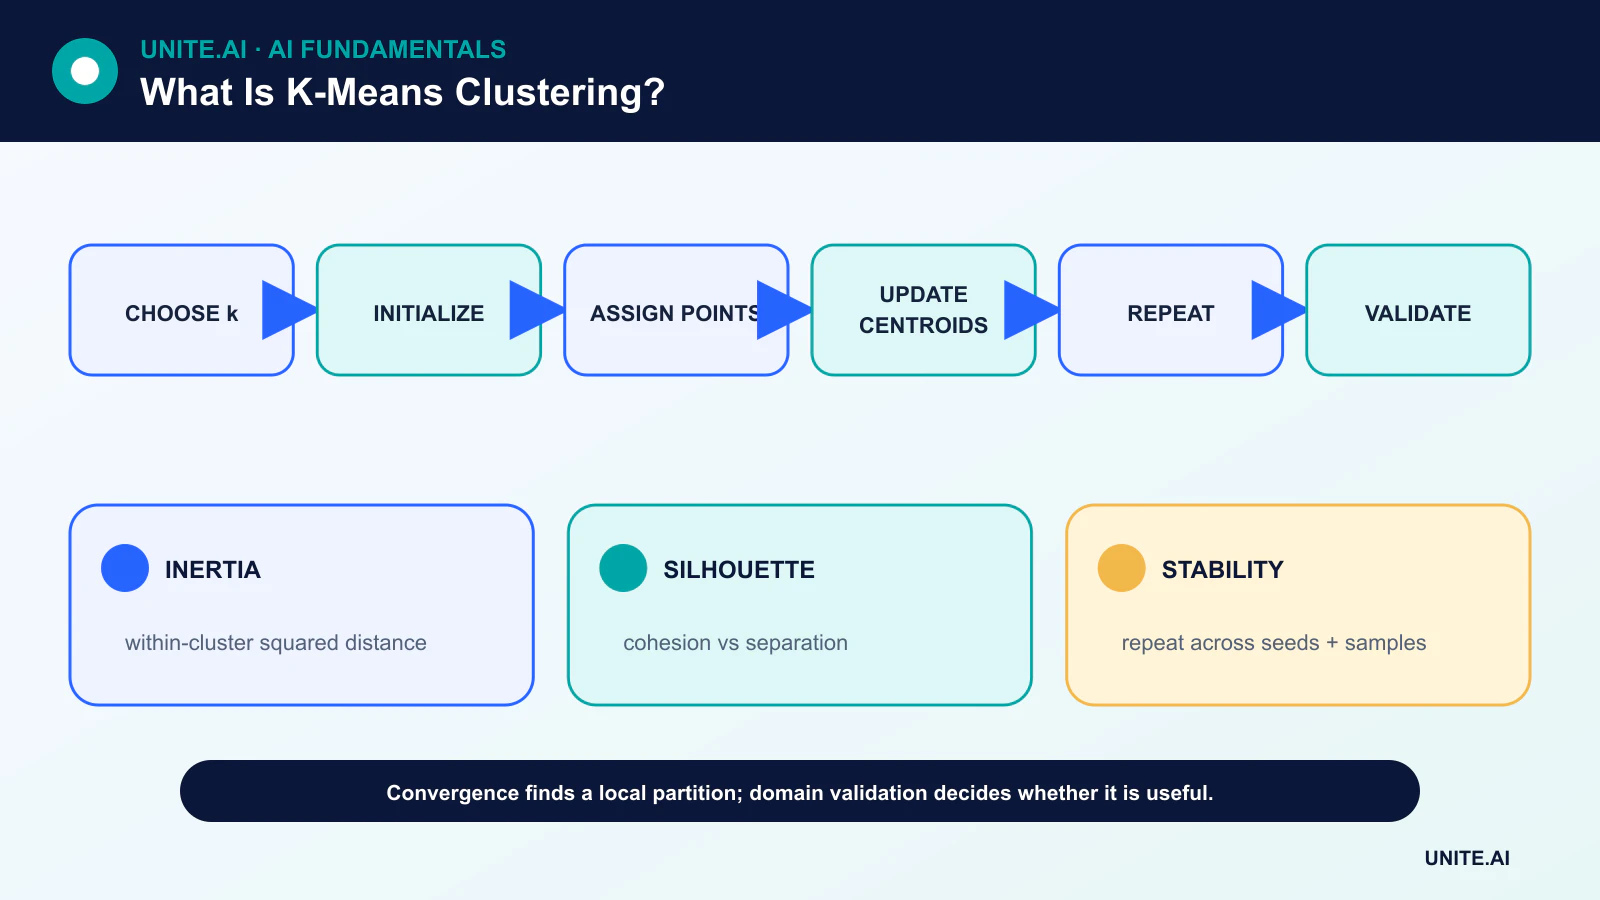
O objetivo e o ciclo de atualização
Dados k centróides, a etapa de atribuição envia cada observação para o mais próximo. A etapa de atualização substitui cada centróide pela média das observações atribuídas a ele. A soma dos quadrados dentro do cluster não pode aumentar com essas etapas, portanto o processo converge para um ótimo local.
A convergência não garante o ótimo global. Diferentes centróides iniciais podem gerar partições diferentes, por isso as implementações executam várias inicializações e mantêm a solução com a menor inércia.
Inicialização e k-means++
Selecionar aleatoriamente todos os centróides iniciais a partir de uma única região densa pode gerar uma solução ruim ou convergência lenta. O k-means++ escolhe sementes com probabilidade relacionada à distância das sementes já existentes, incentivando a cobertura do conjunto de dados.
Execuções múltiplas continuam úteis. Registre a semente aleatória e o número de inicializações para que os resultados possam ser reproduzidos.
Escala e distância
A distância euclidiana quadrada torna o K-means sensível às unidades. Uma característica medida em milhares pode dominar outra medida entre zero e um. A padronização é comum, mas o conhecimento de domínio deve decidir se variância padronizada igual reflete importância igual.
Outliers podem afastar a média dos pontos típicos. Escala robusta, truncamento ou métodos baseados em medóides podem ser melhores. Características categóricas codificadas em one-hot criam uma geometria de distância que pode não corresponder à similaridade das categorias.
Escolhendo k e validando clusters
A inércia diminui sempre que k aumenta, portanto não pode selecionar k sozinho. A heurística do cotovelo procura por melhorias decrescentes. A análise de silhueta compara coesão e separação. A estabilidade entre amostras e sementes adiciona outra verificação.
A validação mais forte é a utilidade para o domínio pretendido. Compare os clusters com resultados conhecidos, revisão de especialistas ou uma tarefa subsequente sem fingir que rótulos pós-hoc foram descobertos objetivamente.
Limitações e alternativas
K-means favorece grupos compactos, aproximadamente esféricos e de escala similar. Modelos de mistura gaussiana representam componentes elipsoidais probabilísticos; métodos estilo DBSCAN identificam regiões densas e ruído; o agrupamento hierárquico produz uma árvore de fusões.
Redução de dimensionalidade pode melhorar a velocidade ou remover ruído dos inputs, mas ajustá-la no conjunto de dados completo pode mudar a questão de validação. O Mini-batch K-means reduz o cálculo para grandes conjuntos de dados ao custo de uma atualização aproximada.
Objetivo, inicialização e convergência
K-means particiona observações numéricas em k clusters minimizando a distância euclidiana quadrada dentro do cluster em relação aos centróides. O algoritmo de Lloyd alterna a atribuição de cada ponto ao centróide mais próximo e o recálculo dos centróides até que as atribuições ou o objetivo se estabilizem. Ele converge para um ótimo local, não necessariamente o melhor global. A inicialização k-means++ espalha os centros iniciais e geralmente melhora os resultados, mas múltiplas sementes continuam importantes. Padronize as características quando as unidades devem contribuir de forma comparável, pois a distância quadrada amplifica variáveis de grande escala e outliers.
O método assume clusters aproximadamente compactos, esféricos e de escala semelhante sob geometria euclidiana. Ele tem dificuldades com variedades alongadas, densidade desigual, dados categóricos, outliers intensos e estruturas aninhadas. Clusters vazios e pontos duplicados precisam de tratamento definido. O mini-batch k-means escala para grandes volumes de dados com um compromisso de aproximação. Para texto esparso, o k-means esférico orientado por cosseno pode combinar melhor a direção, enquanto misturas, métodos de densidade, agrupamento hierárquico ou k-medoids codificam outras suposições.
Escolhendo k e validando o significado
Curvas de cotovelo, pontuações de silhueta, critérios de informação em modelos relacionados e estabilidade podem orientar a escolha de k, mas nenhum descobre um número unicamente correto. A utilidade para o negócio e a interpretação de domínio são importantes. Reajuste em diferentes amostras e sementes, compare o movimento dos centróides e a consistência das atribuições, e valide os clusters em resultados independentes que não foram usados para formá-los. Uma projeção bidimensional pode distorcer a separação, portanto examine distâncias e exemplos no espaço de representação original ou validado.
Clusters são grupos descritivos criados pelas características e métrica selecionadas; não são categorias naturais ou segmentos causais. Perfis baseados nas mesmas variáveis usadas para o agrupamento podem ser circulares. Use atributos reservados e revisão qualitativa, e verifique se os clusters reproduzem principalmente geografia, fonte de dados ou atributos sensíveis. Clusters pequenos podem ser anomalias ou artefatos. Nomear um cluster não faz com que todos os membros correspondam ao rótulo.
Implantação e manutenção
Armazene a escala, a ordem das características, os centróides, a definição de distância e os rótulos dos clusters juntos. Para novos pontos, monitore a distância ao centróide atribuído e a fração que está muito além do suporte de treinamento; forneça um estado desconhecido em vez de forçar cada caso a um cluster. Acompanhe o tamanho dos clusters, os centróides e a relevância dos resultados ao longo do tempo. O re-treinamento altera as identidades dos clusters, portanto mapeie ou versione as regras subsequentes em vez de reutilizar silenciosamente nomes antigos. O K-means é uma base útil de compressão e segmentação quando sua geometria corresponde à questão, não um motor de descoberta universal.
Exemplo prático: segmentação de clientes com k-means
Uma empresa de assinatura padroniza as características de uso em uma janela fixa, remove identificadores de conta e testa k em diferentes sementes. Estabilidade, silhueta e resultados de negócios reservados são revisados, mas as equipes de produto também inspecionam contas representativas e de fronteira. Elas descobrem que um cluster consiste simplesmente em novos clientes com observação mais curta, portanto a permanência é tratada explicitamente. O K-means é comparado com alternativas hierárquicas e baseadas em densidade ao invés de ser assumido como apropriado. O exercício é tratado como aprendizado não supervisionado, não descoberta de rótulos.
Os segmentos orientam pesquisas e experimentos de mensagens, não elegibilidade ou preço. Novas contas distantes de todos os centróides recebem uma atribuição desconhecida. Escala, características, centróides e nomes são versionados, e o re-treinamento mapeia novos clusters para os antigos apenas com evidência. O monitoramento acompanha o tamanho do cluster, a distância e a relevância dos resultados. Atributos sensíveis e proxies são auditados, e a equipe evita descrever os clusters como tipos de personalidade naturais quando são partições matemáticas de comportamentos selecionados.
Evidência de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem-sucedida. Defina os usuários pretendidos, o ambiente operacional, entradas, saídas, dependências, proprietário e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entrada malformada ou ausente, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, mudanças, reversão e aposentadoria. Use um lançamento em fases, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, o comportamento da saída, a versão do modelo ou regra, a saúde das dependências, intervenções humanas e os resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
O K-means é supervisionado ou não supervisionado?
É não supervisionado porque recebe características e um número escolhido de clusters, não rótulos alvo.
O K-means classifica novos dados?
Após o ajuste, um novo ponto pode ser atribuído ao seu centróide mais próximo. Isso é atribuição a um cluster, não necessariamente predição de classe supervisionada.
Referências principais












