Fundamentos de IA
O que é Ciência de Dados?

 Adicione Unite.AI às suas fontes preferidas no Google
Ciência de dados é a prática de transformar dados em conhecimento defensável, previsões ou decisões. Ela combina expertise de domínio, estatística, computação, engenharia de dados, visualização e comunicação. Um modelo pode fazer parte do trabalho, mas a disciplina começa antes da modelagem e continua após a implantação.
A pergunta mais importante não é “Qual algoritmo devemos usar?”. É “Qual decisão estamos apoiando, que evidência a responderia, e como saberemos que o resultado continua útil?”
Principais pontos
- Ciência de dados é um fluxo de trabalho de evidência de ponta a ponta, não sinônimo de aprendizado de máquina.
- Definição do problema, medição e governança de dados frequentemente determinam o sucesso mais do que a complexidade do modelo.
- Perguntas preditivas e causais exigem suposições e projetos de avaliação diferentes.
- Uma análise implantada necessita de monitoramento, documentação e comunicação adequados aos seus usuários.
Comece com uma decisão e um estimando
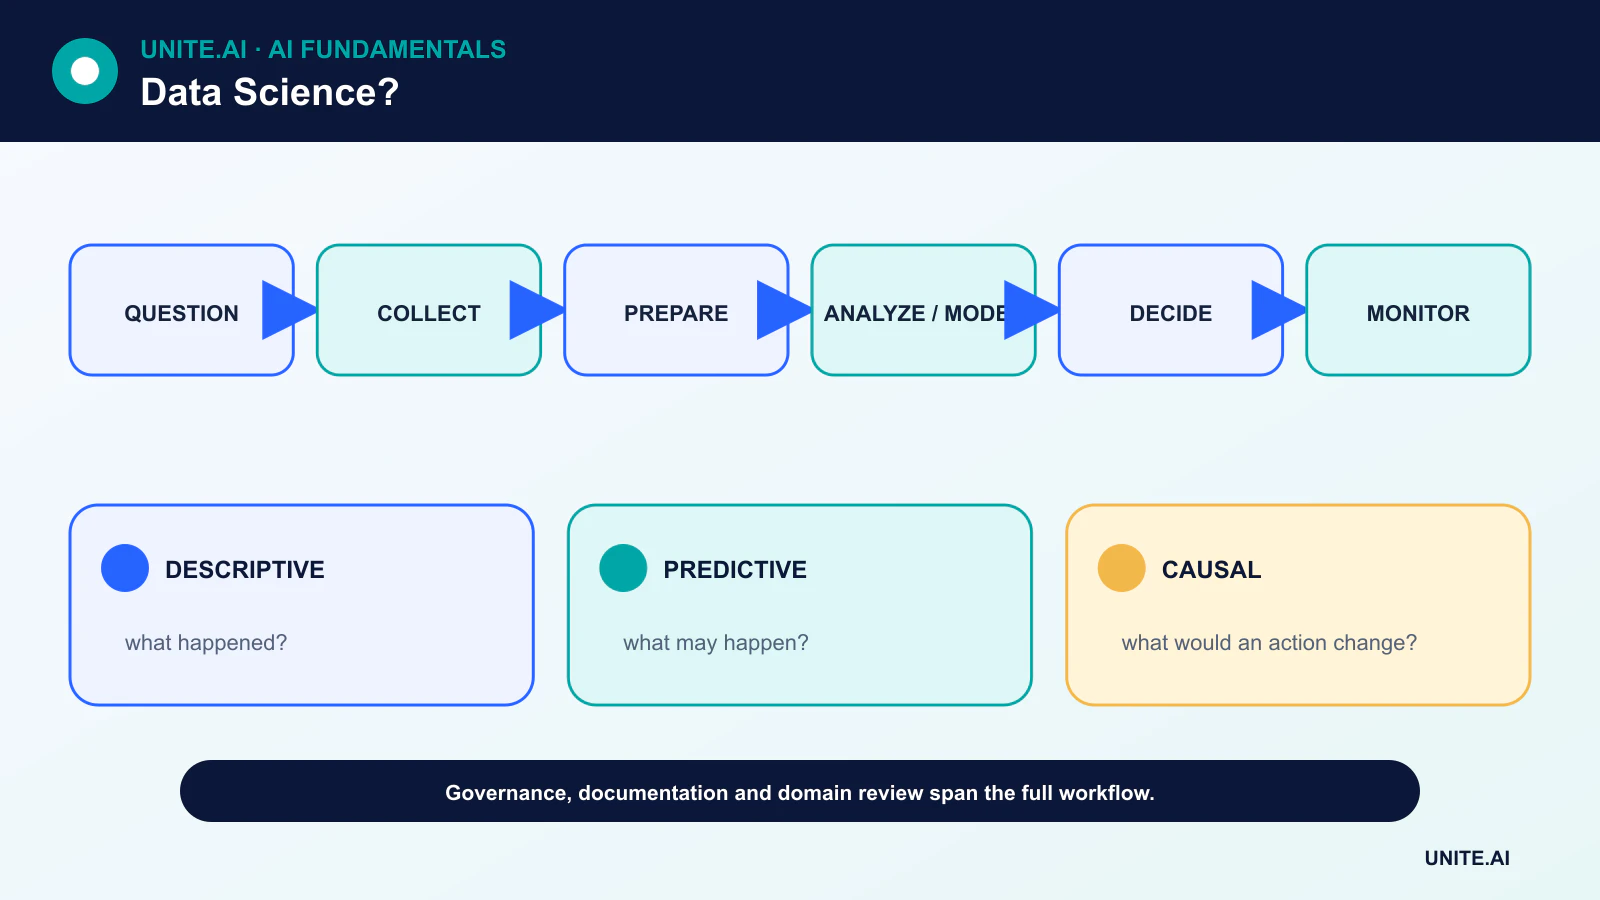
Um projeto deve identificar o usuário, a decisão, a intervenção e o custo do erro. Para uma pergunta descritiva, o alvo pode ser uma taxa ou tendência. Para previsão, pode ser demanda futura ou risco. Para uma pergunta causal, o estimando descreve o efeito de uma intervenção definida sob as suposições declaradas.
Metas vagas, como “encontrar insights”, tornam a avaliação impossível. Um objetivo mensurável cria um limite para a coleta de dados e impede que a análise se expanda para todos os campos disponíveis.
Coletar, governar e entender os dados
As equipes inventariam fontes, propriedade, consentimento, retenção, linhagem e acesso. Elas distinguem dados estruturados e não estruturados, definem unidades e carimbos de tempo, e examinam se os registros representam a população e o período de tempo de interesse.
Limpeza não é apenas excluir linhas ausentes. Inclui a resolução de duplicatas, valores impossíveis, ambiguidade de rótulos, deriva de esquema, censura e junções que mudam a unidade de análise. Cada transformação deve ser reproduzível e documentada.
Explorar antes de modelar
A análise exploratória estuda distribuições, ausências, relacionamentos e possíveis artefatos de medição. Visualizações podem revelar valores atípicos e diferenças de subgrupos que uma média resumida oculta. A exploração deve informar hipóteses sem ser confundida com evidência confirmatória.
Engenharia de atributos, redução de dimensionalidade e aprendizado de representação podem melhorar a modelagem, mas as transformações devem ser ajustadas apenas nos dados de treinamento para evitar vazamento.
Escolha métodos adequados à pergunta
A estimação estatística quantifica a incerteza em torno das quantidades de interesse. Aprendizado de máquina é útil quando o objetivo principal é desempenho preditivo em novos dados. Experimentos e métodos de inferência causal são necessários quando o objetivo é o efeito de uma intervenção.
Uma linha de base deve ser simples o suficiente para ser compreendida. Modelos mais complexos precisam justificar seu custo adicional por meio de melhor desempenho em dados de teste, incerteza calibrada, valor operacional ou uma capacidade necessária, como processamento de imagens ou linguagem.
Avaliar, comunicar e monitorar
A avaliação deve corresponder à decisão. Um classificador pode exigir precisão, recall, calibração e análise de subgrupos, em vez de apenas acurácia; um sistema de previsão necessita de backtesting sensível ao tempo. Overfitting e vazamento são falhas de processo, não apenas propriedades do modelo.
A comunicação inclui suposições, incerteza, limitações e ações recomendadas. Quando um modelo ou painel é usado, as equipes monitoram a qualidade de entrada, deriva de resultados, comportamento do usuário e impacto downstream. Um processo de decisão aposentado precisa de um arquivo e responsabilidade clara, assim como um processo implantado necessita de um operador.
O ciclo de vida da ciência de dados e perguntas analíticas
Ciência de dados combina conhecimento de domínio, estatística, computação e comunicação para transformar dados em evidência para decisões. Comece distinguindo descrição, diagnóstico, previsão e inferência causal. Um painel que relata o que aconteceu, um modelo que prevê quem vai churn, e um experimento que estima se uma intervenção altera o churn respondem a perguntas diferentes. Defina a unidade, população, janela temporal, resultado, ação e custo dos erros antes de extrair os dados. Muitos projetos fracassados resolvem um proxy mensurável que não pode sustentar a decisão pretendida.
Aquisição requer proveniência, permissões, desenho de amostragem e um contrato de dados. A exploração verifica distribuições, ausências, duplicatas, valores atípicos, relacionamentos, mudanças de medição e vazamento potencial. As escolhas de limpeza são suposições analíticas: excluir linhas ausentes, imputar valores ou limitar outliers podem mudar a população e a conclusão. Versione os dados brutos de forma imutável e as transformações como código, e crie um dicionário de dados com unidades e significado. Divida os dados de avaliação antes de aprender transformações ou testar hipóteses repetidamente.
Modelagem, inferência e reproducibilidade
A inferência estatística quantifica a incerteza sob suposições; a modelagem preditiva estima o desempenho fora da amostra; a análise causal requer identificação por meio de desenho ou suposições defensáveis. Selecione métodos que correspondam à pergunta e ao processo gerador de dados. Compare com linhas de base simples, use validação agrupada ou sensível ao tempo, e relate incerteza e sensibilidade. Uma alta correlação ou importância de atributos não estabelece causalidade. Testes múltiplos, graus de liberdade do pesquisador e relato seletivo podem criar padrões convincentes, portanto pré-registro ou uma fase confirmatória claramente separada podem ajudar.
Reproducibilidade inclui código, ambiente, instantâneo de dados, sementes aleatórias, definições de consultas e registro de decisões manuais. Testes automatizados devem cobrir esquemas, invariantes de negócio, transformações e métricas. Notebooks são valiosos para exploração, mas o trabalho de produção requer pipelines modulares e revisáveis. A revisão por pares deve desafiar suposições, vazamento, validade do alvo e se os resultados se generalizam. Comunique tamanhos de efeito, incerteza, limitações e evidências contrárias, em vez de apenas significância estatística ou pontuação de modelo.
Implantação e impacto da decisão
Se a análise impulsiona um processo recorrente, atribua responsáveis, monitore a frescura dos dados e a qualidade dos resultados, e defina rollback ou aposentamento. Proteja informações pessoais e confidenciais por meio de minimização, controle de acesso, retenção e saídas seguras. Avalie efeitos em subgrupos e como os usuários respondem ao modelo; ciclos de feedback podem mudar os dados futuros. Meça se a decisão melhorou o objetivo real, não apenas se um modelo foi implantado. Ciência de dados tem sucesso quando a evidência altera a ação de forma confiável e transparente — não quando uma organização acumula painéis, recursos ou experimentos sem responsabilidade.
Exemplo prático: medindo uma intervenção de retenção
Uma equipe de produto observa menor retenção e define um usuário ativo, coorte, janela, exclusões e decisão. Analistas auditam a instrumentação, eventos ausentes e a mistura de aquisição antes da modelagem. Cohortes descritivas identificam onde ocorre a queda, um modelo preditivo prioriza participantes da pesquisa, e um experimento randomizado de onboarding estima se a mudança proposta melhora a retenção. Estes são três análises distintas com suposições e saídas separadas.
O notebook, consultas, instantâneo de dados, definição de métrica e plano de experimento são versionados e revisados por pares. Os resultados relatam tamanho de efeito e incerteza com salvaguardas para demanda de suporte e acessibilidade. Um painel monitora o experimento, mas não substitui a análise pré‑declarada. Se a intervenção for bem‑sucedida, a implantação permanece em etapas e verifica o comportamento a longo prazo. O trabalho é considerado valioso apenas se sustenta uma decisão reproduzível, não porque um modelo complexo ou um gráfico visualmente atraente foi produzido.
Evidência de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de limite, entrada malformada ou ausente, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, rollback e aposentamento. Use um rollout em etapas, mantenha um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação, em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
A ciência de dados é a mesma que a análise de dados?
Os termos se sobrepõem. Ciência de dados frequentemente inclui a construção de produtos de dados e sistemas preditivos, enquanto a análise pode focar mais em suporte à decisão descritivo e diagnóstico. O uso organizacional varia.
Todo projeto de ciência de dados precisa de IA?
Não. Uma consulta, gráfico, experimento ou estimativa estatística bem projetados podem ser mais úteis e confiáveis que um modelo complexo.
Referências principais