Fundamentos de IA
O que é Redução de Dimensionalidade?

 Adicione Unite.AI às suas fontes preferidas no Google
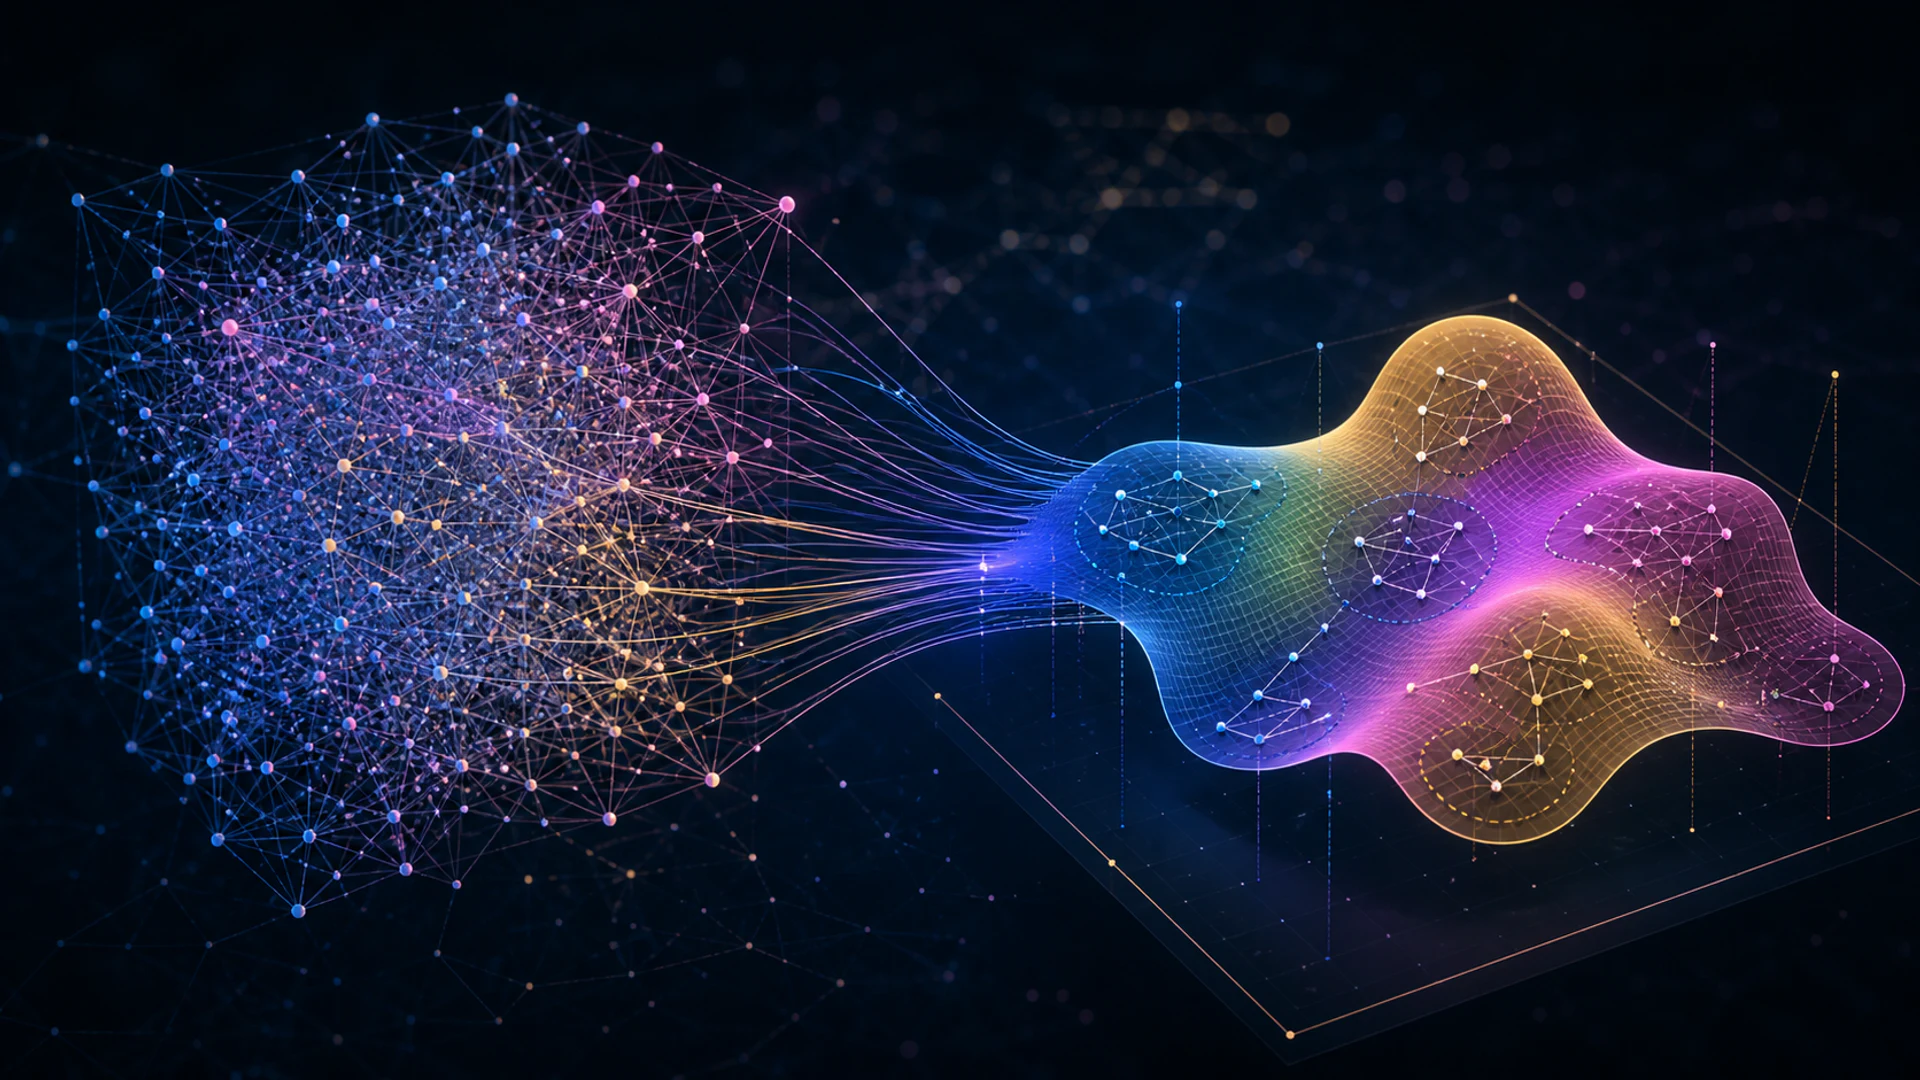
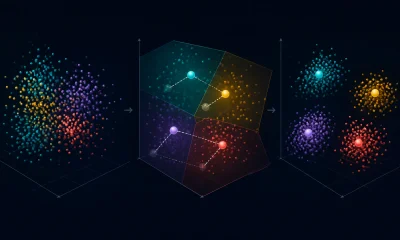
Redução de dimensionalidade representa dados com menos variáveis, preservando informações úteis para uma tarefa. Pode reduzir armazenamento e ruído, melhorar a visualização, mitigar recursos redundantes e tornar os modelos subsequentes mais fáceis de treinar.
Nenhum método preserva todas as relações. Uma redução útil começa declarando o que deve ser mantido: variância, separação de classes, vizinhanças locais, geometria global, qualidade de reconstrução ou interpretabilidade.
Principais pontos
- Seleção de atributos mantém as variáveis originais; extração de atributos cria novas coordenadas de menor dimensão.
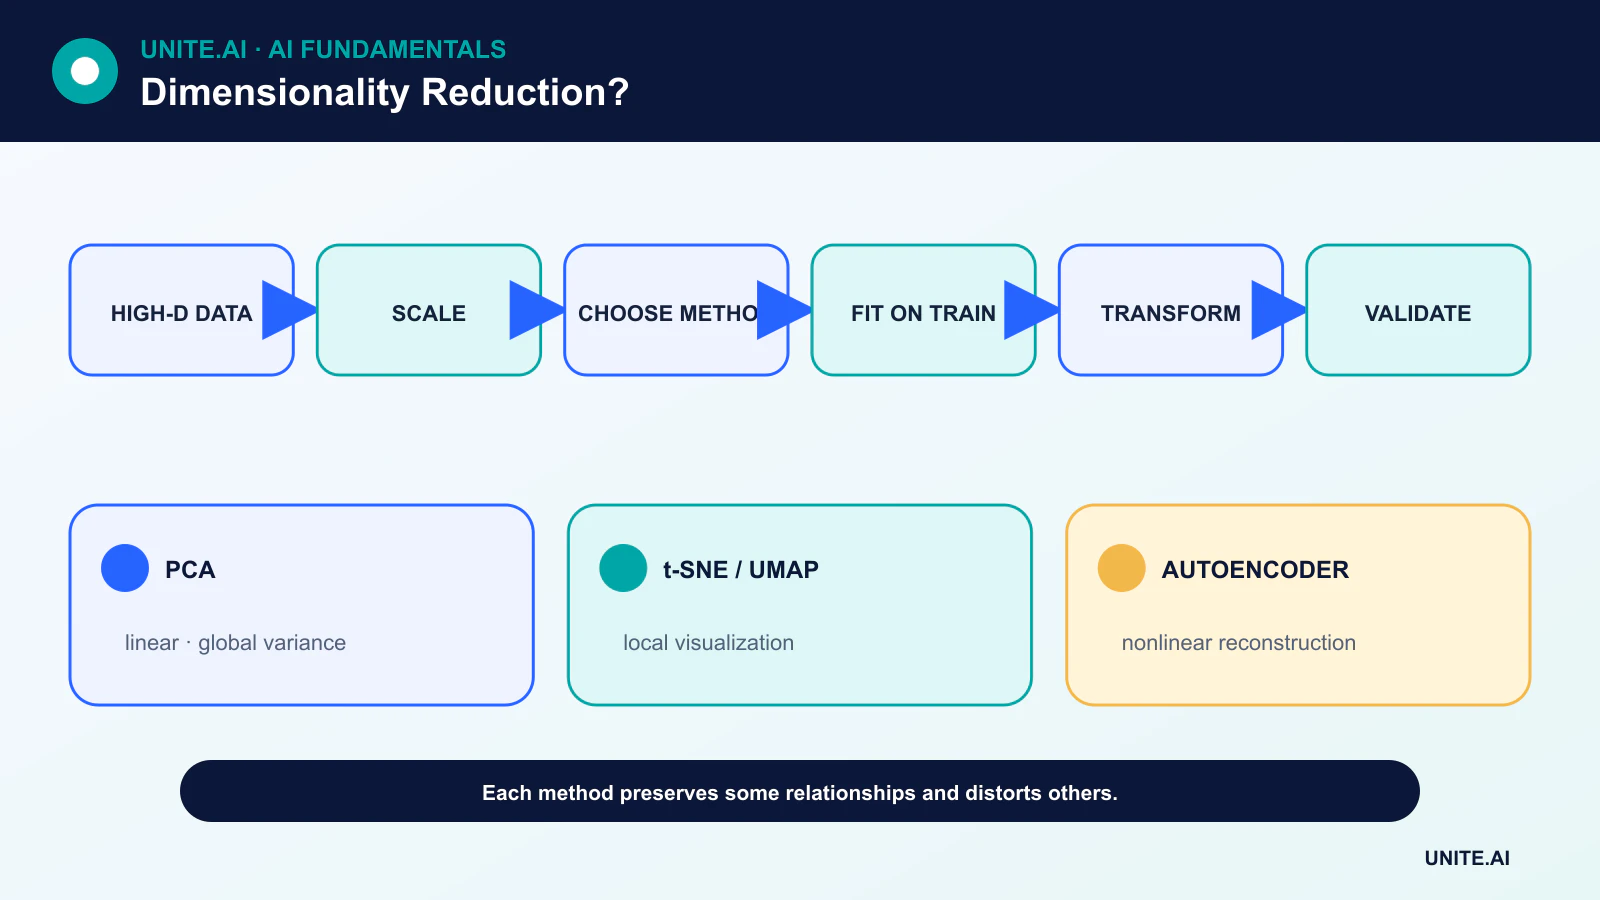
- PCA é linear e orientado à variância; t-SNE e UMAP enfatizam a estrutura de vizinhança para visualização.
- Incorporação para visualização pode distorcer distâncias, tamanhos de clusters e separação global.
- Ajuste a redução apenas nos dados de treinamento e, em seguida, aplique a transformação aprendida aos dados de validação e teste.
Seleção de atributos versus projeção
A seleção de atributos remove variáveis usando regras de domínio, ausência de dados, redundância, testes preditivos ou regularização. Preserva os significados originais, o que pode ajudar na governança e explicação.
Métodos de projeção combinam variáveis em novas coordenadas. Eles podem capturar estruturas distribuídas, mas podem tornar cada coordenada mais difícil de interpretar. Um autoencoder aprende uma projeção não linear por meio da reconstrução.
PCA e SVD
A análise de componentes principais identifica direções ortogonais de variância decrescente após centralizar os dados. A decomposição em valores singulares fornece uma rota numérica comum. A escala importa: uma unidade de medida de alta variância pode dominar os componentes.
PCA é determinística até o sinal e valores próprios repetidos, suporta transformação fora da amostra e fornece resumos de variância explicada. Alta variância nem sempre é relevante para a tarefa, e componentes lineares não podem desdobrar todas as variedades curvas.
t-SNE e UMAP
t-SNE constrói distribuições de probabilidade sobre vizinhos e otimiza um mapa de baixa dimensão que enfatiza a semelhança local. UMAP constrói um grafo de vizinhança ponderado e otimiza uma representação de menor dimensão com objetivos de estrutura local relacionados.
Ambos são ferramentas exploratórias poderosas, mas são sensíveis ao pré-processamento, métrica de distância e hiperparâmetros. Espaço vazio, área de cluster e distância entre clusters em um gráfico 2D não devem receber automaticamente uma interpretação do mundo real.
Métodos supervisionados e representações orientadas à tarefa
Análise discriminante linear usa rótulos de classe para buscar separação, tornando-a diferente da PCA não supervisionada. Aprendizado de representação neural pode otimizar objetivos de predição ou contrastivos em vez de reconstrução.
Se os rótulos orientam a redução, todo o ajuste e a sintonia devem permanecer dentro do processo de treinamento. Caso contrário, informações do conjunto de teste podem vazar para a seleção de modelo e gerar um resultado otimista.
Escolhendo e validando um método
Comece com pré-processamento e uma linha de base simples. Para compressão, meça a reconstrução ou o desempenho subsequente em diferentes dimensões. Para visualização, teste a estabilidade em diferentes sementes e hiperparâmetros e compare a preservação de vizinhança com o conhecimento de domínio.
Para produção, pergunte se o método pode transformar novos registros, como lida com valores ausentes, se muda sob re-treinamento e se os usuários precisam de explicações dos atributos originais. Overfitting pode ocorrer na etapa de redução assim como no modelo final.
Métodos de redução lineares e não lineares
Redução de dimensionalidade mapeia dados de alta dimensão para menos coordenadas enquanto preserva a estrutura selecionada. A análise de componentes principais encontra direções ortogonais de máxima variância após centralizar; a escala é necessária quando as unidades devem contribuir de forma comparável. A decomposição em valores singulares calcula a estrutura de baixa ordem relacionada e suporta matrizes esparsas. Análise discriminante linear usa rótulos para encontrar direções que separam classes. Esses métodos produzem transformações explícitas, mas variância ou separação de classes podem não preservar a informação necessária para uma tarefa subsequente.
Métodos de variedade como t‑SNE e UMAP constroem vizinhanças e otimizam um layout de baixa dimensão. São poderosos para exploração, mas distorcem distância global, densidade, tamanho de clusters e, às vezes, separação. Os resultados dependem do pré-processamento, métrica, vizinhos ou perplexidade, inicialização e semente. Um cluster atraente em duas dimensões pode surgir mesmo sem grupos discretos. Use múltiplas configurações, colore apenas por metadados que não foram usados no ajuste e valide a estrutura aparente no espaço original ou com rótulos independentes.
Seleção de atributos, incorporações e avaliação
Seleção de atributos mantém as variáveis originais por meio de filtros, wrappers ou importância baseada em modelo; aprendizado de representação cria novos atributos latentes usando autoencoders ou modelos supervisionados. Projeções aleatórias preservam distâncias aproximadamente sob certas condições e oferecem linhas de base eficientes. Escolha o método com base em compressão, visualização, redução de ruído, velocidade, armazenamento ou desempenho do modelo. Ajuste o redutor apenas nos dados de treinamento, depois transforme os conjuntos de validação e teste. Redução supervisionada deve estar aninhada dentro da validação cruzada para evitar vazamento de rótulos.
Avalie variância explicada ou reconstrução para compressão linear, confiabilidade e preservação de vizinhança para visualização, e acurácia, calibração, latência e robustez subsequentes para predição. Meça a estabilidade entre amostras e sementes. Verifique se classes raras ou grupos sensíveis são colapsados e se o mapeamento inverso é possível. Coordenadas reduzidas ainda podem conter informações privadas; um gráfico bidimensional não é anonimização. Documente a transformação, o escalador, a ordem dos atributos e as limitações.
Uso em produção
Servir requer a transformação ajustada exata e o esquema de entrada. Monitore atributos ausentes, mudança de faixa, distribuição de pontuações dos componentes, erro de reconstrução e resultados subsequentes. Se novas categorias ou sensores aparecerem, re-treine e versione todo o pipeline ao invés de acrescentar colunas silenciosamente. A redução pode melhorar o cálculo e desruir ruído de um modelo, mas também pode descartar sinais fracos importantes para eventos raros. Trate-a como uma etapa de medição aprendida cujo conteúdo retido e perdido deve ser testado contra a decisão.
Exemplo prático: reduzindo atributos de comportamento do cliente
Um analista padroniza 200 medidas comportamentais e ajusta PCA apenas nos clientes de treinamento. Validação cruzada escolhe o número de componentes com base no desempenho de churn subsequente e na estabilidade, não em um scatterplot bidimensional. As cargas são inspecionadas para fontes dominantes e ausências. PCA, seleção de atributos, projeção aleatória e um modelo regularizado não reduzido são comparados quanto à calibração, latência e resultados para segmentos de clientes raros. Amostras repetidas também testam se os componentes principais e as conclusões subsequentes permanecem estáveis.
O pipeline implantado fixa a ordem dos atributos, o escalador e os componentes e rejeita versões de esquema ausentes. O monitoramento acompanha distribuições de componentes, erro de reconstrução e resultados subsequentes. Uma visualização com clusters aparentes é usada para gerar perguntas, não para atribuir personas ao cliente. Como os componentes latentes ainda codificam comportamento, o acesso e a retenção permanecem controlados. Se as definições de origem mudarem, a transformação completa e o modelo são reconstruídos e validados ao invés de projetar dados incompatíveis em componentes antigos.
Evidências de implementação e prontidão operacional
Uma decisão de produção precisa de mais que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entrada malformada ou ausente, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa junto com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, mudanças, rollback e aposentadoria. Use um rollout em etapas, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar qualidade de entrada, comportamento de saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
A redução de dimensionalidade sempre melhora um modelo?
Não. Pode descartar informações preditivas ou complicar a interpretação. Compare com uma linha de base sem redução em dados reservados.
Clusters separados no t‑SNE provam que classes reais existem?
Não. O mapa é uma visualização otimizada das relações de vizinhança e pode criar uma separação aparente. Valide os clusters com evidências independentes.
Referências principais