
Fundamentos de IA
O que é Edge AI e Edge Computing?

 Adicione Unite.AI às suas fontes preferidas no Google
Edge computing coloca a computação perto dos dispositivos e processos físicos que geram dados. Edge AI executa inferência de aprendizado de máquina — e às vezes treinamento ou adaptação — em um sensor, telefone, veículo, gateway ou servidor local, em vez de enviar cada entrada para uma nuvem distante.
A arquitetura costuma ser um continuum, em vez de uma escolha entre borda e nuvem. Decisões imediatas podem permanecer locais, enquanto a nuvem suporta gerenciamento de frotas, análises agregadas, treinamento de modelos e armazenamento de longo prazo.
Principais pontos
- Edge AI pode reduzir latência, uso de largura de banda e transferência de dados brutos, mas não garante privacidade automaticamente.
- Limites de memória, energia, térmicos e suporte a aceleradores moldam o modelo implantável.
- Quantização, poda e destilação trocam tamanho e velocidade do modelo por precisão e robustez.
- Atualizações seguras, telemetria, reversão e diversidade de hardware são partes essenciais do sistema.
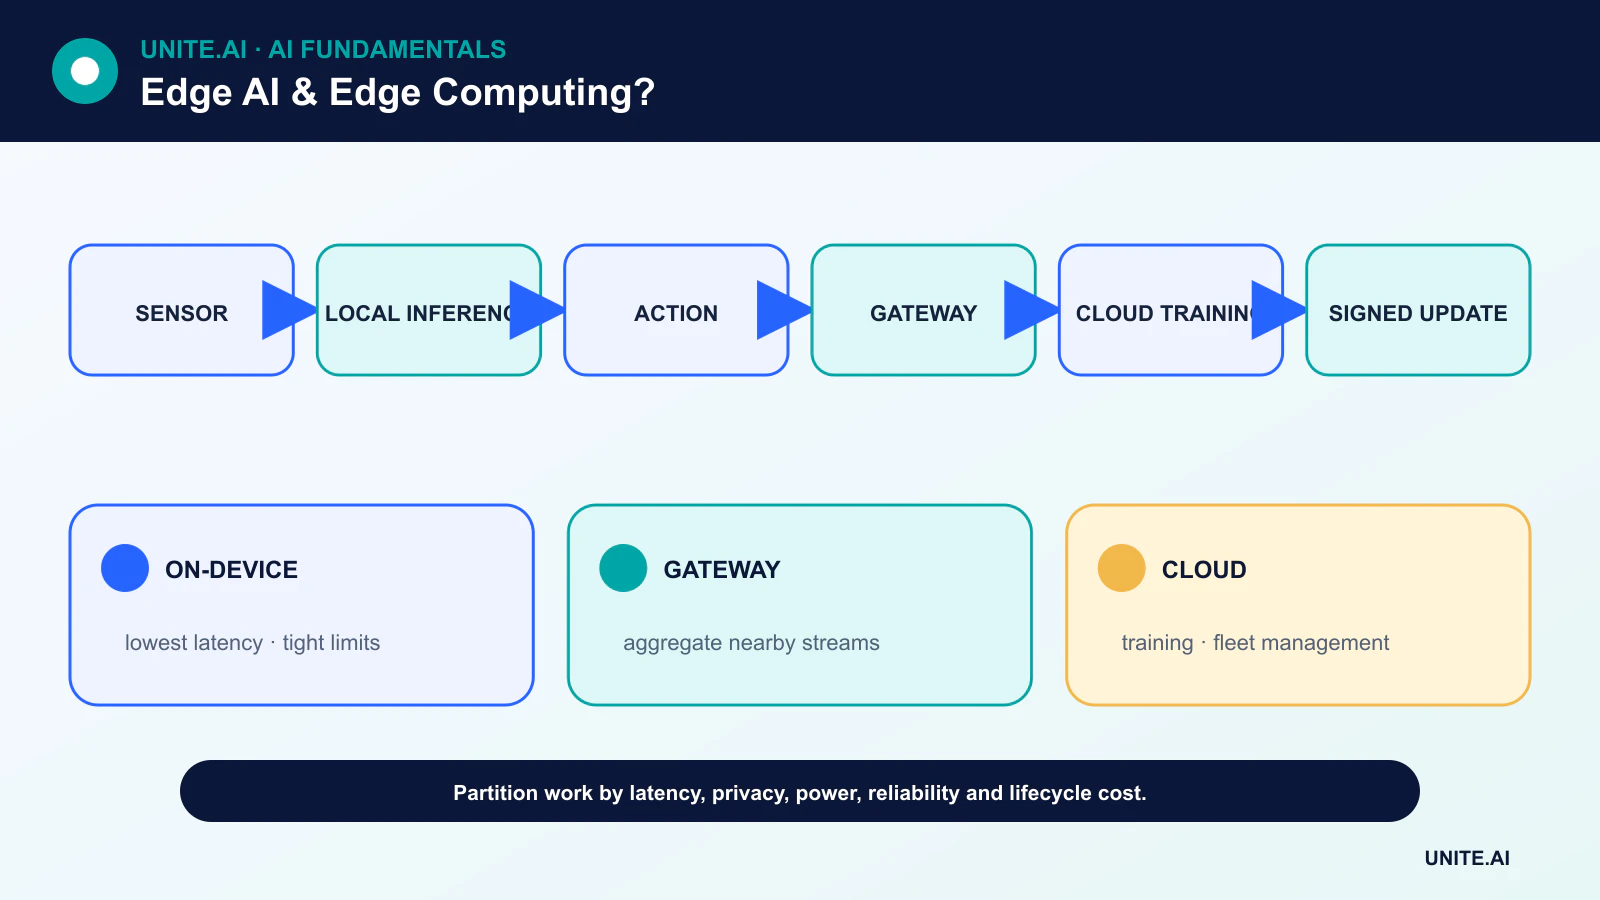
O continuum borda‑nuvem
Um sensor pode executar um modelo de limiar pequeno, um gateway próximo pode combinar vários fluxos, e um servidor regional pode realizar inferência mais pesada. A nuvem pode treinar modelos e distribuir atualizações assinadas. A partição depende de latência, conectividade, energia, sensibilidade dos dados e manutenção.
Para controle industrial, milissegundos e operação offline podem justificar inferência local. Para uma previsão empresarial de baixa frequência, a computação centralizada pode ser mais simples e observável.
Restrições de hardware e modelo
Dispositivos de borda variam de microcontroladores com kilobytes de memória a telefones e servidores com NPUs ou GPUs. O modelo deve caber no armazenamento e na RAM, atender a prazos em tempo real, permanecer dentro dos limites térmicos e usar operadores suportados.
A avaliação de desempenho deve incluir pré-processamento, movimentação de dados e custo de ativação — não apenas a taxa de processamento do kernel. O tamanho de lote costuma ser um, e o desempenho sustentado pode diferir de uma execução curta de laboratório.
Compressão e otimização
Quantização representa pesos e ativações com menor precisão. Poda remove parâmetros ou estruturas. Destilação de conhecimento treina um estudante menor para imitar um professor maior. Fusão de operadores e planejamento de memória podem reduzir ainda mais a latência.
Compressão pode alterar a precisão, calibração e desempenho de subgrupos. As equipes devem validar o artefato convertido no hardware de destino, em vez de assumir que as métricas do modelo original em ponto flutuante ainda se aplicam.
Privacidade, aprendizado federado e segurança
Inferência local pode manter áudio bruto, imagens ou registros de sensores no dispositivo, mas metadados, embeddings e telemetria ainda podem ser sensíveis. Aprendizado federado pode coordenar treinamento distribuído, com seus próprios riscos de privacidade e envenenamento.
Frotas de borda ampliam a superfície de ataque. Inicialização segura, modelos assinados, serviços de menor privilégio, comunicação criptografada e atualizações oportunas fazem parte do design de cibersegurança. Deve‑se assumir acesso físico e dispositivos desatualizados de longa vida.
Monitoramento e operações de frota
Um modelo local ainda precisa de observabilidade. Os dispositivos podem relatar métricas agregadas que preservam a privacidade, versão, saúde, latência e taxas de rejeição. Amostrar entradas selecionadas para revisão requer consentimento explícito e controles de retenção.
Implantações devem usar grupos canário e reversão automática. O sistema deve lidar com hardware incompatível, atualizações interrompidas e deriva de modelo. Um dispositivo que não pode receber correções de segurança pode precisar ser removido do serviço.
Arquitetura de borda e alocação de carga de trabalho
Computação de borda processa dados perto de sua origem — em um sensor, dispositivo, gateway, veículo, ponto de varejo ou servidor local — em vez de depender totalmente de uma nuvem distante. Edge AI coloca a inferência de modelo ou, às vezes, treinamento nesse ambiente. A alocação deve seguir requisitos de latência, conectividade, largura de banda, privacidade, resiliência, energia e gerenciamento. Um design híbrido pode realizar detecção imediata localmente, enviar eventos selecionados para um sistema regional e usar a nuvem para análises de frota e treinamento de modelo.
O hardware varia de microcontroladores e NPUs a GPUs e servidores robustos. Os modelos são exportados, quantizados, podados, destilados ou compilados para os operadores e memória disponíveis. Pré-processamento e I/O de sensores podem dominar a latência, enquanto calor ou limites de bateria afetam a taxa sustentada. Avalie o pipeline completo no dispositivo exato sob concorrência, temperatura e modos de energia realistas. Um número de TOPS destacado não revela fallback de operadores, transferências de memória ou a precisão implantada.
Segurança da frota, atualizações e observabilidade
Dispositivos distribuídos ampliam a superfície de ataque e podem ser fisicamente acessíveis. Use inicialização segura, firmware e modelos assinados, identidade baseada em hardware quando possível, comunicação criptografada, menor privilégio, segmentação de rede e segredos protegidos. Atualizações precisam de implantação em fases, verificações de compatibilidade, política anti‑rollback quando apropriada, recuperação de atualização interrompida e uma imagem conhecida como boa. Inventarie versões de dispositivo, sensor, firmware, runtime e modelo para que um incidente seja rapidamente delimitado.
A conectividade é intermitente, portanto armazene dados em buffer com capacidade limitada, sequencie eventos, torne tentativas de novo idempotentes e defina comportamento offline. A observabilidade deve capturar saúde, latência, energia, resumos de entrada, previsões, confiança e resultados confirmados sem transmitir dados brutos desnecessários. Deriva de relógio, falha de sensor e exaustão de armazenamento local podem invalidar resultados. Comandos remotos e canais de depuração exigem autorização mais robusta, pois podem se tornar caminhos de controle para toda a frota.
Implantação responsável
O processamento local pode reduzir a transferência, mas não protege a privacidade automaticamente; entradas brutas, embeddings e logs ainda podem permanecer no dispositivo ou sincronizar depois. Minimize a retenção e divulgue a dependência da nuvem. Teste a deriva do modelo em diferentes locais e condições ambientais, com um padrão seguro quando a confiança ou a saúde do sensor se deterioram. Edge AI é valioso quando as restrições locais são reais, mas transfere a responsabilidade pelo ciclo de vida, segurança e qualidade para uma grande frota heterogênea que deve ser projetada e mantida como um único sistema.
Exemplo prático: Edge AI para uma câmera de segurança remota
Um local remoto detecta se um portão restrito está aberto enquanto máquinas operam. O dispositivo de borda processa o vídeo localmente para baixa latência e transmite apenas eventos e miniaturas permitidas. Os dados abrangem clima, iluminação noturna, sujeira, vibração e cenas vazias. O modelo é quantizado e avaliado de ponta a ponta no dispositivo alvo para detecção, falsos alarmes, latência, energia e comportamento térmico sustentado.
Inicialização segura, atualizações assinadas, identidade do dispositivo e rede segmentada protegem a frota. Obstrução da câmera, exaustão de armazenamento, deriva de relógio, perda de rede e tempo limite do modelo geram alarmes de saúde e uma regra de equipamento seguro independente da IA. Atualizações são implantadas para um pequeno grupo com reversão automática. O monitoramento coleta dados mínimos de saúde e resultados, e a equipe local pode inspecionar e substituir. Inferência local reduz a transferência, mas não elimina obrigações de privacidade, retenção ou segurança física.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, proprietário e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e aposentadoria. Use uma implantação em fases, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, depois analise evidências do mundo real após a implantação, em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
Edge AI é sempre mais rápido que IA na nuvem?
Não. Inferência local evita o atraso da rede, mas pode ser executada em hardware mais fraco. O pipeline completo e os requisitos de confiabilidade determinam a latência.
Edge AI pode funcionar sem acesso à internet?
Sim, se o modelo, o pré‑processamento e a lógica de decisão forem locais. Atualizações, sincronização ou recursos dependentes da nuvem podem ficar indisponíveis.
Referências principais












