
Fundamentos de IA
O que é Aprendizado em Conjunto?

 Adicione Unite.AI às suas fontes preferidas no Google
Aprendizado em conjunto combina previsões de múltiplos modelos. A ideia central é que modelos com erros diferentes podem gerar um resultado mais preciso ou estável quando suas saídas são médias, votadas ou enviadas a um meta‑aprendedor.
Adicionar modelos não basta. Se cada membro aprender o mesmo atalho, seus erros ficarão correlacionados e o conjunto pode simplesmente ficar mais confiante no mesmo equívoco.
Principais pontos
- Conjuntos funcionam melhor quando os modelos membros são individualmente úteis e cometem erros significativamente diferentes.
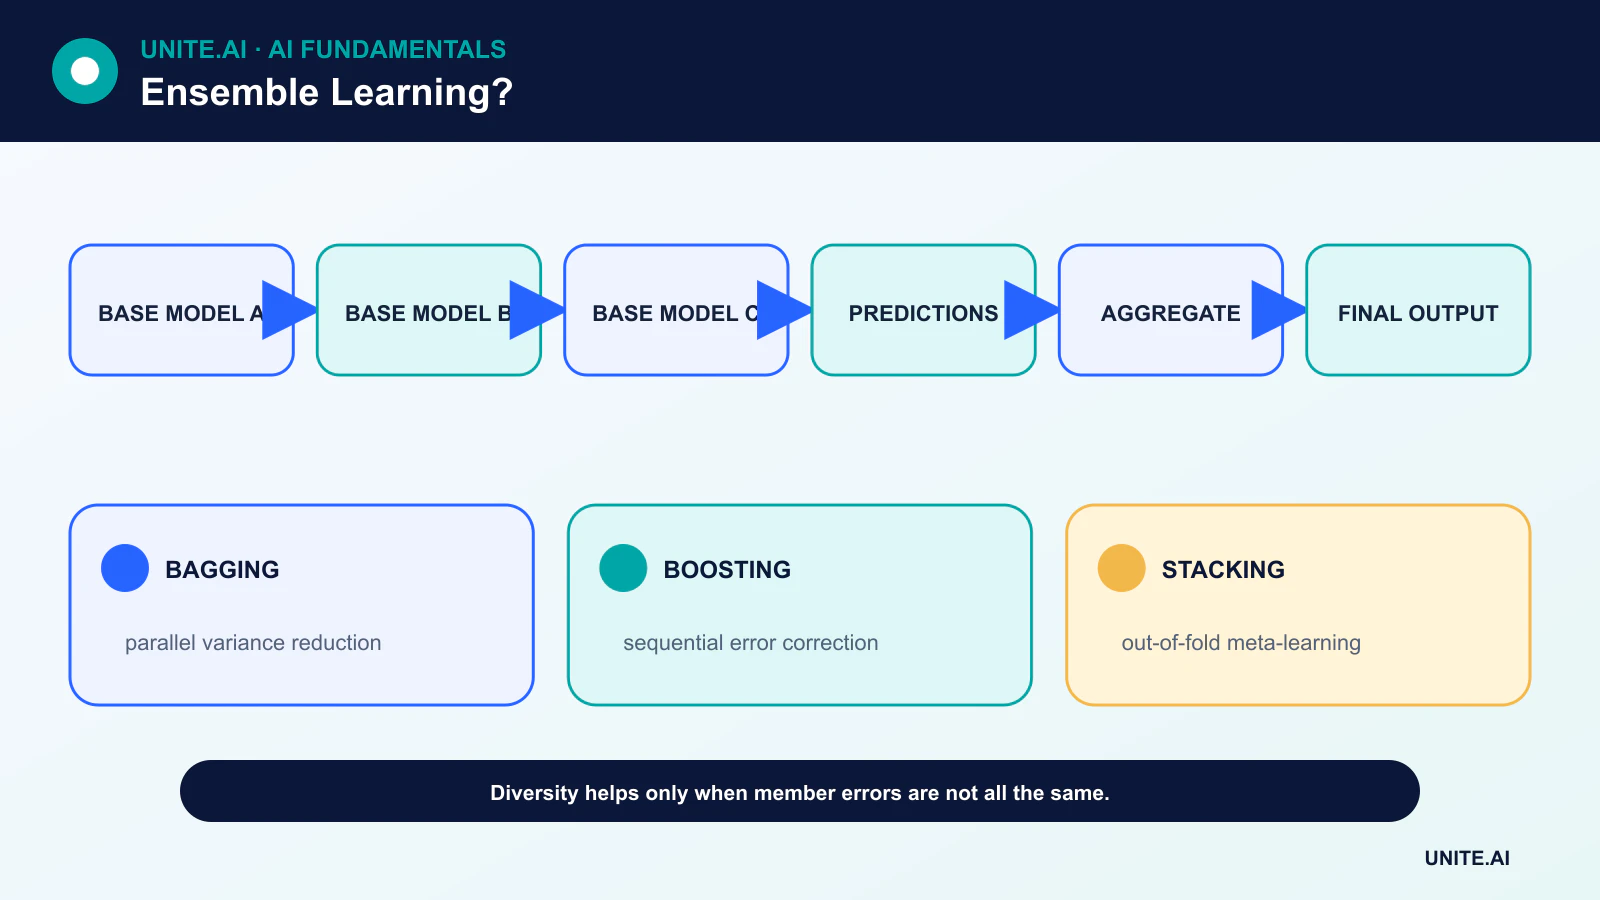
- Bagging treina os membros em paralelo em dados reamostrados; boosting treina os aprendizes sequencialmente para corrigir erros.
- Stacking treina um meta‑modelo em previsões fora da dobra, não em previsões dentro da amostra.
- Ganhos de acurácia devem ser ponderados contra latência, calibração, interpretabilidade e custo de manutenção.
Votação e média
A votação rígida seleciona a classe com mais votos. A votação suave calcula a média das probabilidades das classes, geralmente após calibração. Conjuntos de regressão costumam fazer a média das previsões numéricas. Versões ponderadas dão mais influência aos membros mais fortes.
A média pode reduzir a variância quando os erros não são perfeitamente correlacionados. Ela não pode corrigir um defeito de dados compartilhado, erro de rotulagem ou subgrupo ausente. A diversidade deve ser medida por meio de discordância e sobreposição de erros, não presumida a partir de nomes diferentes de modelos.
Bagging e florestas aleatórias
O agregamento por bootstrap treina modelos em conjuntos de dados reamostrados e os média. Uma árvore de decisão tem alta variância, tornando‑a uma candidata natural ao bagging.
Florestas aleatórias adicionam seleção aleatória de atributos nas divisões, reduzindo a correlação entre árvores. Exemplos fora‑da‑bolsa podem estimar o desempenho, mas um conjunto de teste final e intocado continua valioso para seleção de modelo e reivindicações de implantação.
Boosting
Boosting constrói um modelo aditivo em estágios. Aprendizes posteriores focam em exemplos ou padrões residuais que o conjunto atual trata mal. AdaBoost altera os pesos dos exemplos; gradient boosting ajusta os aprendizes aos gradientes negativos de uma perda escolhida.
Árvores boostadas podem modelar relações tabulares complexas, mas árvores profundas, rodadas excessivas e vazamento ainda podem causar overfit. Taxa de aprendizado, profundidade da árvore, subamostragem e parada precoce são controles essenciais.
Stacking e blending
Stacking cria um modelo de segundo nível que aprende a combinar as previsões base. Para evitar vazamento, cada linha de treinamento para o meta‑modelo deve provir de um modelo base que não foi treinado naquela linha. Validação cruzada gera essas previsões fora da dobra.
Blending usa um conjunto de retenção separado para o meta‑modelo, o que é mais simples, mas reduz os dados disponíveis para treinamento. Ambas as abordagens exigem o mesmo pré‑processamento e controle de versão na inferência.
Compromissos operacionais
Um conjunto pode multiplicar o uso de memória, computação e modos de falha. Pode ser mais difícil de explicar, calibrar e atualizar de forma consistente. A destilação pode comprimir um conjunto em um modelo menor, mas o modelo estudante deve ser avaliado independentemente.
Uma seleção prática compara desempenho, latência de cauda, calibração, uso de recursos e custo de erro. Às vezes, um modelo bem regularizado é preferível a um pequeno ganho de acurácia de um conjunto frágil.
Por que conjuntos funcionam
Aprendizado em conjunto combina múltiplos modelos de modo que seus erros se cancelam parcialmente ou seus pontos fortes cobrem diferentes regiões. Bagging treina modelos em dados reamostrados e média as previsões, reduzindo a variância; florestas aleatórias adicionam seleção aleatória de atributos para decorrelacionar as árvores. Boosting treina aprendizes sequencialmente para focar no erro residual, frequentemente reduzindo o viés, mas aumentando a sensibilidade ao ruído e à sintonia. Stacking treina um meta‑modelo nas previsões dos modelos base. A diversidade deve ser útil: a média de modelos idênticos acrescenta custo sem reduzir muito o erro.
A correlação entre erros determina o benefício. A diversidade pode surgir de amostras de dados, atributos, algoritmos, hiperparâmetros, inicialização aleatória ou janelas temporais. Votação rígida descarta a confiança; votação suave calcula a média das probabilidades, mas requer calibração compatível. Regressão pode fazer média ou usar agregação robusta. No stacking, previsões fora da dobra são essenciais — treinar o meta‑modelo em previsões base dos mesmos dados ajustados gera vazamento. Mantenha uma linha de base simples de média antes de adotar um combinador complexo.
Avaliação, calibração e incerteza
Compare cada membro e o conjunto em um conjunto reservado com pré‑processamento idêntico. Relate métricas da tarefa, calibração, erros por subgrupo, variância entre dobras ou sementes, e custo de recursos. Um conjunto pode melhorar a qualidade média enquanto mascara um ponto cego compartilhado causado por dados ou rótulos comuns. Inspecione a discordância: ela pode identificar incerteza, mas modelos correlacionados e confiantes em erro podem concordar. Calibre o conjunto final, não apenas os membros, e valide os limites de abstenção contra a capacidade de revisão e as consequências.
Estimativas fora da bolsa são úteis para modelos bagged, mas não substituem um teste final representativo da implantação. Para dados temporais, evite reamostragem que quebre a ordem. Para usos relacionados à segurança, teste falhas de membros, modelos desatualizados e entradas adversariais. Conjuntos ponderados podem causar overfit nos dados de validação quando muitos candidatos são testados. Registre a seleção de candidatos e use validação aninhada quando a sintonia for extensa.
Serviço e manutenção
Conjuntos multiplicam memória, latência, energia e dependências operacionais. A destilação pode comprimir o comportamento combinado em um único modelo, exigindo nova validação. Versione membros, pré‑processamento, pesos e roteamento como um único artefato; defina o comportamento quando um membro expira ou produz um resultado inválido. Monitore as previsões dos membros e a discordância para que falhas silenciosas sejam visíveis. Desative membros redundantes e re‑treine deliberadamente. Conjuntos melhoram a previsão quando a diversidade de erros é real, mas não transformam dados de treinamento tendenciosos ou um alvo inválido em evidência confiável.
Exemplo prático: um conjunto para alertas de clima severo
Uma equipe de previsão combina um conjunto de recursos de modelo físico, árvore gradient‑boosted, modelo neural sequencial e baseline estatístico calibrado. Previsões fora da dobra treinam um meta‑modelo simples, e a avaliação usa tempestades futuras totalmente excluídas do treinamento dos membros. Métricas incluem recall de eventos, alarmes falsos, tempo de antecedência, calibração, desempenho geográfico e confiabilidade em condições extremas raras. A correlação de erros dos membros é examinada porque dados de entrada compartilhados podem criar pontos cegos comuns.
O serviço mantém cada previsão e o resultado combinado. Se um membro estiver indisponível, o sistema usa uma configuração degradada pré‑validada em vez de renormalizar silenciosamente. A discordância gera revisão adicional, mas não é tratada como incerteza em todos os casos. O monitoramento acompanha a deriva dos membros, latência e resultados das tempestades, com pesos atualizados apenas por validação controlada. Avisos públicos permanecem sob processos de decisão meteorológica autorizados; o conjunto melhora a evidência, mas não redefine autonomamente a política de alerta.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes da sintonia. Teste casos ordinários, condições de fronteira, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre toda transformação e limite para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e aposentamento. Use um rollout em etapas, preserve um fallback seguro e verifique o monitoramento com falhas inseridas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
Uma floresta aleatória é um ensemble?
Sim. Ela combina muitas árvores de decisão randomizadas, geralmente por votação ou média.
Modelos idênticos podem formar um ensemble útil?
Eles podem se forem os dados de treinamento, a inicialização ou a amostragem criarem erros suficientemente diferentes, mas a mera duplicação não traz benefício.
Referências principais












