
Fundamentos de IA
O que é uma Árvore de Decisão?

 Adicione Unite.AI às suas fontes preferidas no Google
Uma árvore de decisão é um modelo de aprendizado supervisionado que faz uma previsão aplicando uma sequência de regras se‑então. Cada nó interno testa uma característica, cada ramo representa um resultado desse teste e cada folha produz uma previsão de classe, probabilidade ou valor numérico.
Árvores de decisão são usadas para classificação e regressão. Seu atrativo é prático: podem representar interações não lineares, exigem relativamente pouco pré‑processamento e produzem um caminho que uma pessoa pode inspecionar. Sua fraqueza é a instabilidade — pequenas alterações nos dados de treinamento podem gerar uma árvore diferente.
Principais conclusões
- Uma árvore particiona recursivamente o espaço de características; não precisa isolar cada observação de treinamento.
- Divisões de classificação costumam usar impureza de Gini ou entropia, enquanto divisões de regressão reduzem o erro de previsão ou a variância.
- Profundidade, tamanho mínimo da folha e poda controlam a complexidade e o sobreajuste.
- Florestas aleatórias e árvores de gradiente aumentam o poder preditivo combinando muitas árvores.
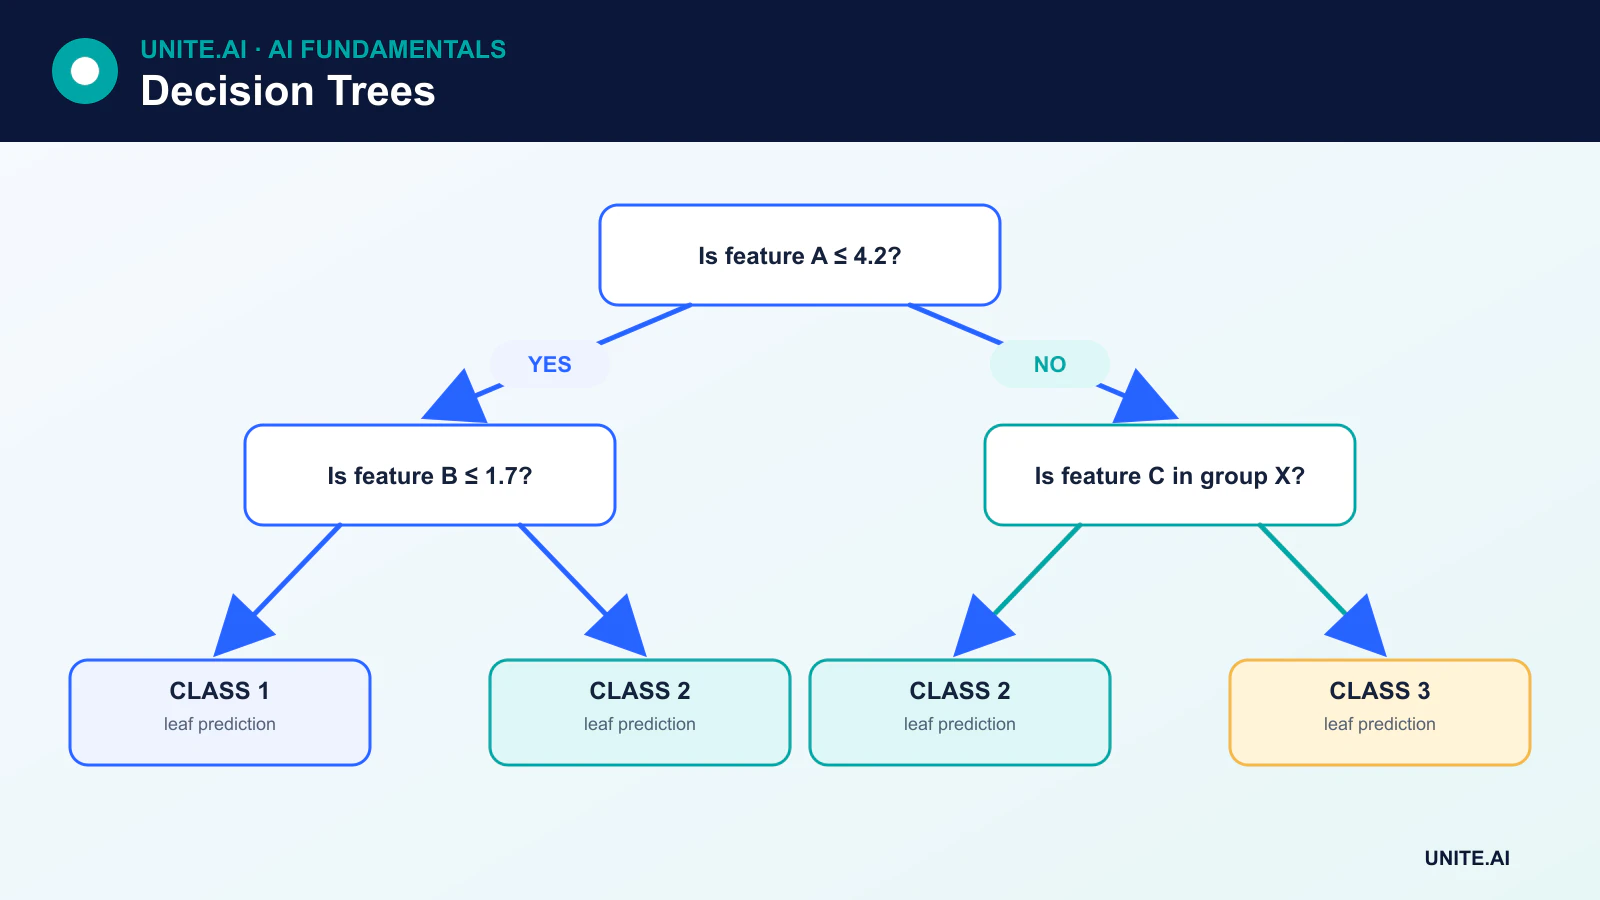
Como uma árvore de decisão faz uma previsão
Suponha que um modelo preveja se uma máquina tem probabilidade de falhar. O nó raiz pode perguntar se a vibração excede um limiar aprendido. Um ramo pode então testar a temperatura de operação. A observação chega a uma folha que contém a probabilidade estimada de falha entre os exemplos de treinamento que seguiram o mesmo caminho.
Para regressão, a folha pode retornar o valor médio alvo das observações naquela região. Para classificação, pode retornar a classe majoritária ou uma distribuição das frequências de classe. Uma folha pode conter muitas observações; separar completamente os dados de treinamento geralmente é indesejável porque pode gerar uma árvore sobreajustada.
Como uma árvore escolhe uma divisão
O treinamento considera características e limiares candidatos, e então seleciona a divisão que mais melhora um objetivo definido. A melhoria deve ser ponderada pelo número de observações que vão para cada nó filho.
Impureza de Gini
Para classificação, a impureza de Gini mede o quão misturadas estão as classes em um nó:
Gini = 1 - Σ p(k)²
Um nó que contém apenas uma classe tem impureza zero. Uma divisão candidata é útil quando a impureza ponderada de seus filhos é menor que a impureza do nó pai.
Entropia e ganho de informação
Entropia é outra medida de incerteza de classe:
Entropy = -Σ p(k) log₂ p(k)
Ganho de informação é a entropia do nó pai menos a entropia ponderada dos nós filhos. Gini e entropia costumam produzir árvores semelhantes, embora nem sempre idênticas.
Perda de regressão
Árvores de regressão costumam escolher divisões que reduzem o erro quadrático, erro absoluto ou outro critério de regressão. Cada folha então prevê um valor com base nos alvos de treinamento dentro daquela região.
CART e outros algoritmos de árvore
CART, ou Árvores de Classificação e Regressão, usa divisões binárias e está na base de implementações comuns como as árvores de decisão do scikit-learn. Outros algoritmos incluem ID3, C4.5 e C5.0. As implementações diferem nos tipos de divisão suportados, no tratamento de valores ausentes, na poda e nos objetivos.
Variáveis categóricas podem exigir codificação, divisões de subconjunto direto ou tratamento específico da implementação. Valores ausentes podem ser imputados ou tratados por meio de direções padrão aprendidas ou divisões substitutas. É importante compreender o comportamento da biblioteca específica em vez de assumir que toda implementação de árvore funciona da mesma forma.
Controlando a complexidade da árvore
Uma árvore profunda pode memorizar ruído. Controles comuns incluem:
- Profundidade máxima: limita o comprimento de um caminho de predição.
- Mínimo de amostras por divisão ou folha: impede regiões diminutas.
- Diminuição mínima de impureza: requer que a divisão ofereça benefício suficiente.
- Número máximo de folhas: limita a complexidade total.
- Poda de custo‑complexidade: remove ramos cuja melhoria não justifica a complexidade adicional.
A poda é um processo de otimização estruturada, não uma exclusão aleatória. Os hiperparâmetros devem ser escolhidos com dados de validação ou validação cruzada, enquanto o conjunto de teste final permanece intocado.
Vantagens e limitações
Árvores de decisão podem modelar interações e efeitos de limiar sem escalonamento de características. Elas aceitam entradas numéricas e, dependendo da implementação, categóricas. A predição é rápida e uma árvore pequena é fácil de visualizar.
Entretanto, uma única árvore pode ter alta variância, criar mudanças abruptas de predição próximo a uma divisão e favorecer características com muitos pontos de divisão possíveis. Árvores também extrapolam mal em regressão: fora das regiões observadas, uma folha ainda retorna um valor aprendido a partir de suas amostras de treinamento. Uma árvore grande pode não ser mais compreensível que outro modelo complexo.
De uma árvore a ensembles
Aprendizado em conjunto combina múltiplos modelos. Uma floresta aleatória treina muitas árvores em observações reamostradas e subconjuntos de características, depois faz a média de suas previsões. O gradient boosting constrói árvores sequencialmente de modo que cada nova árvore corrige o erro restante. Essas abordagens geralmente superam uma única árvore, mas sacrificam parte da interpretabilidade e adicionam custo computacional.
A importância das características de uma árvore ou ensemble deve ser interpretada com cautela. A importância baseada em impureza pode ser tendenciosa, e a importância de uma característica não prova causalidade. Importância por permutação, ferramentas de dependência parcial e revisão de domínio fornecem contexto adicional.
Como uma árvore aprende divisões e previsões
Uma árvore de decisão particiona recursivamente o espaço de características. Em cada nó, um algoritmo de treinamento avalia limiares de características candidatos ou partições de categorias e seleciona a divisão que mais reduz a impureza, como impureza de Gini ou entropia para classificação e erro quadrático para regressão. As folhas armazenam uma distribuição de classes ou uma predição numérica baseada nas observações de treinamento que as atingem. Divisões gananciosas são computacionalmente práticas, mas não garantem a árvore globalmente ótima, e diferentes amostras ou critérios de desempate podem produzir estruturas diferentes.
Recursos contínuos, ordinais, categóricos e ausentes precisam de tratamento explícito. Codificação one‑hot pode criar muitas divisões candidatas; métodos categóricos nativos podem usar estatísticas ordenadas, mas precisam de implementação segura contra vazamento. Árvores não exigem escalonamento, embora possam favorecer variáveis de alta cardinalidade e isolar pequenos grupos. Profundidade, tamanho mínimo da folha, diminuição mínima de impureza e poda de custo‑complexidade controlam a variância. Escolha‑os com dados de validação e avalie a calibração, pois uma probabilidade de folha baseada em poucos casos pode ser extrema e instável.
Interpretação, modos de falha e uso em produção
Um caminho da raiz até a folha é uma regra exata para uma predição do modelo, mas não é automaticamente uma explicação causal. Variáveis correlacionadas podem substituir uma à outra, pequenas mudanças nos dados podem alterar divisões superiores, e um caminho aparentemente simples pode depender de rótulos tendenciosos. A importância global das características baseada em impureza pode ser enganosa; importância por permutação, dependência parcial e verificações contrafactuais adicionam contexto, mas também têm pressupostos. Relate a incerteza e teste se a regra suposta se mantém em dados independentes e subgrupos relevantes.
Árvores individuais são úteis quando transparência, baixa latência e estrutura não linear moderada são importantes, mas ensembles geralmente oferecem desempenho preditivo mais forte. Valide o comportamento nas fronteiras, categorias raras, ausências e entradas fora do intervalo de treinamento. Regras exportadas devem reproduzir exatamente o pré‑processamento de treinamento e a comparação numérica. Monitore a ocupação das folhas, a distribuição de saída, erros e categorias emergentes. Uma árvore que encaminha muitos novos casos para uma região pequena ou previamente vazia deve acionar revisão mesmo que o desvio agregado permaneça pequeno. Mantenha um fallback para esquemas inválidos e documente cada decisão de poda ou limiar.
Exemplo prático: uma árvore de triagem de empréstimo interpretável
Um credor usa uma árvore apenas para priorizar solicitações incompletas para revisão manual, não para aprovar ou negar crédito. O objetivo é um resultado de completude documentado, e as características disponíveis na entrada excluem decisões posteriores. Validação temporal agrupada compara uma árvore rasa podada com regras e regressão logística. Tamanho mínimo da folha impede regras baseadas em um pequeno número de solicitantes, enquanto a calibração e erros específicos por classe são relatados em diferentes canais e grupos protegidos relevantes.
Os revisores veem o caminho exato e os valores de origem, mas podem corrigir dados errôneos e substituir o encaminhamento. A organização testa proxies correlacionados e mudanças contrafactuais, monitora a ocupação das folhas e ausências, e trata tráfego súbito para uma folha pequena como um incidente de qualidade de dados. Mudanças de política criam uma nova versão do modelo e validação, não uma edição de divisão não documentada. Como o uso afeta acesso e carga, os solicitantes recebem um canal humano e a árvore nunca é apresentada como explicação causal da capacidade de crédito.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entrada malformada ou ausente, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa junto com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversões e aposentadoria. Use um rollout em etapas, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade de entrada, comportamento de saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Referências principais












