
Fundamentos de IA
O que é Overfitting?

 Adicione Unite.AI às suas fontes preferidas no Google
Overfitting ocorre quando um modelo captura padrões ou ruídos que funcionam excepcionalmente bem nos dados de treinamento, mas falham ao generalizar para novos exemplos. Um modelo com overfit pode apresentar erro de treinamento muito baixo, enquanto o desempenho em validação ou no mundo real é substancialmente pior.
O problema oposto é underfitting: o modelo ou o processo de treinamento não consegue capturar sinal suficiente mesmo no conjunto de treinamento. Uma modelagem adequada equilibra ajuste e generalização ao invés de buscar desempenho perfeito no treinamento.
Principais pontos
- Desempenho de treinamento sozinho não pode diagnosticar a generalização.
- A parada antecipada deve usar o comportamento da validação, nunca decisões repetidas no conjunto de teste final.
- Mais dados podem ajudar, mas mais recursos ou capacidade também podem agravar o overfitting.
- Regularização, aumento de dados, validação cruzada, prevenção de vazamento e avaliação adequada abordam causas diferentes.
Ajuste, underfitting e overfitting
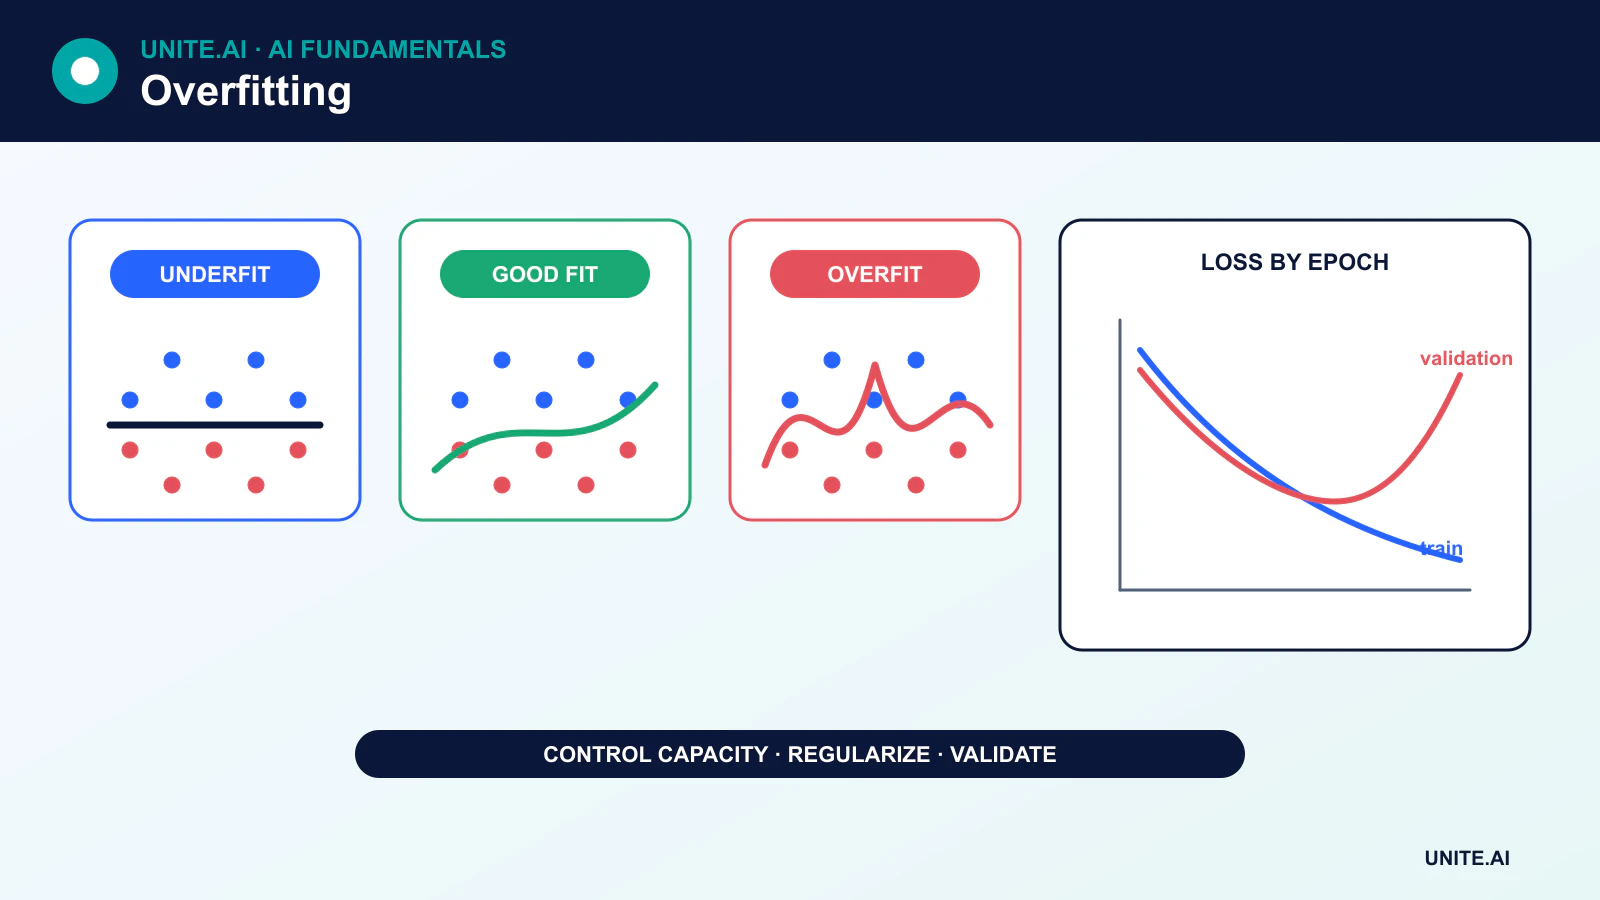
Um modelo sofre underfitting quando suas suposições são muito restritivas, suas características omitirem sinais importantes, a otimização for inadequada ou o treinamento for insuficiente. Adicionar recursos relevantes ou capacidade pode ajudar, mas simplesmente acrescentar recursos arbitrários pode aumentar o ruído e o overfitting.
Um modelo overfitta quando sua capacidade efetiva é muito alta em relação à informação presente nos dados de treinamento. Exemplos incluem uma árvore de decisão profunda que cria folhas minúsculas, um polinômio que segue flutuações aleatórias ou uma rede neural que memoriza exemplos.
O papel dos dados de treinamento, validação e teste
- Dados de treinamento ajustam os parâmetros do modelo.
- Dados de validação selecionam arquitetura, hiperparâmetros, limiares e momento de parada.
- Dados de teste fornecem uma estimativa final após essas escolhas serem concluídas.
Se o conjunto de teste orientar decisões repetidamente, ele passa a fazer parte do processo de desenvolvimento e deixa de fornecer uma estimativa final imparcial. A validação cruzada pode usar de forma mais eficiente dados limitados, mas todo pré-processamento e seleção de recursos devem ocorrer dentro de cada dobra de treinamento.
Parada antecipada
Durante o treinamento, a perda de treinamento normalmente continua diminuindo. A perda de validação pode cair inicialmente e depois subir à medida que o modelo se especializa no ruído do treinamento. A parada antecipada salva o ponto de verificação com o melhor objetivo de validação ou interrompe após a validação não melhorar por um período de paciência definido.
O ponto de verificação correto não é aquele com a menor perda de treinamento. Um conjunto de teste final separado é avaliado após a parada antecipada e a finalização das decisões de ajuste.
Métodos de regularização
Penalidades de peso
A regularização L2 ou decaimento de peso desencoraja valores de parâmetros grandes. A regularização L1 pode incentivar coeficientes esparsos. Seus efeitos dependem do modelo e do otimizador; AdamW, por exemplo, desacopla o decaimento de peso da atualização adaptativa.
Dropout e regularização estocástica
O dropout mascara aleatoriamente ativações durante o treinamento. Outros métodos descartam caminhos, perturbam recursos ou suavizam rótulos. Essas técnicas alteram o objetivo de treinamento e devem ser desativadas ou tratadas adequadamente na inferência.
Aumento de dados
O aumento cria variações realistas — como recortes, rotações, ruído ou paráfrases — que devem preservar o alvo. Transformações inválidas podem alterar o rótulo e prejudicar o modelo. Para visão, ferramentas como Albumentations ajudam a implementar pipelines controlados.
Controle de capacidade
Árvores mais rasas, menos parâmetros, seleção de recursos, poda e classes de hipótese mais simples podem reduzir a variância. A poda de árvores é guiada por critérios, não por remoção aleatória de detalhes aprendidos.
Vazamento de dados pode parecer desempenho excepcional
O vazamento ocorre quando informações indisponíveis no momento da predição entram no treinamento ou na avaliação. Exemplos comuns incluem ajustar a normalização em todo o conjunto de dados, dividir registros repetidos entre dobras, usar dados futuros para prever o passado ou incluir um recurso derivado do alvo.
O vazamento não é overfitting comum, mas cria a mesma lacuna enganosa entre resultados offline e a implantação. A estratégia de divisão deve respeitar tempo, identidade, localização e processos de geração de dados.
Mudança de distribuição é um problema separado
Um modelo pode generalizar para sua distribuição de teste e ainda falhar quando os dados de produção mudam. Novos dispositivos, políticas, populações, estações ou comportamentos adversariais podem alterar a relação entre entrada e alvo. Monitoramento e reavaliação periódica são necessários mesmo quando o modelo original não estava overfit.
Diagnóstico de overfitting
Use curvas de aprendizado, variância da validação cruzada, métricas de subgrupos, calibração e inspeção de erros. Se tanto o desempenho de treinamento quanto o de validação forem ruins, concentre-se no underfitting, recursos, rótulos ou otimização. Se o treinamento for forte e a validação fraca, investigue capacidade, vazamento, regularização e representatividade antes de simplesmente coletar mais dados.
Por que o overfitting acontece e como detectá-lo
Overfitting ocorre quando um modelo aprende padrões que reduzem o erro de treinamento, mas não se generalizam para a população-alvo. As causas incluem capacidade excessiva em relação aos dados efetivos, ruído nos rótulos, entidades repetidas, seleção flexível de recursos, vazamento e ajuste contra o mesmo conjunto de validação. Uma lacuna crescente entre desempenho de treinamento e validação é evidência comum, mas uma pequena lacuna não elimina o overfitting se ambos os conjuntos compartilham contaminação ou diferem da implantação. Curvas de aprendizado ao variar volume de dados e capacidade ajudam a distinguir variância de viés.
O vazamento é especialmente enganoso: informações futuras, duplicatas, sobreposição de sujeitos, ajuste de pré-processamento em todos os dados ou rótulos codificados em metadados podem gerar pontuações excelentes em dados reservados. Divida pelos unidades que serão novas na implantação — paciente, cliente, máquina, localização ou tempo — antes de ajustar transformações ou aumentos. Mantenha um conjunto de teste final selado enquanto escolhe recursos, arquitetura e limiares. Se as equipes inspecionarem repetidamente os resultados de teste, o conjunto de teste torna‑se outro conjunto de validação e precisa ser substituído ou corrigido formalmente.
Regularização, seleção de modelo e deriva de produção
Reduza o overfitting com dados mais representativos, menor capacidade, decaimento de peso, dropout, parada antecipada, aumento de dados, ensemble ou restrições que reflitam a estrutura do domínio. Cada método tem trade‑offs: aumento pode distorcer rótulos, dropout altera a otimização e ensembles aumentam o custo de serviço. A validação cruzada estima a variabilidade da seleção, mas dobras agrupadas ou sensíveis ao tempo devem preservar a fronteira de implantação. Compare com um modelo simples e relate a incerteza entre dobras ou sementes ao invés de selecionar a execução mais favorável.
A produção pode revelar uma forma diferente de falha de generalização quando entradas, usuários, incentivos ou medições mudam. Monitore distribuições de recursos e previsões, calibração, resultados de subgrupos e verdade de base atrasada. Não re‑treine automaticamente com feedback não revisado; as próprias decisões do modelo podem moldar os rótulos que ele verá posteriormente. Diagnostique se a falha provém de deriva, pipelines de dados, mudanças de política ou de um alvo inválido. O overfitting é controlado por desenho experimental e disciplina de ciclo de vida, não por um único ajuste de regularização.
Exemplo prático: eliminando vazamento em um modelo de fraude
Um classificador inicial de fraude pontua extremamente bem porque eventos repetidos de cartão e comerciante aparecem aleatoriamente nas linhas de treinamento e teste, e informações de chargeback registradas semanas depois são incluídas como recurso. A equipe reconstrói o momento de disponibilidade de cada recurso, remove campos pós‑decisão, agrupa por conta e usa uma divisão temporal avançada. O desempenho cai bruscamente, mas agora estima a decisão real. Uma linha de base de regras simples e curvas de aprendizado orientam a complexidade necessária do modelo.
Regularização e parada antecipada são ajustadas apenas dentro das dobras históricas. A avaliação final relata precisão na capacidade de revisão, recall, calibração e custo por tipo de fraude e segmento de cliente. Na produção, rótulos confirmados chegam tardios e são tendenciosos conforme quais transações foram revisadas, portanto o monitoramento separa a deriva de pontuação das estimativas de resultado. O re‑treinamento usa casos adjudicados e replay contra a política atual. O projeto prefere uma pontuação honesta mais baixa a uma pontuação alta vazada que não sobrevive à implantação.
Evidência de implementação e prontidão operacional
Uma decisão de produção requer mais que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa junto com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, mudanças, rollback e aposentadoria. Use um rollout escalonado, preserve um fallback seguro e verifique o monitoramento com falhas deliberadamente injetadas. A telemetria operacional deve revelar qualidade de entrada, comportamento de saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, depois revise evidências reais após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também necessita de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
Um modelo simples pode overfitar?
Sim. Seleção repetida de recursos, ajuste de limiares ou avaliação no mesmo conjunto de retenção podem causar overfitting no processo de desenvolvimento, mesmo quando o modelo final é simples.
Mais dados de treinamento sempre resolvem o overfitting?
Não. Dados mais representativos e corretamente rotulados podem ajudar, mas dados duplicados, tendenciosos, vazados ou fora do domínio podem não ser úteis. O objetivo de aprendizado e o desenho da avaliação ainda são importantes.
Referências principais












