
Fundamentos de IA
Aprendizado Supervisionado vs Aprendizado Não Supervisionado

 Adicione Unite.AI às suas fontes preferidas no Google
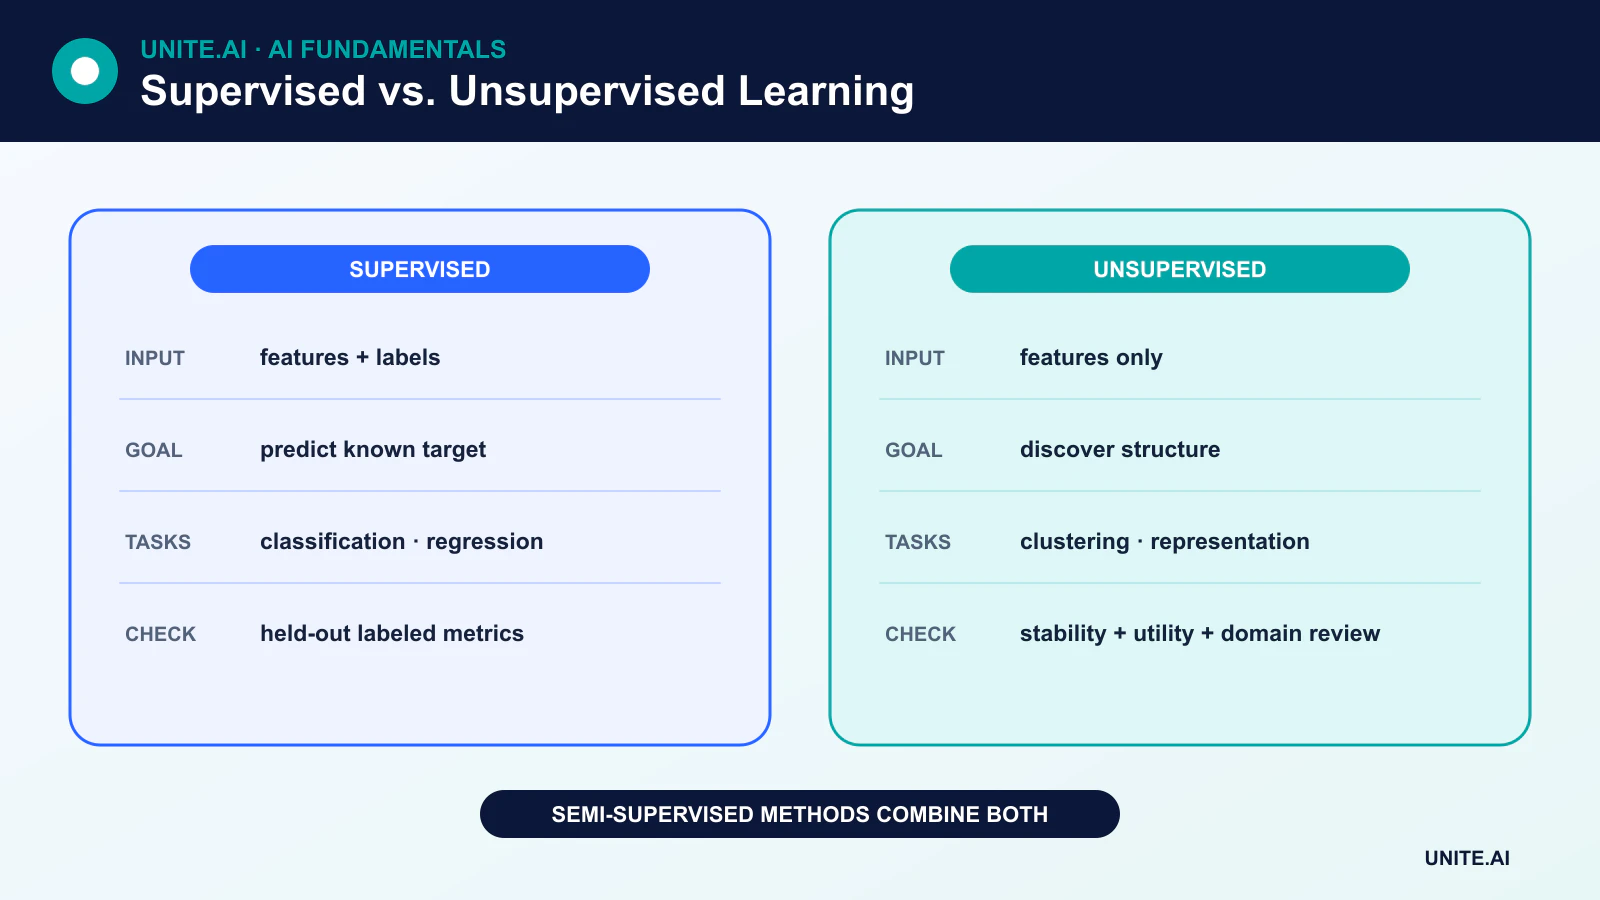
Aprendizado supervisionado aprende a partir de exemplos associados a respostas-alvo. Aprendizado não supervisionado busca estruturas nos dados sem rótulos alvo. A diferença não está em qual abordagem é mais inteligente ou precisa; trata‑se do tipo de sinal de aprendizado disponível e da questão que o sistema foi projetado para responder.
Estas são duas paradigmas principais dentro do machine learning, mas os sistemas modernos também utilizam aprendizado semi-supervisionado, auto‑supervisionado e aprendizado por reforço.
Principais conclusões
- Aprendizado supervisionado prevê um alvo conhecido; aprendizado não supervisionado descobre padrões ou representações.
- Classificação e regressão são tarefas supervisionadas; agrupamento, estimativa de densidade e muitos métodos de redução de dimensionalidade são não supervisionados.
- Saídas não supervisionadas não são automaticamente classes do mundo real e podem ser mais difíceis de avaliar.
- O custo computacional e a precisão dependem do algoritmo, dos dados, da tarefa e da avaliação — não apenas do paradigma.
Como funciona o aprendizado supervisionado
Um conjunto de dados supervisionado contém características X e um alvo y. O treinamento ajusta um modelo de modo que suas previsões se aproximem dos alvos. A avaliação usa exemplos rotulados reservados para estimar quão bem ele generaliza.
Classificação
A classificação prevê uma categoria: spam ou não spam, um tópico de documento entre vários, ou um ou mais objetos em uma imagem. Métricas relevantes incluem precisão, recall, F1, calibração e medidas sensíveis a custos. A acurácia pode ser enganosa quando uma classe é rara; uma matriz de confusão revela quais classes estão sendo confundidas.
Regressão
A regressão prevê um valor contínuo, como demanda, duração ou temperatura. Regressão linear pode usar uma ou muitas características; não se limita a traçar uma relação entre duas variáveis. Métricas de regressão incluem erro absoluto médio, raiz do erro quadrático médio e custos específicos da tarefa.
Algoritmos supervisionados comuns
Métodos supervisionados incluem modelos lineares e logísticos, árvores de decisão, florestas aleatórias, gradient boosting, máquinas de vetor de suporte, K‑vizinhos mais próximos e redes neurais.
A regressão logística produz uma pontuação ou probabilidade que pode ser convertida em classe usando um limiar escolhido. Uma folha de árvore de decisão contém uma previsão baseada em uma região do espaço de características, não necessariamente em uma única observação de treinamento. O KNN prevê a partir de exemplos de treinamento rotulados próximos e ainda requer um design sólido de treino/validação/teste.
Como funciona o aprendizado não supervisionado
O aprendizado não supervisionado recebe características sem uma coluna alvo. Seu objetivo é definido indiretamente — por exemplo, minimizar a distância dentro dos clusters, reconstruir uma entrada, estimar a densidade dos dados ou reter o máximo de variância possível em menos dimensões.
Agrupamento
K‑means atribui pontos a um número escolhido de clusters e atualiza os centros dos clusters para reduzir a distância quadrática intra‑cluster. O algoritmo descobre agrupamentos geométricos sob uma medida de distância e representação de características específicas. Esses grupos não correspondem automaticamente a tipos de clientes, diagnósticos ou outros rótulos de domínio significativos.
Redução de dimensionalidade
Redução de dimensionalidade representa os dados usando menos variáveis. A análise de componentes principais encontra direções ortogonais que retêm o máximo de variância possível sob uma projeção linear. Outros métodos preservam diferentes noções de estrutura e podem gerar visualizações muito diferentes.
Detecção de anomalias e estimativa de densidade
Métodos não supervisionados podem estimar onde os dados são densos e sinalizar observações incomuns. Uma pontuação de anomalia não prova fraude, falha ou comportamento malicioso; ela identifica um desvio sob a representação e o modelo escolhidos.
Como o aprendizado não supervisionado é avaliado
Não há noção universal de “acurácia” no aprendizado não supervisionado. Um praticante pode usar métricas internas como o índice silhouette, comparar a estabilidade entre amostras, testar a utilidade em uma tarefa downstream ou consultar especialistas de domínio sobre se a estrutura descoberta é significativa. Se rótulos de verdade‑terra existirem para avaliação, métricas externas de clustering podem ser usadas sem transformar o processo de treinamento em aprendizado supervisionado.
Além da comparação bidirecional
Aprendizado semi-supervisionado
O aprendizado semi-supervisionado combina um conjunto rotulado menor com um conjunto não rotulado maior. Pseudo‑rotulação, regularização de consistência e métodos baseados em grafos são exemplos. Os dados não rotulados ainda precisam se assemelhar suficientemente à distribuição alvo para serem úteis.
Aprendizado auto-supervisionado
O aprendizado auto‑supervisionado gera alvos a partir da própria entrada, como prever tokens mascarados ou corresponder vistas transformadas. É uma base para os modelos modernos de linguagem, visão e multimodais, incluindo transformers.
Aprendizado por reforço
Aprendizado por reforço otimiza decisões por meio de recompensas geradas pela interação. Difere tanto da predição rotulada quanto da descoberta estática de padrões.
Escolhendo a abordagem correta
Comece com a decisão ou insight que o sistema deve produzir. Se alvos confiáveis existirem e a predição for o objetivo, o aprendizado supervisionado é natural. Se o objetivo for exploração, representação ou agrupamento, um método não supervisionado pode ser adequado. Quando os rótulos são escassos, o pré‑treinamento auto‑supervisionado ou semi‑supervisionado seguido de avaliação supervisionada pode ser mais eficaz.
Em todos os casos, vazamento de dados, amostragem tendenciosa, proxies fracos e mudança de distribuição podem dominar a escolha do algoritmo. Um modelo tecnicamente correto treinado com o objetivo errado ainda pode falhar.
Sinais de aprendizado, objetivos e métodos representativos
O aprendizado supervisionado usa exemplos associados a rótulos ou valores-alvo e otimiza o erro preditivo. Classificação, regressão, ranking e predição estruturada diferem em saída e função de perda. O aprendizado não supervisionado busca estrutura sem rótulos alvo por meio de clustering, estimativa de densidade, redução de dimensionalidade, aprendizado de representação ou modelagem generativa. O aprendizado auto‑supervisionado cria alvos de predição a partir dos próprios dados, enquanto o aprendizado semi‑supervisionado combina um pequeno conjunto rotulado com dados não rotulados maiores. Essas categorias descrevem o sinal de aprendizado; a mesma arquitetura neural pode ser treinada sob vários paradigmas.
Os rótulos tornam um objetivo explícito, mas introduzem custo de anotação, ruído, suposições de política e atraso temporal. Dados não rotulados são mais fáceis de coletar, mas não indicam a um algoritmo qual estrutura descoberta é útil. Um cluster pode refletir iluminação, tamanho de documento ou fonte de aquisição em vez de uma categoria significativa. Defina a avaliação independentemente: modelos supervisionados utilizam resultados rotulados reservados, enquanto modelos não supervisionados precisam de estabilidade, reconstrução, verossimilhança, recuperação, utilidade downstream ou validação por especialistas. A separação visual por si só não prova a validade da estrutura.
Escolhendo um paradigma e prevenindo erros comuns
Use aprendizado supervisionado quando existir um alvo estável e rótulos representativos. Use a exploração não supervisionada para resumir, detectar novidades, compactar ou gerar hipóteses, mas trate as saídas como provisórias. O pré‑treinamento auto‑supervisionado é valioso quando há abundância de dados brutos e as tarefas downstream compartilham representações. Métodos semi‑supervisionados ajudam apenas quando as suposições sobre dados não rotulados e a estrutura de classes são válidas. Compare com linhas de base simples e considere o custo total de coleta, rotulação, revisão, computação e erros, ao invés de assumir que dados não rotulados são automaticamente baratos.
Previna vazamento separando entidades relacionadas antes de derivar rótulos, ampliações ou pseudo‑rótulos. Monitore o equilíbrio de classes, concordância de anotação, estabilidade dos clusters, colapso e deriva. Pseudo‑rótulos podem reforçar erros iniciais; o clustering pode codificar atributos sensíveis; uma representação pré‑treinada pode transferir viés de origem. A revisão humana deve focar em casos de fronteira e consequências. Em produção, documente como o sinal de aprendizado foi criado e quando ele se torna obsoleto. O paradigma determina onde a supervisão entra no sistema, não se escolhas e valores humanos estão presentes.
Exemplo prático: descoberta e rotulagem de tópicos de suporte
Uma empresa primeiro usa embeddings e clustering não supervisionados para explorar temas em mensagens de suporte desidentificadas. Analistas inspecionam exemplos representativos e de fronteira e descobrem que alguns clusters refletem o comprimento da mensagem e o canal, ao invés de problemas. Eles desenvolvem uma taxonomia supervisionada com uma classe desconhecida, diretrizes de anotação e acordo mensurado. Um classificador é então avaliado em períodos posteriores, idiomas e produtos, comparado a linhas de base baseadas em palavras‑chave e vizinhos mais próximos.
Mensagens novas não rotuladas suportam a descoberta de deriva, mas não re‑treinam o classificador automaticamente. Revisores rotulam casos incertos e emergentes selecionados por meio de aprendizado ativo, com verificações de qualidade e um conjunto de avaliação selado. O monitoramento acompanha a prevalência dos tópicos, confiança, discordância e resultados de roteamento. Quando um novo produto é lançado, a taxonomia e a capacidade das equipes downstream são atualizadas simultaneamente. O fluxo de trabalho usa métodos não supervisionados para geração de hipóteses e evidência supervisionada para roteamento operacional.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, o ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes de ajustar. Teste casos ordinários, condições de fronteira, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre toda transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, mudanças, rollback e desativação. Use um rollout em etapas, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, o comportamento da saída, a versão do modelo ou regra, a saúde das dependências, intervenções humanas e os resultados confirmados, sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, então revise evidências do mundo real após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também necessita de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que ele deve ser desativado ou substituído.
Referências principais












