
Fundamentos de IA
Modelos Prontos vs. Personalizados de Aprendizado de Máquina

 Adicione Unite.AI às suas fontes preferidas no Google
Escolher uma solução de aprendizado de máquina raramente é uma decisão simples de comprar versus construir. O verdadeiro continuum vai de uma API hospedada ou modelo empacotado, passando por prompting, recuperação e ajuste fino, até uma arquitetura totalmente personalizada treinada com dados específicos da organização.
A melhor opção é a abordagem menos complexa que atende a um requisito de produto verificado. Um modelo personalizado pode gerar controle e diferenciação, mas também cria uma obrigação contínua de operar pipelines de dados, avaliações, monitoramento, segurança, atualizações e reversões.
Principais conclusões
- Comece com uma tarefa mensurável, uma linha de base sem ML e limites de aceitação.
- Avalie os modelos candidatos em dados privados representativos, em vez de apenas pontuações de benchmarks públicos.
- Inclua custos de integração, latência, revisão, re-treinamento e incidentes no custo total de propriedade.
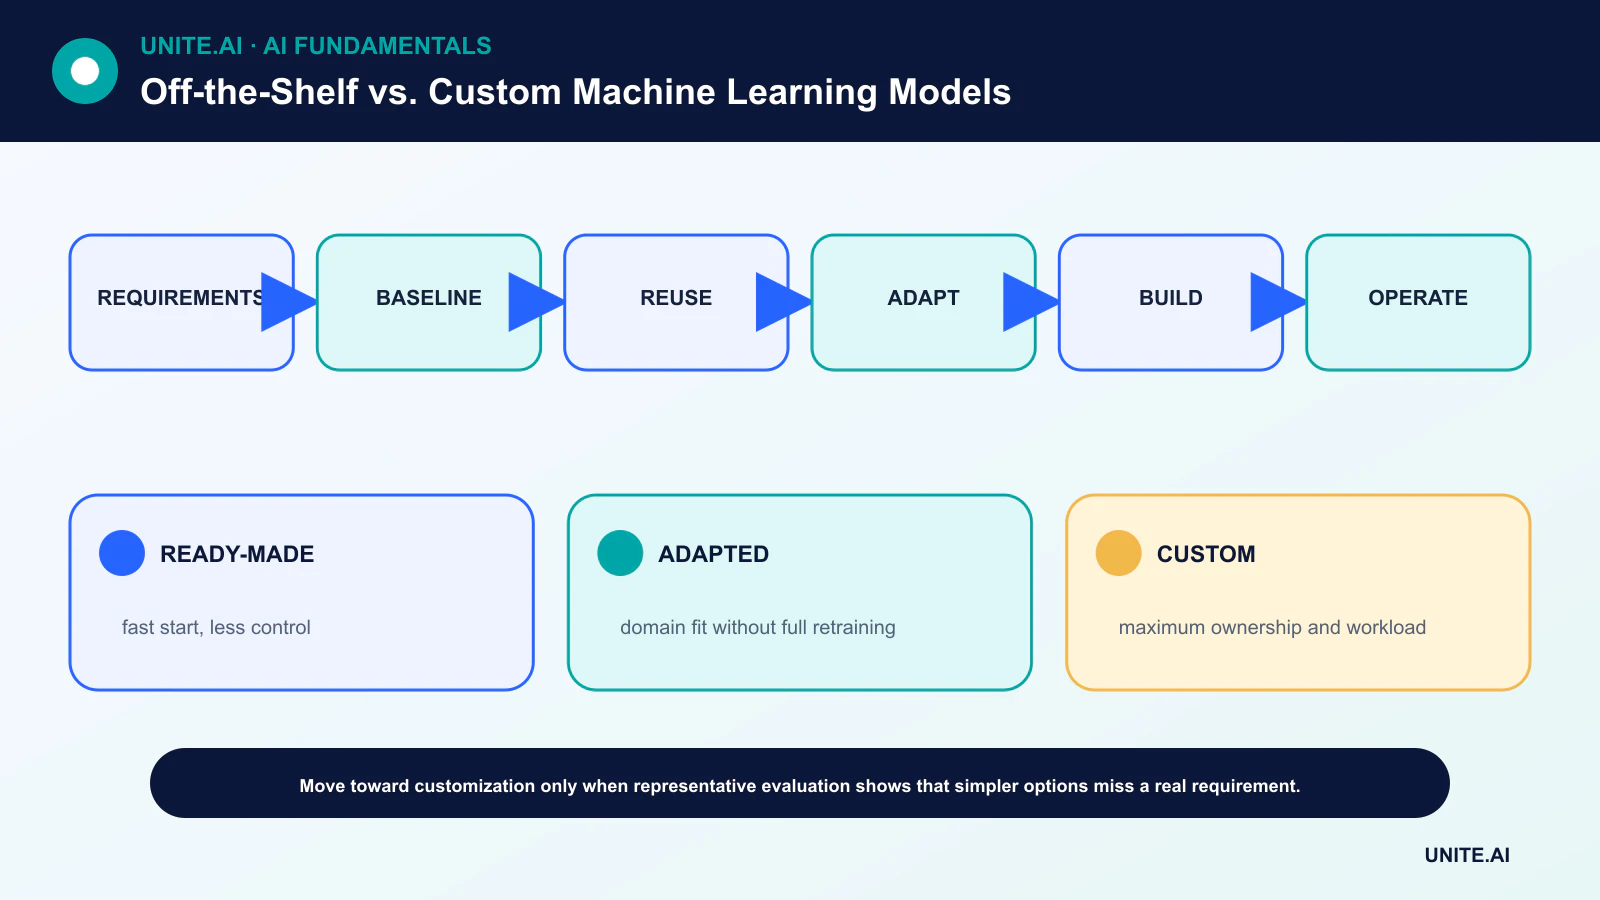
- Prefira estágios reversíveis: linha de base, recuperação ou prompting, ajuste fino, e então treine do zero somente quando as evidências sustentarem.
Defina a decisão antes de escolher um modelo
Especifique o usuário, a decisão, a entrada, a saída, os custos de erro, o orçamento de latência, o padrão de tráfego e o caminho de escalonamento. Determine se uma regra determinística ou um sistema de busca resolve parte suficiente do problema. As Regras de ML do Google recomendam linhas de base simples e infraestrutura confiável antes de modelagem complexa.
Crie um conjunto de avaliação offline que reflita a produção, incluindo casos raros e adversários. Quando decisões afetam pessoas, defina verificações de subgrupos e regras de revisão humana. Esses filtros tornam as comparações concretas em vez de transformar a escolha de arquitetura em preferência.
O continuum de reutilização e adaptação
Uma API hospedada oferece integração rápida e dimensionamento gerenciado, mas controle limitado sobre os internos do modelo, versões e manipulação de dados. Um modelo pré-treinado aberto aumenta o controle de implantação. Recuperação ou engenharia de prompts pode acrescentar contexto de domínio sem alterar os pesos.
Ajuste fino ou adaptadores eficientes em parâmetros podem especializar o comportamento. Treinar do zero só é justificado quando os dados, objetivo, escala ou exigência de propriedade não podem ser atendidos por meio da reutilização. Aprendizado por transferência costuma capturar a maior parte do valor com consideravelmente menos dados e computação.
Qualidade, controle e dependência
Meça a qualidade da tarefa, calibração, latência, taxa de transferência, disponibilidade e consistência de falhas. Um modelo de fornecedor pode melhorar automaticamente, mas também pode mudar o comportamento; um modelo auto-hospedado pode ser fixado, mas requer que a equipe gerencie atualizações e vulnerabilidades.
Os termos contratuais devem abordar retenção de dados, uso de treinamento, processamento regional, propriedade intelectual, níveis de serviço, caminhos de exportação e descontinuação. A portabilidade melhora quando a aplicação separa adaptadores específicos do modelo da lógica de negócios e armazena artefatos de avaliação reproduzíveis.
Privacidade, segurança e operações
Mapeie cada fluxo de dados e fronteira de ameaça. Entradas sensíveis podem exigir rede privada, inferência on-premises ou IA de borda. Auto-hospedagem não torna um sistema automaticamente seguro; ela transfere a responsabilidade de segurança e conformidade para o operador.
A propriedade da produção inclui observabilidade, verificações de desvio, monitoramento de abuso, resposta a incidentes e reversão. A equipe operacional deve ser capaz de responder qual modelo, prompt, versão de dados e política geraram um resultado.
Use evidências em etapas, não ideologia
Execute um benchmark com tempo limitado usando o mesmo conjunto de dados e critérios de aceitação entre as opções. Estime o tempo de engenharia, anotação, uso de aceleradores, taxas de fornecedor, trabalho de revisão, custos de falhas e a cadência esperada de mudanças.
Escolha o candidato mais simples que supere os filtros, e então reavalie conforme requisitos ou preços mudem. A personalização é valiosa quando produz benefício mensurável ou controle necessário — não apenas porque um modelo sob medida parece estrategicamente importante.
Requisitos e comparação de custo total
Um modelo pronto, API ou sistema empacotado oferece capacidade pré-construída com suporte do fornecedor e implantação inicial mais rápida. Um modelo personalizado é treinado ou substancialmente adaptado para uma tarefa específica, dados e ambiente operacional. A escolha começa com os requisitos: resultado alvo, qualidade por subgrupo e caso extremo, latência, taxa de transferência, disponibilidade, explicabilidade, residência de dados, controle de atualização, integração, segurança e consequência de falha. Um benchmark genérico ou demonstração não pode responder se um produto atende a esses requisitos.
O custo total inclui avaliação, preparação de dados, rotulagem, integração, licenças ou uso, infraestrutura, monitoramento, revisão, resposta a incidentes, atualizações e saída. Soluções prontas reduzem a engenharia inicial, mas podem gerar custos variáveis, dependência, mudanças de comportamento e observabilidade limitada. Desenvolvimento personalizado adiciona responsabilidade de dados e MLOps e ainda pode depender de pesos pré-treinados e fornecedores. O custo do modelo deve ser medido por tarefa bem-sucedida na qualidade requerida, não por token ou execução de treinamento isolada.
Avaliação, aquisição e adaptação
Construa um conjunto de teste privado representativo antes da seleção do fornecedor e execute cada candidato sob prompts idênticos, pré-processamento, limites e restrições operacionais. Inclua casos ambíguos, adversários, não suportados, multilíngues e de alta consequência. Meça precisão, calibração, latência, custo, recusa, segurança e impacto no fluxo de trabalho humano. Teste interrupções de API, limites de taxa, comportamento regional e mudança de versão. As alegações do fornecedor exigem documentação para treinamento, direitos, privacidade, retenção, subprocessadores, segurança, suporte e notificação de incidentes.
Opções de adaptação formam um espectro: configuração, recuperação, prompting, ajuste fino, atualizações eficientes em parâmetros, cabeçalhos personalizados ou treinamento do zero. Use o método menos complexo que atenda às evidências. Recuperação é apropriada para conhecimento que muda frequentemente; ajuste pode moldar formato ou comportamento de domínio; código determinístico deve lidar com regras exatas. Valide sistemas combinados porque um modelo base forte ainda pode falhar por recuperação inadequada, permissões ou integração.
Ciclo de vida e planejamento de saída
Produtos hospedados podem mudar ou desaparecer, enquanto modelos personalizados se tornam dívida técnica sem responsáveis. Dependências de versão, monitoramento de comportamento e resultados, definição de gatilhos de re-treinamento ou reavaliação, e manutenção de reversões. Preserve dados e interfaces necessários para migração, negocie exclusão e exportação, e evite expor o esquema proprietário de um fornecedor em toda a aplicação. A melhor escolha pode ser híbrida: capacidade comercial para tarefas de commodity e componentes personalizados onde desempenho de domínio, controle ou risco criam valor duradouro.
Exemplo prático: escolhendo um modelo de extração de documentos
Uma empresa cria um conjunto de teste privado de faturas de diversos fornecedores, idiomas, digitalizações, escrita manual e casos extremos, e então compara uma API gerenciada, modelo pré-treinado aberto, modelo adaptado e linha de base baseada em regras. Ela pontua precisão de campos, erro monetário, documentos não suportados, latência, taxa de transferência, privacidade, residência, integração e custo por fatura processada corretamente. Demonstrações de fornecedores e benchmarks públicos não substituem essa avaliação pareada.
O híbrido selecionado utiliza um serviço comercial de OCR com validação local e revisão humana para baixa confiança ou valores altos. Contratos definem retenção, subprocessadores, atualizações e exclusão; a arquitetura preserva arquivos fonte e um caminho de saída. Um período sombra detecta lacunas de esquema e fornecedor. O monitoramento separa OCR, extração, validação e correções do revisor. Se o comportamento do fornecedor mudar, a equipe pode congelar, trocar ou mover mais trabalho para seu componente personalizado sem reescrever o fluxo financeiro.
Evidência de implementação e prontidão operacional
Uma decisão de produção precisa de mais do que uma demonstração bem-sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entrada malformada ou ausente, mudança de distribuição, interrupção de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limite para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversões e aposentadoria. Use um rollout em etapas, preserve um fallback seguro e verifique o monitoramento com falhas inseridas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de procedimentos documentados de recuperação, aprendizado de incidentes, exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
Quando uma equipe deve treinar um modelo do zero?
Quando opções pré-treinadas ou hospedadas não podem atender aos requisitos validados e a equipe possui dados proprietários, capacidade computacional, expertise e capacidade operacional de longo prazo suficientes.
Um modelo pronto é livre de manutenção?
Não. Integração, avaliação, mudanças de versão, monitoramento, controles de privacidade e comportamento de fallback permanecem responsabilidade do adotante.
Referências principais











