
Fundamentos de IA
O que é uma Matriz de Confusão?

 Adicione Unite.AI às suas fontes preferidas no Google
Uma matriz de confusão é uma tabela que contabiliza com que frequência as previsões de um classificador concordam ou discordam dos rótulos conhecidos. Ela revela quais classes estão sendo confundidas e fornece as contagens usadas para calcular métricas como precisão, recall, especificidade e F1. É uma das principais ferramentas de diagnóstico para problemas de classificação de aprendizado supervisionado.
A própria matriz não é uma única pontuação de desempenho. É uma visão estruturada dos resultados em um determinado limiar de decisão, conjunto de dados e definição de classe.
Principais pontos
- Para classificação binária, os quatro resultados são verdadeiro positivo, falso positivo, falso negativo e verdadeiro negativo.
- Sempre rotule os eixos: bibliotecas e publicações nem sempre posicionam as classes reais e previstas na mesma orientação.
- A acurácia pode ocultar erros graves quando as classes são desequilibradas.
- Alterar o limiar de classificação altera a matriz de confusão e o trade‑off entre precisão e recall.
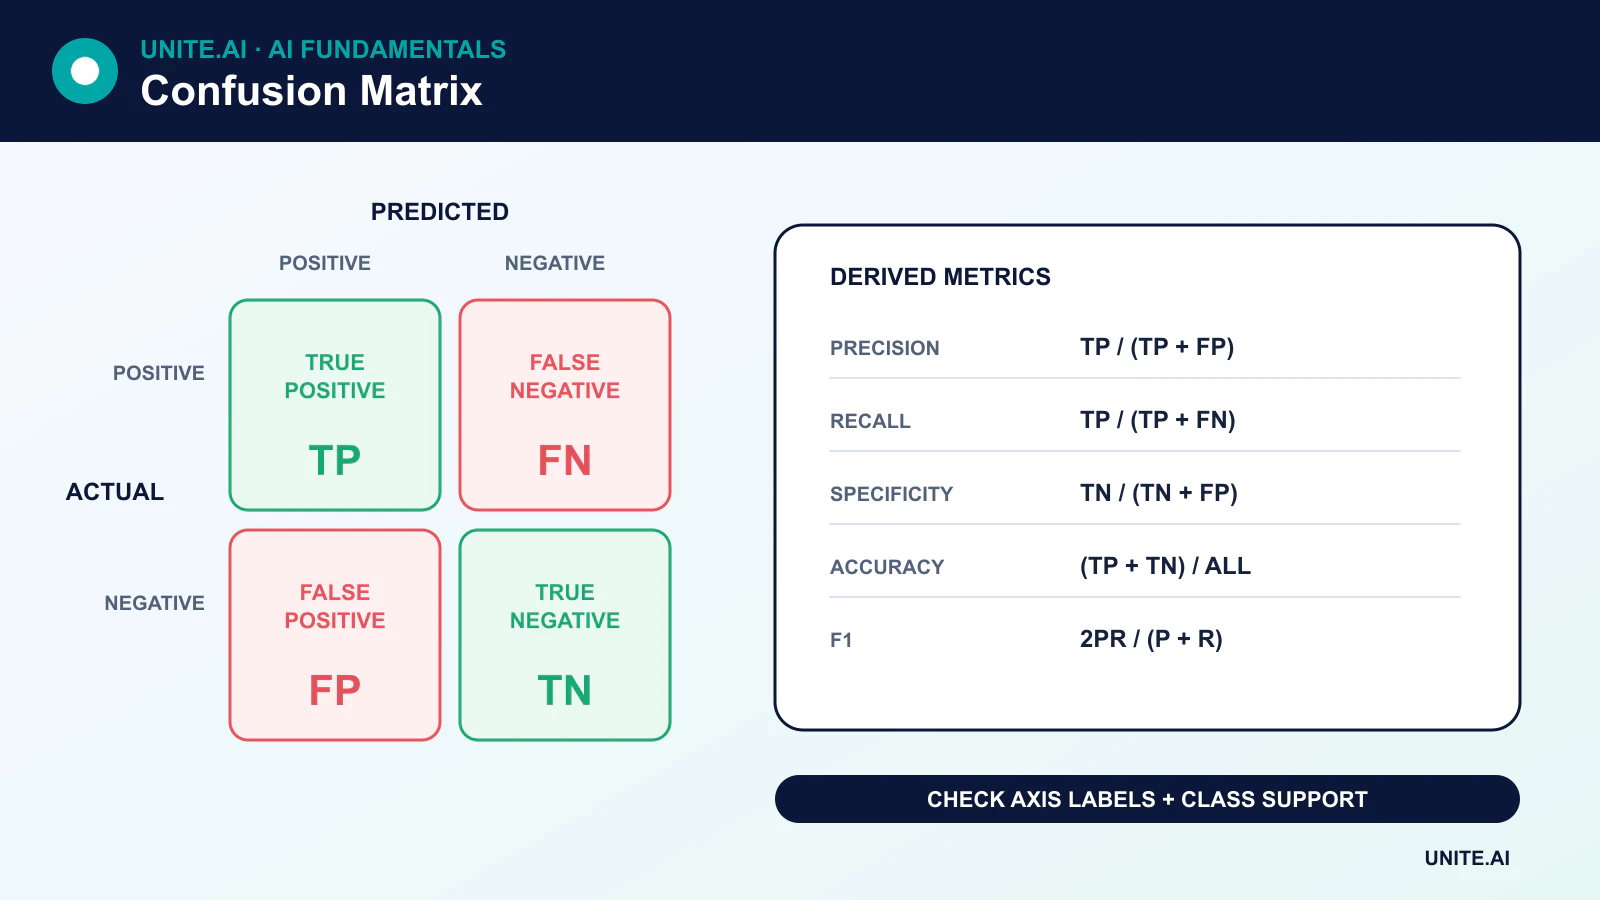
Os quatro resultados da classificação binária
- Verdadeiro positivo (TP): o exemplo é positivo e o modelo prevê positivo.
- Falso positivo (FP): o exemplo é negativo, mas o modelo prevê positivo.
- Falso negativo (FN): o exemplo é positivo, mas o modelo prevê negativo.
- Verdadeiro negativo (TN): o exemplo é negativo e o modelo prevê negativo.
Na convenção do scikit-learn, as linhas são as classes verdadeiras e as colunas são as classes previstas. Outras visualizações podem transpor essa disposição, portanto os rótulos — e não as posições dos cantos — devem orientar a interpretação.
Métricas derivadas de uma matriz de confusão
Precisão
Precision = TP / (TP + FP)
Precisão responde: entre os exemplos previstos como positivos, qual proporção era realmente positiva?
Recall ou sensibilidade
Recall = TP / (TP + FN)
Recall responde: entre todos os exemplos realmente positivos, qual proporção o modelo identificou? Na classificação binária, o recall da classe positiva também é chamado de sensibilidade ou taxa de verdadeiros positivos.
Especificidade
Specificity = TN / (TN + FP)
Especificidade é o recall para a classe negativa: entre os negativos reais, qual proporção o modelo rejeitou corretamente?
Acurácia
Accuracy = (TP + TN) / (TP + TN + FP + FN)
A acurácia é útil quando as classes e os custos de erro estão razoavelmente equilibrados. Pode ser enganosa quando uma classe domina.
Pontuação F1
F1 = 2 × (Precision × Recall) / (Precision + Recall)
O F1 resume a precisão e o recall com uma média harmônica. Ele ignora verdadeiros negativos, portanto não é o resumo adequado para todas as tarefas.
Um exemplo prático
Suponha que um conjunto de teste contenha 1.000 transações. Cinquenta são fraudulentas. Um modelo identifica 40 dessas fraudes, mas sinaliza 30 transações legítimas:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
O modelo tem 96% de acurácia, mas sua precisão é cerca de 57% e o recall é 80%. A alta acurácia é impulsionada principalmente pelas muitas transações legítimas. Se esse modelo é aceitável depende do custo da fraude não detectada, da capacidade de investigação e de quão calibradas estão suas pontuações de risco.
Os limiares alteram a matriz
Muitos classificadores produzem uma pontuação em vez de uma resposta obrigatória sim/não. Reduzir o limiar positivo geralmente aumenta o recall e os falsos positivos; aumentá‑lo geralmente eleva a precisão ou a especificidade, ao mesmo tempo que perde mais positivos. O limiar deve ser escolhido usando dados de validação e custos reais de erro, não fixado automaticamente em 0,5.
Curvas de precisão‑recall e ROC resumem o desempenho ao longo dos limiares. Curvas de precisão‑recall são frequentemente mais informativas quando a classe positiva é rara.
Matrizes de confusão multiclasse
Para K classes, a matriz é K × K. Previsões corretas ficam na diagonal; células fora da diagonal mostram quais pares de classes são confundidos. Métricas por classe podem ser médias de diferentes maneiras:
- Média macro: dá a cada classe peso igual.
- Média ponderada: pondera cada classe pelo número de exemplos.
- Média micro: agrega as contagens de resultados antes de calcular a métrica.
Reportar apenas uma média pode ocultar desempenho ruim em classes menores. Inclua contagens de suporte e resultados por classe onde as diferenças são relevantes.
Erros comuns
- Ler uma matriz transposta sem verificar os rótulos dos eixos.
- Calcular métricas a partir dos dados de treinamento em vez de um conjunto de validação adequado.
- Ignorar a prevalência das classes, a estratégia de amostragem ou entidades duplicadas entre as divisões.
- Comparar matrizes produzidas em diferentes limiares sem observar a mudança.
- Tratar todos os falsos positivos e falsos negativos como igualmente custosos.
Uma matriz de confusão é, portanto, uma ferramenta de diagnóstico, não uma avaliação completa. Calibração, análise de subgrupos, robustez e consequências subsequentes também fazem parte da revisão de classificação.
Lendo cada célula e derivando métricas úteis
Para classificação binária, a matriz de confusão conta verdadeiros positivos, falsos positivos, falsos negativos e verdadeiros negativos para uma classe positiva escolhida e um limiar. A acurácia divide as previsões corretas por todos os casos; a precisão pergunta qual fração dos positivos previstos estavam corretos; o recall pergunta qual fração dos positivos reais foram encontrados; a especificidade mede os negativos reais rejeitados corretamente. O F1 é a média harmônica da precisão e do recall. Nenhuma é intrinsecamente a melhor: triagem de fraude, triagem médica e filtragem de spam atribuem consequências diferentes às mesmas células.
Para problemas multiclasse, as linhas geralmente representam as classes reais e as colunas as classes previstas, embora as convenções variem, portanto os rótulos devem ser explícitos. Contagens um‑contra‑todos produzem precisão e recall por classe. A média macro pondera as classes igualmente; a média micro agrega decisões e favorece classes comuns; a média ponderada segue o suporte da classe. Tarefas multirrótulo permitem vários rótulos por item e exigem definições por rótulo ou por amostra. Normalizar por linha para inspecionar padrões de recall ou por coluna para inspecionar a composição das previsões, mas manter as contagens brutas para que grupos raros não sejam exagerados visualmente.
Limiar, incerteza e decisões operacionais
Uma matriz de confusão resume decisões rígidas em um limiar. Use curvas de precisão‑recall ou ROC para comparar limiares, então selecione um ponto de operação com base na capacidade, prevalência e custo de erro. Calibração verifica se as probabilidades previstas correspondem à frequência observada e é separada do ranking. Quando a prevalência muda, a precisão pode mudar mesmo que a sensibilidade e a especificidade permaneçam estáveis. Relate intervalos de confiança ou variação por bootstrap e evite tirar conclusões de poucos erros em um pequeno subgrupo.
Audite matrizes por tempo, local, dispositivo, idioma e grupos afetados relevantes para encontrar erros concentrados. Compare o modelo com o processo de decisão existente, incluindo revisão humana. Para cascatas, registre erros em cada estágio: recuperação, classificação, definição de limiar e ação. Monitore rótulos de resultados ao vivo com seu atraso e processo de correção. Um F1 aparentemente melhorado ainda pode aumentar falsos negativos prejudiciais ou exceder a capacidade de revisão. A matriz de confusão é um registro de decisão; conecte cada célula a quem experimenta o erro e qual resposta se segue.
Exemplo prático: selecionando um limiar de triagem médica
Um modelo de triagem de machine learning gera uma pontuação de risco para uma condição de baixa prevalência. A equipe cria matrizes de confusão em diferentes limiares e relata sensibilidade, especificidade, precisão, encaminhamentos falsos e casos perdidos com intervalos de confiança. Como o valor preditivo positivo depende da prevalência, ele modela a população pretendida em vez de citar a precisão de um único conjunto de dados. Os resultados são segmentados por dispositivo, local, idade, sexo e outros grupos clinicamente justificados.
Os clínicos escolhem um ponto de operação que mantém a sensibilidade necessária sem sobrecarregar os testes confirmatórios. A matriz é convertida em contagens esperadas por 10.000 pessoas triadas para que as consequências sejam compreensíveis. Pontuações fora das condições validadas não produzem conclusão automática. O monitoramento compara previsões com diagnósticos confirmados com atraso, acompanha capacidade e calibração, e aciona revisão quando a prevalência ou a aquisição mudam. A matriz de confusão permanece vinculada ao modelo exato, ao limiar e à população.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, o ambiente operacional, entradas, saídas, dependências, proprietário e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes de ajustar. Teste casos comuns, condições de fronteira, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e aposentadoria. Use um lançamento em fases, preserve um fallback seguro e verifique o monitoramento com falhas deliberadamente injetadas. A telemetria operacional deve revelar a qualidade das entradas, o comportamento das saídas, a versão do modelo ou regra, a saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
O que é uma matriz de confusão normalizada?
A normalização divide as contagens pelo total da classe verdadeira, total da classe prevista ou por todas as observações. Ela facilita a comparação de taxas entre classes, mas o relatório também deve manter as contagens brutas de suporte para que pequenos grupos não sejam confundidos com grupos de tamanho equivalente.
Uma matriz de confusão pode avaliar regressão?
Não diretamente. Uma matriz de confusão requer classes discretas. Agrupar um alvo contínuo descarta informações; a regressão normalmente deve usar análise de resíduos e métricas projetadas para valores contínuos, como MAE ou RMSE.
Referências principais












