
Fundamentos de IA
O que é KNN (K-Vizinhos Mais Próximos)?

 Adicione Unite.AI às suas fontes preferidas no Google
K-nearest neighbors (KNN) prevê um resultado a partir dos exemplos de treinamento rotulados mais próximos de um ponto de consulta. Para classificação, os vizinhos votam na classe. Para regressão, seus valores‑alvo são medidos ou combinados de outra forma.
KNN é um método baseado em instâncias, não generalizante: o ajuste basicamente armazena os exemplos de treinamento e um índice de busca opcional. Isso não elimina a necessidade de divisões de treinamento, validação e teste. Avaliar em dados reservados é essencial para escolher k, a métrica de distância, o processamento de atributos e a regra de votação.
Principais conclusões
- KNN faz previsões localmente; não divide o conjunto de dados em clusters primeiro.
- Escalonamento de atributos é crítico porque a distância define quais exemplos são considerados vizinhos.
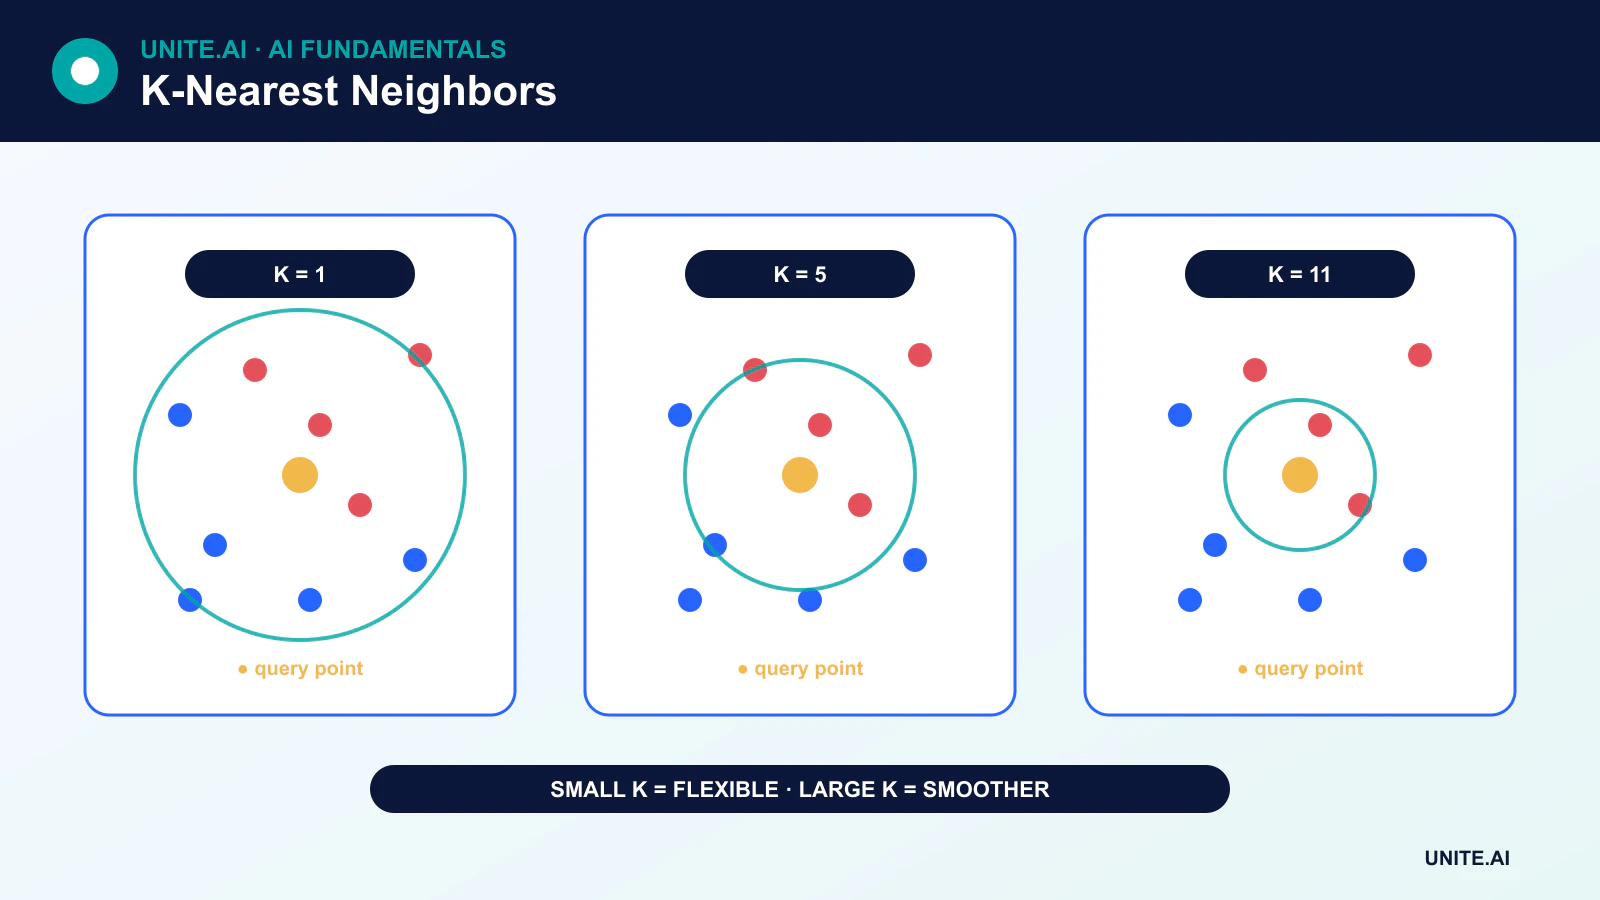
- Um k pequeno pode ser ruidoso, enquanto um k grande pode suavizar a estrutura local.
- Altas dimensões, atributos irrelevantes, desequilíbrio de classes e busca lenta podem limitar o desempenho.
Como funciona a classificação KNN
- Representar a consulta e os exemplos de treinamento no mesmo espaço de atributos.
- Calcular a distância da consulta para os exemplos de treinamento.
- Selecionar os k exemplos mais próximos.
- Prever a classe majoritária ou usar votação ponderada pela distância.
A votação ponderada confere mais influência aos vizinhos mais próximos. Empates requerem uma regra documentada, e vizinhos a igual distância com rótulos diferentes podem fazer os resultados dependerem da ordem ou de detalhes de implementação.
Regressão KNN
Para regressão, a previsão costuma ser a média dos alvos vizinhos. O ponderamento por distância pode reduzir a influência de observações mais distantes. A mediana ou agregação robusta pode ser útil quando os alvos locais contêm outliers.
Métricas de distância
A distância euclidiana é comum para atributos contínuos, a distância de Manhattan soma diferenças absolutas e a distância cosseno foca na direção em vez da magnitude. Outras métricas são aplicáveis a dados binários, categóricos, geográficos, sequenciais ou de embeddings aprendidos.
Chamar KNN de “não paramétrico” significa que ele não assume uma forma funcional fixa de dimensão finita para a fronteira de decisão. Ainda assim, assume que a representação e a métrica selecionadas tornam os pontos próximos relevantes entre si.
Por que o escalonamento importa
Se um atributo varia de 0 a 1 e outro de 0 a 100 000, a distância euclidiana padrão será dominada pelo segundo atributo. Padronização, normalização ou transformações específicas de domínio devem ser ajustadas na partição de treinamento e aplicadas à validação, teste e dados de produção.
Atributos irrelevantes também distorcem as vizinhanças. Seleção de atributos, redução de dimensionalidade ou representações aprendidas podem ajudar, mas cada escolha deve ser validada sem vazamento de dados.
Escolhendo k
Com k = 1, o modelo pode seguir ruído e exemplos rotulados incorretamente. À medida que k aumenta, as previsões tornam‑se mais suaves e menos sensíveis a um ponto. Se k ficar muito grande, classes ou regiões distantes dominam e o modelo subajusta.
Escolha k por validação cruzada nos dados de treinamento. Para classificação binária, um k ímpar reduz, mas não elimina, empates. Pesos de classe, divisões estratificadas, escolha de limiar e métricas adequadas são importantes quando as classes estão desequilibradas.
A maldição da dimensionalidade
Em espaços de alta dimensionalidade, as distâncias podem tornar‑se menos informativas porque os exemplos são escassos e as distâncias mais próximas e mais distantes tornam‑se relativamente semelhantes. KNN pode exigir enormes quantidades de dados para manter vizinhanças locais significativas. Isso é a maldição da dimensionalidade.
Redução de dimensionalidade ou embeddings específicos da tarefa podem ajudar, mas a geometria de um embedding deve ser validada para a noção de similaridade pretendida.
Desempenho da busca
Uma consulta por força bruta compara o novo ponto com cada exemplo armazenado. Árvores KD e árvores de bola aceleram algumas buscas exatas, embora seus benefícios diminuam em altas dimensões. Índices de vizinhos mais próximos aproximados trocam uma pequena perda de recall por grandes ganhos de velocidade e memória. Essa ideia também sustenta a busca por similaridade vetorial.
Vantagens e limitações
KNN é simples, suporta fronteiras de decisão irregulares e fornece uma explicação intuitiva baseada em exemplos. Também pode exigir memória considerável, expor exemplos de treinamento sensíveis, prever lentamente e ter desempenho ruim quando a distância não é significativa. É uma linha de base útil — não um método altamente preciso na maioria dos problemas por padrão.
Distância, vizinhanças e comportamento de hiperparâmetros
K-nearest neighbors armazena exemplos de treinamento e prevê a partir dos k mais próximos sob uma distância escolhida. A classificação usa voto majoritário ou ponderado por distância; a regressão faz a média dos alvos vizinhos. O escalonamento é essencial porque um atributo de grande amplitude pode dominar a distância euclidiana. Dados categóricos, esparsos, sequenciais ou geográficos podem exigir distâncias Hamming, cosseno, de edição, de grande círculo ou aprendidas. A métrica é uma suposição de modelagem sobre similaridade e deve ser validada em relação ao significado real de casos próximos.
Um k pequeno cria fronteiras flexíveis, de alta variância e sensíveis ao ruído; um k grande suaviza as previsões e pode eliminar estruturas de minoria. Um k ímpar apenas evita alguns empates binários e não é uma regra geral. Escolha k, distância, ponderação, conjunto de atributos e pré‑processamento dentro da validação cruzada. O desequilíbrio de classes pode fazer o voto majoritário local ignorar resultados raros, portanto inspecione o recall por classe e a composição da vizinhança. Distâncias em alta dimensionalidade tendem a concentrar‑se, e atributos irrelevantes degradam as vizinhanças; seleção, redução de dimensionalidade ou embeddings aprendidos podem ajudar.
Indexação, incerteza e operação em produção
A inferência ingênua compara uma consulta com todos os pontos de treinamento. Árvores KD e árvores de bola ajudam em baixas dimensões adequadas; índices de vizinhos mais próximos aproximados trocam exatidão por velocidade e escala. Meça o recall da busca de vizinhos separadamente da qualidade preditiva. A memória inclui atributos armazenados, rótulos e estruturas de índice. Atualizações são conceitualmente simples, mas podem exigir reconstrução de índices, consistência de versão e propagação de exclusões. Proteja exemplos de treinamento sensíveis, pois devolver vizinhos ou distâncias pode expor registros.
KNN pode apresentar exemplos que tornam uma previsão compreensível, mas proximidade não é causalidade ou justiça. Forneça a distância, a margem de voto e uma regra de abstenção quando as vizinhanças são escassas ou conflitantes. Monitore a distância da consulta, os rótulos dos vizinhos, deriva de atributos, latência e resultados confirmados. Mantenha versões de pré‑processamento e de índice sincronizadas e teste resultados exatos versus aproximados após alterações. KNN é uma linha de base local eficaz e método de recuperação quando a distância é significativa; tem dificuldades quando a similaridade não pode ser representada pelos atributos disponíveis.
Exemplo prático: KNN para substituição de produtos
Um varejista representa produtos com atributos numéricos padronizados, compatibilidade categórica e um embedding textual aprendido, definindo então uma distância ponderada revisada pelos merchandisers. K e os pesos são selecionados usando lançamentos de produtos posteriores, não linhas de itens aleatórias. A avaliação verifica recall de substitutos relevantes, recomendações incompatíveis, distância, cobertura de categorias e resultados para itens raros. Uma linha de base de popularidade mostra se a similaridade local agrega valor.
Um índice aproximado é comparado a vizinhos exatos para medir recall e latência. Consultas sem item compatível próximo retornam nenhuma sugestão em vez de um vizinho forçado. Exclusões de produtos e correções de atributos são propagadas ao índice por meio de atualizações versionadas. O monitoramento acompanha distribuições de distância, resultados vazios, sobreposições e resultados comerciais sem confundir vendas com verdadeira compatibilidade. Termos sensíveis de fornecedores são excluídos das explicações, e os exemplos retornados permanecem evidência de similaridade — não uma afirmação de que os produtos são equivalentes.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais que uma demonstração bem‑sucedida. Defina os usuários pretendidos, o ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de limite, entrada malformada ou ausente, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre toda transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e aposentadoria. Use um rollout em fases, preserve um fallback seguro e verifique o monitoramento com falhas inseridas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, o comportamento da saída, a versão do modelo ou regra, a saúde das dependências, intervenções humanas e os resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, depois analise evidências do mundo real após a implantação em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
O KNN tem uma fase de treinamento?
Ele tem pouco ajuste de parâmetros, mas ainda possui um processo de desenvolvimento: o pré‑processamento é aprendido a partir dos dados de treinamento, um índice pode ser construído, e k, métrica, pesos e atributos são selecionados com validação.
O KNN é o mesmo que K-means?
Não. KNN é principalmente um método supervisionado de predição local. K-means é um algoritmo de agrupamento não supervisionado no qual K é o número de centros de clusters.
Referências principais












