
Fundamentos de IA
O que é Regressão Linear?

 Adicione Unite.AI às suas fontes preferidas no Google
Regressão linear modela um alvo contínuo como uma combinação linear de uma ou mais características de entrada. É usada para predição, estimativa e como uma linha de base transparente para entender se um modelo mais complexo acrescenta valor significativo.
Os termos variável independente e variável dependente descrevem papéis no modelo, não causa e efeito comprovados. Uma regressão pode identificar uma associação enquanto confundimento, viés de seleção, causalidade reversa ou erro de medição explicam a relação.
Principais pontos
- O alvo y é modelado a partir das características de entrada X; a versão anterior do artigo inverteu esses rótulos em uma explicação de fórmula.
- Os mínimos quadrados ordinários minimizam a soma dos resíduos ao quadrado.
- Diagnósticos de resíduos e suposições são importantes para inferência e incerteza.
- A regularização ridge e lasso ajudam quando os preditores são numerosos ou correlacionados.
Regressão linear simples
Com uma característica, o modelo é:
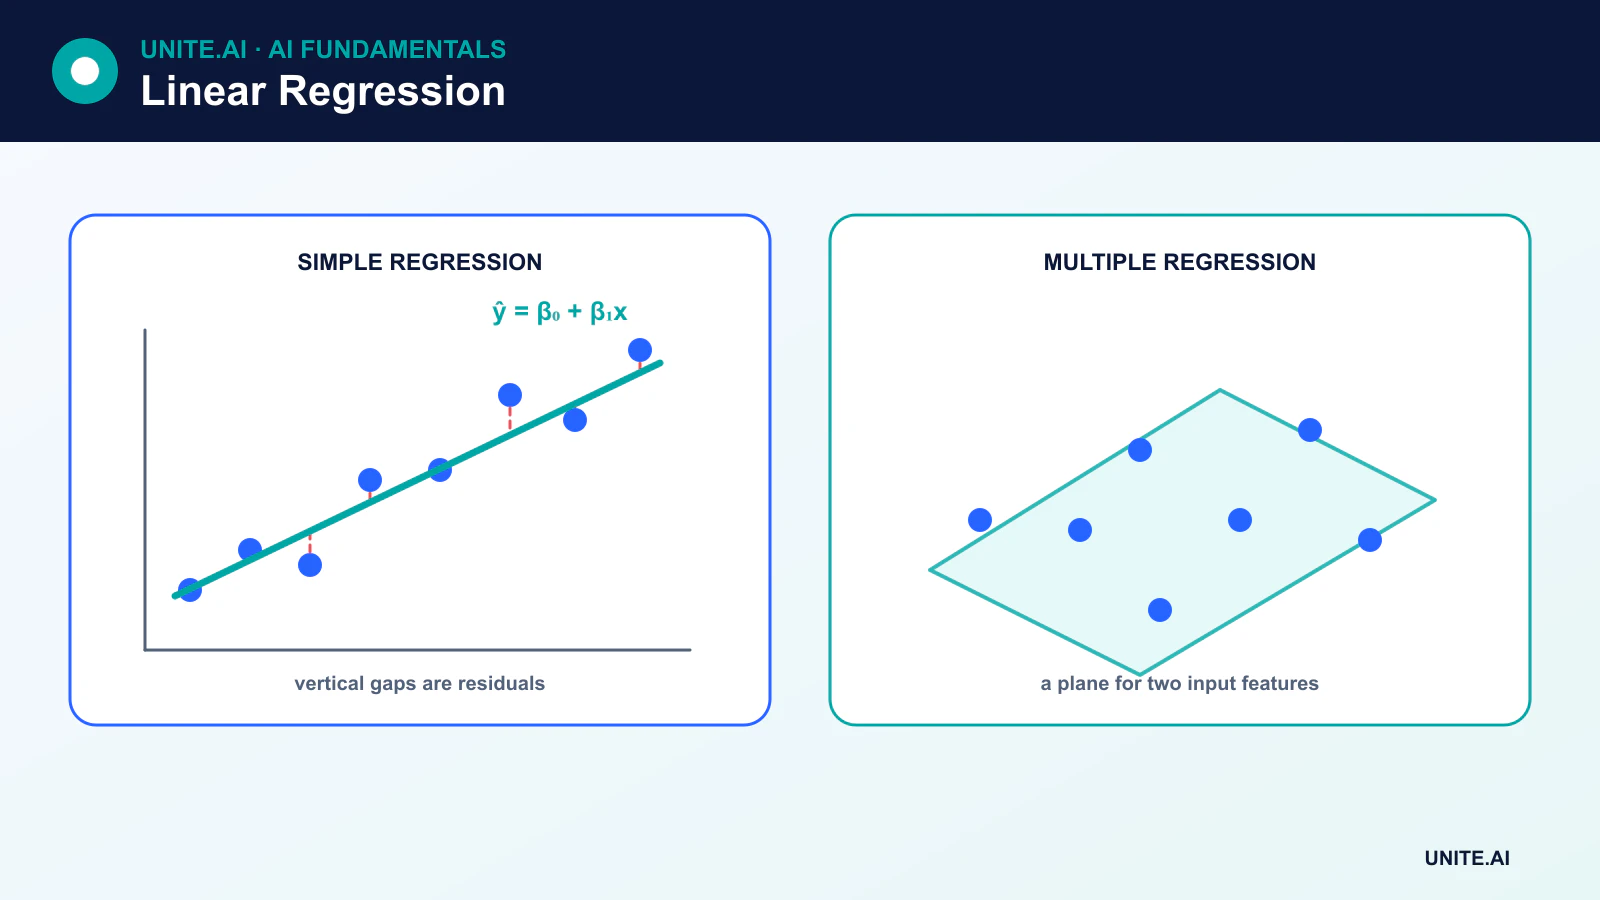
ŷ = β₀ + β₁x
β₀ é o intercepto e β₁ é a inclinação. O resíduo para a observação i é yᵢ - ŷᵢ. Os mínimos quadrados ordinários (OLS) escolhem coeficientes que minimizam a soma dos resíduos ao quadrado.
A inclinação estima a mudança esperada no alvo associada a uma variação de uma unidade na característica sob o modelo ajustado. Não deve ser descrita como um efeito causal a menos que o desenho do estudo e as suposições suportem a identificação causal.
Regressão linear múltipla
Com p características:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
Cada coeficiente é interpretado condicionalmente às demais características incluídas. A regressão múltipla pode incorporar variáveis categóricas por meio de codificação, termos polinomiais e interações. Ela continua “linear” porque é linear nos coeficientes, mesmo que características transformadas como x² sejam incluídas.
Suposições e diagnósticos
Para predição, a questão central é quão bem o modelo generaliza. Para testes e intervalos de coeficientes clássicos, suposições adicionais tornam‑se importantes:
- Linearidade: a média condicional é representada pela forma linear escolhida.
- Erros independentes ou modelados corretamente: observações repetidas, agrupadas, espaciais ou em séries temporais podem exigir uma estrutura de erro diferente.
- Variância constante dos erros: a heterocedasticidade afeta os erros padrão e as estimativas de incerteza.
- Multicolinearidade limitada: preditores fortemente correlacionados tornam os coeficientes individuais instáveis.
- Distribuição dos resíduos: a normalidade é relevante para algumas inferências com amostras pequenas, não sendo uma exigência de que cada característica seja normalmente distribuída.
Gráficos de resíduos, medidas de alavancagem e influência, e revisão de domínio podem identificar outliers, não linearidade, variância variável ou observações que dominam o ajuste.
Avaliando previsões
- Erro absoluto médio (MAE) calcula a média do tamanho absoluto dos resíduos.
- Erro quadrático médio (MSE) dá mais peso a erros maiores.
- Raiz do erro quadrático médio (RMSE) devolve o erro ao quadrado para as unidades do alvo.
- R² compara a variação residual com uma linha de base constante nos dados avaliados.
R² não representa acurácia, não estabelece causalidade e pode ser negativo em dados de teste. A validação deve corresponder ao cenário real de predição, incluindo divisões por tempo ou grupos quando necessário.
Ridge, lasso e elastic net
Regressão ridge adiciona uma penalidade L2 que reduz os coeficientes e estabiliza preditores correlacionados. Lasso adiciona uma penalidade L1 e pode definir coeficientes como zero. Elastic net combina ambas. As características geralmente precisam de escala compatível antes que essas penalidades sejam comparadas.
A regularização introduz viés em troca de menor variância e pode reduzir o overfitting. A força da penalidade é selecionada por validação, não pelo conjunto de teste final.
Quando a regressão linear é a ferramenta inadequada
Um modelo linear pode falhar quando as relações são fortemente não lineares, os erros dependem de valores passados, as distribuições do alvo requerem modelagem especializada, ou alguns outliers dominam a perda quadrática. Árvores de decisão, modelos lineares generalizados, modelos de séries temporais, regressão robusta ou métodos não lineares podem se ajustar melhor.
Mesmo quando um modelo complexo se sobressai, a regressão linear continua sendo uma linha de base valiosa. Se um grande sistema não consegue superá‑la de forma confiável, a complexidade adicional pode não ser justificada.
Suposições do modelo, estimação e diagnósticos
Regressão linear modela a média condicional de um resultado numérico como um intercepto mais preditores ponderados. Os mínimos quadrados ordinários escolhem coeficientes que minimizam os resíduos ao quadrado. Os coeficientes descrevem a mudança esperada no resultado para uma variação de uma unidade no preditor enquanto as demais variáveis incluídas permanecem constantes, sob o modelo especificado. Isto é uma associação a menos que suposições de identificação causal e o desenho do estudo justifiquem mais. Unidades, codificação, transformações, interações e categorias de referência determinam a interpretação, de modo que coeficientes sem um dicionário de dados são incompletos.
A inferência clássica depende de suposições sobre a forma funcional, erros independentes, variância constante e distribuição dos erros para testes e intervalos específicos. Gráficos residual versus ajustado revelam não linearidade ou heterocedasticidade; gráficos Q–Q avaliam o comportamento das caudas; diagnósticos de alavancagem e influência identificam observações que afetam fortemente as estimativas. Preditores correlacionados inflacionam a incerteza e tornam os coeficientes individuais instáveis mesmo quando as previsões permanecem adequadas. Erros padrão robustos, transformações, splines, estrutura hierárquica ou outro modelo podem ser necessários em vez de excluir pontos de dados inconvenientes.
Regularização, avaliação e uso responsável
A regressão ridge reduz os coeficientes com uma penalidade L2, enquanto o lasso pode zerar alguns com penalidade L1; o elastic net combina ambos. Padronize os preditores quando a escala da penalidade deve ser comparável e escolha a força usando validação ou validação cruzada. Avalie erro absoluto médio, raiz do erro quadrático médio, distribuição dos resíduos, calibração em diferentes faixas e incerteza, com divisões por tempo ou grupos que reflitam o uso. Compare com uma linha de base média e alternativas não lineares, mas mantenha modelos lineares quando transparência e estabilidade são valiosas.
A extrapolação além da faixa observada dos preditores segue a linha ajustada sem evidência e pode ser perigosa. Monitore faixas de características, valores ausentes, resíduos e erro de subgrupos em produção. Intervalos de predição descrevem a incerteza de resultados individuais e são mais amplos que intervalos de confiança para a média; ambos requerem suposições. Evite controlar variáveis que introduzam viés causal quando o objetivo é estimar efeitos. A regressão linear é uma ferramenta precisa para uma relação definida, não uma garantia universal de que o mundo é linear ou de que um coeficiente representa uma intervenção.
Exemplo prático: estimando o tempo de entrega
Uma equipe de logística modela a duração da entrega a partir da distância, nível de serviço, região, dia da semana e condições climáticas conhecidas. Ela inspeciona padrões não lineares nos resíduos e adiciona splines e interações justificadas, em vez de tratar a equação linear como física literal. Grupos de transportadora e rota definem as divisões de validação. Erro absoluto médio, erro de cauda, cobertura de intervalos e viés sistemático são relatados. Entregas canceladas e dados registrados após a chegada são excluídos ou modelados explicitamente.
Os coeficientes são documentados em unidades e verificados quanto à instabilidade sob preditores correlacionados. O modelo rejeita extrapolação além das faixas de distância e região validadas. Intervalos de predição acompanham as estimativas, e o agendamento subsequente usa sua incerteza. O monitoramento acompanha faixas de características, resíduos, cobertura de intervalos e viés após mudanças na rede. Nenhuma afirmação causal sobre transportadora ou clima é feita a partir de coeficientes preditivos; experimentos operacionais ou identificação mais robusta seriam necessários para sustentar uma intervenção.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de limite, entrada malformada ou ausente, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa junto com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre toda transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e aposentadoria. Use um rollout em etapas, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade das entradas, comportamento das saídas, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
A regressão linear requer apenas uma variável de entrada?
Não. A regressão simples tem um preditor, enquanto a regressão linear múltipla pode usar muitas características numéricas, categóricas codificadas, transformadas e de interação.
A regressão linear pode provar causalidade?
Não. Interpretação causal requer um desenho de pesquisa defensável e suposições sobre confundimento, seleção, medição e intervenção. Um coeficiente preditivo sozinho descreve uma associação no modelo ajustado.
Referências principais












