
Fundamentos de IA
O que são Máquinas de Vetor de Suporte?

 Adicione Unite.AI às suas fontes preferidas no Google
Uma máquina de vetor de suporte (SVM) é um método de aprendizado supervisionado que encontra uma fronteira de decisão com a maior margem possível entre as classes. Os exemplos de treinamento que determinam essa fronteira são os vetores de suporte.
As SVMs podem realizar classificação linear ou não linear, regressão e detecção de novidades. Elas são especialmente úteis para conjuntos de dados pequenos a médios com características informativas, incluindo dados esparsos de alta dimensão, mas o custo de treinamento pode tornar-se impraticável em conjuntos de dados muito grandes.
Principais pontos
- Uma SVM maximiza a margem mínima entre a fronteira e os pontos de treinamento mais próximos.
- Vetores de suporte são pontos de dados, não hiperplanos adicionais.
- O parâmetro C equilibra a largura da margem com penalidades por violações.
- Kernels calculam similaridade em um espaço de características implícito sem materializar explicitamente cada característica transformada.
A ideia da margem máxima
Para um classificador binário linear, a fronteira de decisão é um hiperplano:
w · x + b = 0
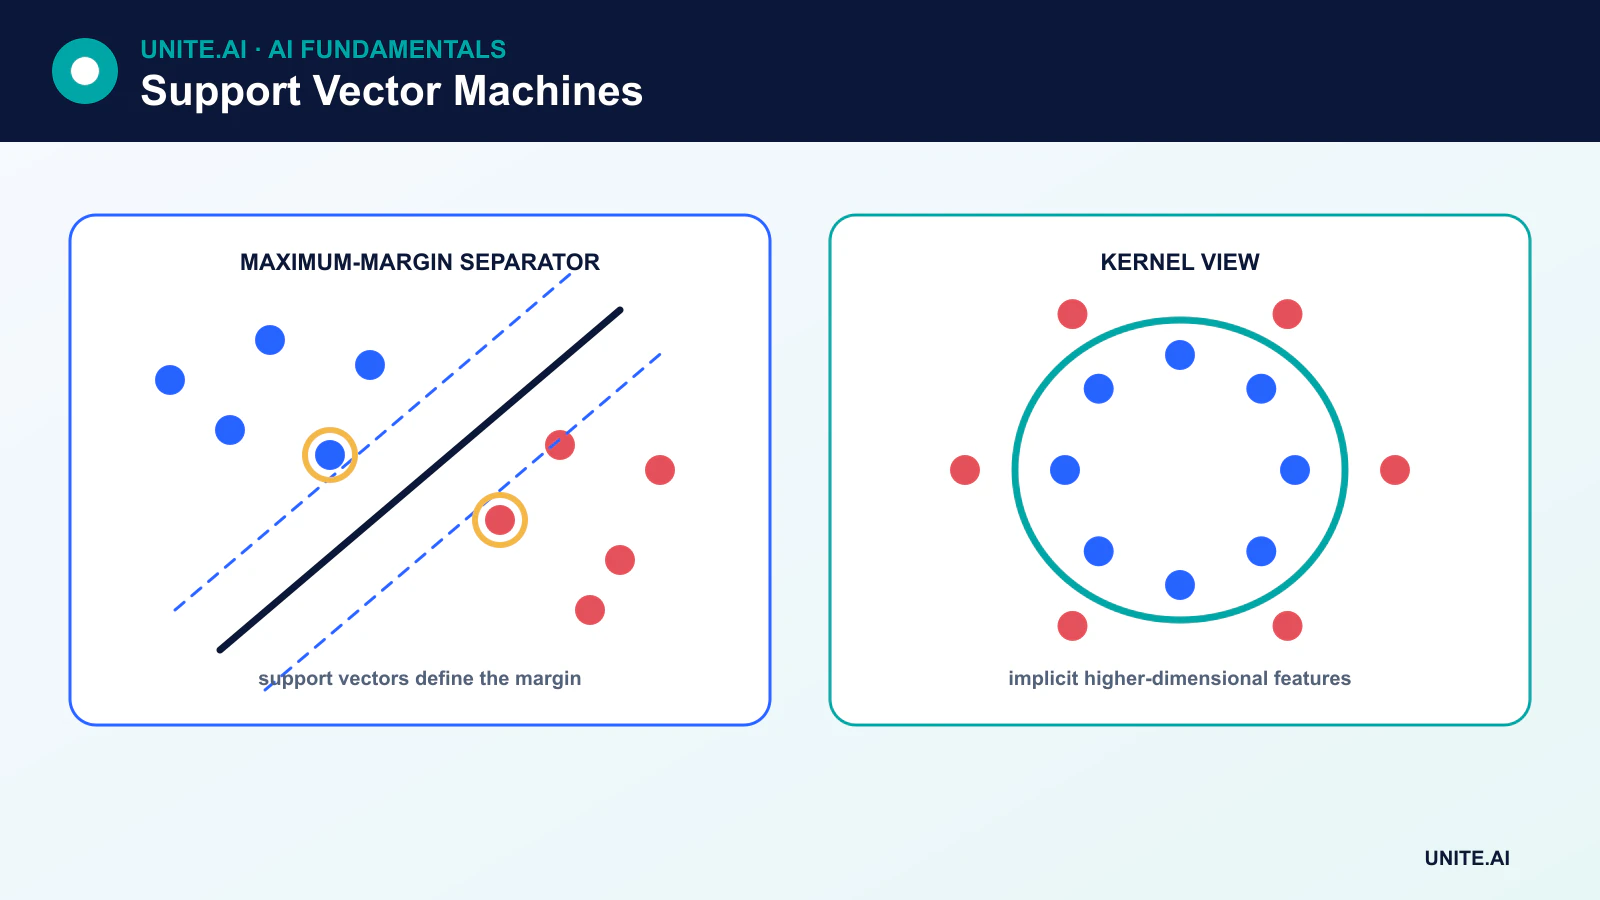
O vetor w determina a orientação e b o deslocamento. Muitos hiperplanos podem separar as classes de treinamento. A SVM escolhe aquele que maximiza a distância para os exemplos mais próximos em ambos os lados. Esses exemplos mais próximos são os vetores de suporte e têm a maior influência sobre a fronteira ajustada.
O objetivo não é maximizar a distância da fronteira a cada ponto individualmente. Ele maximiza a margem mínima enquanto satisfaz ou penaliza as restrições de classe.
Margens rígidas e suaves
Uma SVM de margem rígida requer separação linear perfeita e é sensível a outliers. Conjuntos de dados reais geralmente precisam de uma margem suave, que introduz variáveis de folga para observações dentro da margem ou do lado errado da fronteira.
O hiperparâmetro C controla a penalidade para essas violações:
- Um C maior penaliza as violações de forma mais forte e costuma produzir uma margem mais estreita que segue os exemplos de treinamento mais de perto.
- Um C menor permite mais violações em troca de uma margem mais larga e mais regularizada.
O número de vetores de suporte resulta dos dados e da solução; aumentar C não garante uma quantidade específica de vetores de suporte.
O truque do kernel
Algumas classes não podem ser separadas com um hiperplano reto no espaço de características original. Um kernel avalia um produto interno correspondente a outro espaço de características. Isso permite que a SVM ajuste uma fronteira não linear sem calcular explicitamente cada coordenada transformada.
Kernels comuns incluem:
- Linear: eficiente para características esparsas de alta dimensão, como texto.
- Polinomial: modela interações até um grau escolhido.
- Função de base radial (RBF): cria fronteiras locais flexíveis baseadas em distância.
- Sigmoid: assemelha‑se a uma ativação neural, mas raramente é a escolha padrão.
Para uma SVM RBF, gamma controla o quão localmente cada exemplo de treinamento influencia a fronteira. Um gamma grande pode criar regiões altamente detalhadas e sobreajustar; um gamma pequeno produz influência mais suave.
Classificação multiclasse
O objetivo clássico da SVM é binário. Bibliotecas o estendem usando estratégias como one-vs-rest, que treina um classificador por classe, ou one-vs-one, que treina classificadores para pares de classes e combina suas decisões. SVMs multiclasse não simplesmente desenham uma linha a menos que o número de classes.
Regressão de vetor de suporte e SVM de classe única
A regressão de vetor de suporte (SVR) ajusta uma função ignorando erros dentro de um tubo de largura epsilon e penalizando desvios maiores. Uma SVM de classe única estima uma fronteira ao redor de dados típicos e pode suportar detecção de novidades. Um ponto incomum não é automaticamente fraude ou falha; ele é incomum sob a representação ajustada.
Requisitos práticos
As SVMs dependem de distâncias e produtos internos, portanto características numéricas geralmente precisam de escalonamento. C, kernel, gamma e pesos de classe devem ser selecionados por validação. Estimativas de probabilidade não são inerentes à margem e frequentemente requerem calibração, o que adiciona custo e deve ser avaliado separadamente.
O treinamento de SVM com kernel pode escalar entre tempo quadrático e cúbico em relação ao número de amostras, dependendo dos dados e da implementação. Variantes lineares de SVM ou modelos lineares estocásticos são mais adequados para conjuntos de dados muito grandes. Para imagens, áudio ou linguagem brutos, representações aprendidas por deep learning podem ser mais eficazes, enquanto uma SVM ainda pode classificar um embedding fixo.
Vantagens e limitações das SVMs
As SVMs podem funcionar bem com muitas características, oferecem um objetivo regularizado claro e dependem principalmente dos vetores de suporte no momento da predição. As limitações incluem sensibilidade ao escalonamento e aos hiperparâmetros, treinamento potencialmente caro, interpretabilidade reduzida sob kernels não lineares e requisitos de calibração de probabilidade.
Margens, kernels e o objetivo de otimização
Uma máquina de vetor de suporte busca um hiperplano separador com uma grande margem entre as classes. Apenas vetores de suporte na margem ou dentro dela determinam a fronteira. SVMs de margem suave introduzem folga para sobreposição e pontos rotulados incorretamente; o parâmetro C troca uma margem mais ampla por violações no treinamento. As entradas geralmente devem ser escalonadas porque distância e produtos internos conduzem a solução. Pesos de classe ou reamostragem ajudam quando os custos de erro e a prevalência são desiguais, mas limiares e probabilidades ainda precisam de validação independente.
O truque do kernel avalia similaridade como se as entradas fossem mapeadas para um espaço de características de dimensão superior. Kernels lineares, polinomiais, de base radial e especializados codificam diferentes suposições. Para um kernel RBF, gamma controla o quão localmente cada ponto influencia a fronteira: gamma alto pode criar regiões intrincadas e sobreajustar, enquanto gamma baixo pode subajustar. Matrizes de kernel crescem quadraticamente com o número de amostras, tornando SVMs não lineares caras em grandes conjuntos de dados. Solvers lineares ou mapas de características aproximados são frequentemente preferíveis em escala.
Uso multiclasse, calibração e limites operacionais
SVMs binárias são estendidas para multiclasse através de one-vs-rest, one-vs-one ou formulações estruturadas. Hiperparâmetros devem ser ajustados dentro de validação cruzada, com divisões agrupadas ou temporais quando necessário. Avalie precisão e recall específicos por classe, distribuições de margem, calibração e desempenho sob mudança de distribuição. Pontuações de decisão brutas não são probabilidades; escalonamento de Platt ou calibração isotônica usam dados separados e podem degradar se a prevalência mudar. Compare com regressão logística, árvores e métodos modernos baseados em representações com pré‑processamento e esforço de ajuste equivalentes.
A implantação requer o escalonador exato, a ordem das características, os parâmetros do kernel, os vetores de suporte e o mapeamento de classes. O custo de predição para uma SVM com kernel cresce com o número de vetores de suporte, portanto meça latência e memória em lotes realistas. Entradas distantes do suporte de treinamento ainda podem receber rótulos confiantes; adicione verificações de out‑of‑distribution ou uma política de abstenção quando apropriado. Inspecione erros em busca de proxies sensíveis e artefatos do conjunto de dados. As SVMs permanecem fortes para problemas de tamanho médio e alta dimensionalidade, mas uma margem geométrica máxima não prova estrutura causal ou segurança.
Exemplo prático: uma SVM para roteamento de documentos raros
Uma equipe de operações jurídicas classifica documentos curtos em categorias de roteamento usando recursos TF–IDF e uma SVM linear. Ela divide por assunto e tempo para evitar vazamento de modelos, escala pesos de classe com base no custo de erro revisado e ajusta C dentro de validação aninhada. O modelo linear é comparado com regressão logística e um transformer. Precisão, recall, calibração por classe e carga de trabalho do revisor são mais importantes que a acurácia geral.
Pontuações de decisão são calibradas em dados separados, e documentos de margem baixa ou em idioma não suportado são encaminhados para triagem manual. O artefato de implantação inclui tokenizador, vocabulário, ponderação, modelo, calibração e mapa de rótulos. O monitoramento rastreia novos termos, prevalência de categorias, margens e rotas corrigidas. Documentos e vetores de suporte são protegidos porque recursos de texto podem expor informações confidenciais. Um kernel não linear é rejeitado quando seu pequeno ganho de qualidade não justifica latência, memória e custo de interpretabilidade.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, o ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de limite, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e aposentamento. Use um rollout em etapas, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade das entradas, o comportamento das saídas, a versão do modelo ou regra, a saúde das dependências, intervenções humanas e os resultados confirmados sem coletar dados sensíveis desnecessários. Defina limiares de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
As SVMs realizam apenas classificação?
Não. A regressão de vetor de suporte prediz alvos contínuos, enquanto uma SVM de classe única pode estimar uma fronteira de novidade. Cada variante tem um objetivo diferente e um conjunto distinto de hiperparâmetros.
Quando a SVM linear é uma escolha forte?
SVMs lineares são frequentemente eficazes para características esparsas de alta dimensão, incluindo representações textuais tradicionais, onde um kernel flexível acrescentaria custo sem benefício claro.
Referências principais












