
Fundamentos de IA
O que é o Teorema de Bayes?

 Adicione Unite.AI às suas fontes preferidas no Google
Teorema de Bayes descreve como atualizar a probabilidade de uma hipótese após observar evidências. Ele conecta a probabilidade da evidência dada uma hipótese com a probabilidade da hipótese dada essa evidência.
Essa distinção é central para o raciocínio estatístico e aprendizado de máquina. Um teste pode ser altamente preciso quando uma condição está presente, enquanto um resultado positivo ainda tem uma probabilidade modesta de indicar a condição se esta for rara.
Principais pontos
- O posterior combina uma crença prévia com a verossimilhança da evidência observada.
- O termo evidência normaliza as hipóteses possíveis.
- Taxas de base podem dominar evidências aparentemente fortes.
- Naive Bayes assume que os atributos são condicionalmente independentes dado a classe, não independentes em todas as circunstâncias.
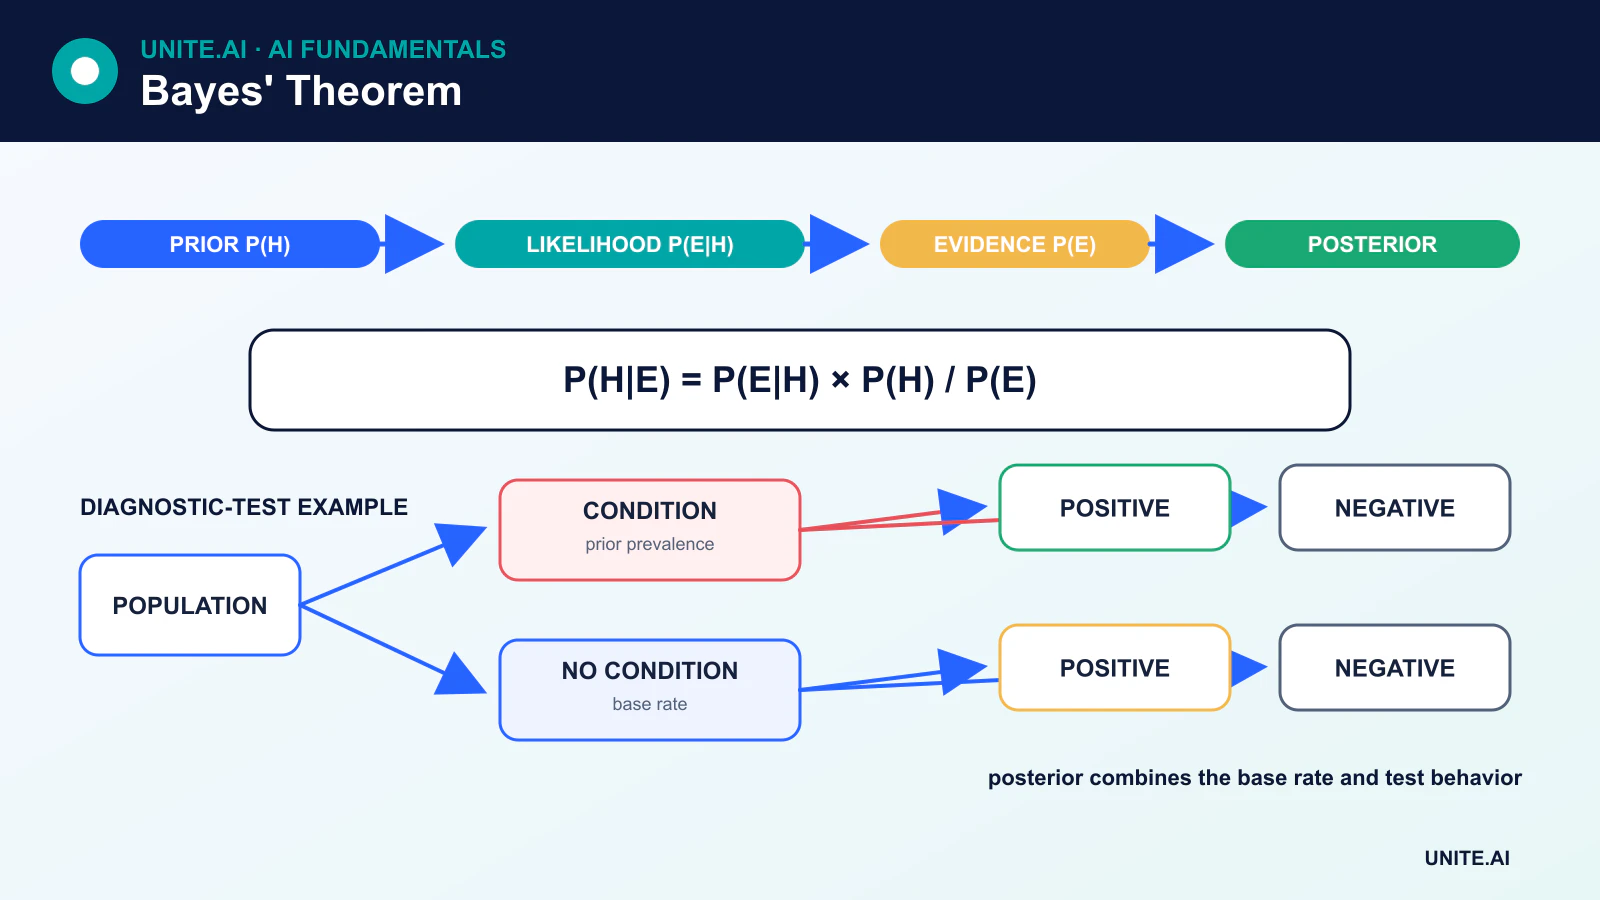
A fórmula
P(A|B) = P(B|A)P(A) / P(B)
- P(A) é a probabilidade prévia da hipótese A.
- P(B|A) é a verossimilhança de observar a evidência B se A for verdadeiro.
- P(B) é a probabilidade geral da evidência.
- P(A|B) é a probabilidade posterior de A após observar B.
O teorema decorre de duas expressões equivalentes para probabilidade conjunta: P(A ∩ B) = P(B|A)P(A) e P(A ∩ B) = P(A|B)P(B).
Um exemplo numérico de taxa base
Suponha que uma condição afete 1% da população. Um teste tem 90% de sensibilidade e taxa de falso‑positivo de 5%. Considere 1.000 pessoas:
- Cerca de 10 têm a condição; o teste sinaliza corretamente 9.
- Cerca de 990 não têm; uma taxa de falso‑positivo de 5% sinaliza aproximadamente 50.
- Portanto há cerca de 59 resultados positivos, dos quais 9 são verdadeiros positivos.
A probabilidade da condição após um resultado positivo é cerca de 9 / 59 ≈ 15%, não 90%. A sensibilidade do teste responde P(positivo | condição); o usuário geralmente quer P(condição | positivo). O teorema de Bayes os conecta usando a taxa base.
Atualização bayesiana
À medida que novas evidências chegam, um posterior pode tornar‑se o prévio para a próxima atualização. Um modelo bayesiano completo especifica hipóteses possíveis, distribuições prévias, uma verossimilhança e a quantidade a inferir. A incerteza é representada por uma distribuição posterior ao invés de apenas uma estimativa pontual.
O prévio deve ser documentado e testado quanto à sensibilidade. Um prévio fracamente informativo pode regularizar valores implausíveis, enquanto um prévio forte mal escolhido pode dominar dados limitados.
Classificadores Naive Bayes
Naive Bayes prevê uma classe y a partir de atributos x₁ … xₙ usando o teorema de Bayes e a suposição:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
Os atributos são assumidos como condicionalmente independentes após a classe ser conhecida. Isso costuma ser irrealista, porém o classificador pode funcionar bem quando as pontuações de classe resultantes ainda são úteis.
Variantes comuns
- Naive Bayes Multinomial modela atributos semelhantes a contagens e é comum na classificação de documentos.
- Naive Bayes Bernoulli modela presença binária de atributos.
- Naive Bayes Gaussiano modela cada atributo contínuo com uma distribuição gaussiana condicional à classe.
- Naive Bayes Categórico modela categorias discretas.
Suavização e estabilidade numérica
Se um valor de atributo nunca aparece com uma classe no treinamento, uma estimativa de probabilidade não suavizada pode tornar‑se zero e eliminar todo o produto. Suavização aditiva ou no estilo Laplace impede isso. Implementações calculam probabilidades logarítmicas para que a multiplicação de muitos valores pequenos se torne soma de log‑valores estáveis.
Probabilidades, pontuações e calibração
Saídas de probabilidade do Naive Bayes podem estar mal calibradas porque atributos correlacionados são efetivamente contados mais de uma vez. Um classificador pode classificar bem as classes enquanto superestima a confiança. A calibração deve ser avaliada em dados de validação quando as probabilidades orientam decisões.
Bayes além do Naive Bayes
A inferência bayesiana suporta modelos hierárquicos, testes A/B, estimativa de parâmetros científicos, previsões, tomada de decisão consciente da incerteza e modelos gráficos probabilísticos. Métodos aproximados como Cadeia de Markov Monte Carlo e inferência variacional são usados quando um posterior não pode ser calculado em forma fechada.
Erros de raciocínio comuns
- Confundir
P(A|B)comP(B|A). - Ignorar uma taxa de base rara ou comum.
- Tratar um prévio como objetivo ou deixá‑lo sem documentação.
- Assumir que uma alta verossimilhança implica automaticamente um alto posterior.
- Interpretar uma associação preditiva como causalidade.
Probabilidade condicional, odds e evidência
O teorema de Bayes relaciona a probabilidade de uma hipótese após evidência à sua probabilidade prévia, à verossimilhança de observar aquela evidência sob a hipótese e à probabilidade total da evidência. Na forma de odds, odds posteriores são iguais a odds prévios multiplicados por uma razão de verossimilhança. Isso separa o que se acreditava antes do teste de quão fortemente o teste distingue as hipóteses. Um teste que parece altamente preciso ainda pode gerar muitos falsos positivos quando a condição é rara porque a taxa de base entra no posterior.
A verossimilhança é uma função da hipótese para dados observados fixos e não deve ser confundida com a probabilidade da hipótese. A normalização da evidência soma ou integra sobre hipóteses concorrentes. Suposições de independência condicional podem simplificar o cálculo, como no Naive Bayes, mas devem ser verificadas quanto às consequências. Várias peças de evidência não podem ser multiplicadas como independentes quando compartilham causas ou duplicam informação. A direção causal também importa: P(evidência|hipótese) não é geralmente P(hipótese|evidência), o clássico erro de probabilidade inversa.
Escolhas de modelagem, computação e uso na decisão
A análise bayesiana especifica um prévio, uma verossimilhança e uma distribuição preditiva posterior. Os pré‑priors podem codificar conhecimento estabelecido, regularizar amostras pequenas ou ser fracamente informativos; devem ser justificados e testados por análise de sensibilidade. Modelos conjugados fornecem atualizações analíticas, enquanto Cadeia de Markov Monte Carlo, inferência variacional e métodos sequenciais aproximam posteriors complexos. Diagnostique convergência, tamanho efetivo da amostra, erro de aproximação e plausibilidade preditiva do prévio ao invés de relatar um número posterior sem verificações computacionais.
Uma probabilidade posterior informa, mas por si só não escolhe uma ação. Decisões requerem perdas, benefícios, restrições e alternativas disponíveis. Avalie modelos probabilísticos com calibração, regras de pontuação adequadas e verificações preditivas posteriores em novos dados. Atualize apenas com evidência coletada sob um processo modelado; viés de seleção e mudança de distribuição podem invalidar a verossimilhança. Comunique intervalos credíveis e suposições sem tratá‑los como intervalos de frequência garantidos. O teorema de Bayes é álgebra de probabilidade exata, enquanto a qualidade de uma conclusão bayesiana depende do modelo e das evidências fornecidas.
Exemplo prático: interpretando um teste diagnóstico
Um teste tem 95% de sensibilidade e 90% de especificidade, mas a condição afeta apenas 1% da população rastreada. Para 10.000 pessoas, esperam‑se cerca de 95 verdadeiros positivos e 990 falsos positivos, resultando em um valor preditivo positivo abaixo de 9%. O teorema de Bayes torna explícito o efeito da taxa de base. O cálculo apresenta população, limiar do teste e incerteza ao invés de anunciar a sensibilidade como a chance de um resultado positivo estar correto. Essa distinção também é fundamental para a ciência de dados cuidadosa.
Clínicos atualizam a probabilidade com evidência adicional somente quando a dependência entre testes é modelada. Um limiar de decisão incorpora o dano de doença não detectada, risco de teste confirmatório, custo e preferência do paciente. A calibração é verificada na população local, e mudanças de prevalência acionam revisão. O posterior apoia a discussão e os próximos passos; não substitui diagnóstico confirmatório. Relatórios usam frequências naturais e análise de sensibilidade para que pacientes e profissionais vejam como a conclusão muda sob suposições plausíveis.
Evidência de implementação e prontidão operacional
Uma decisão de produção requer mais que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entrada malformada ou ausente, mudança de distribuição, interrupção de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa junto com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, alterações, reversão e aposentamento. Use um lançamento em fases, preserve um fallback seguro e verifique monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável por respostas, então revise evidências do mundo real após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
Qual é a diferença entre verossimilhança e probabilidade?
Com parâmetros fixos, um modelo atribui probabilidade a dados possíveis. Com dados observados fixos, a mesma expressão pode ser vista como uma função de verossimilhança sobre valores de parâmetros possíveis. A fórmula numérica pode coincidir enquanto a interpretação difere.
O Naive Bayes é inferência bayesiana completa?
Ele usa o teorema de Bayes para classificação sob um modelo forte de independência condicional. A inferência bayesiana mais ampla coloca distribuições sobre quantidades desconhecidas e raciocina com uma distribuição posterior.
Referências principais












