Ângulo de Anderson
Como saber se os sistemas de síntese de imagens produzem material realmente original

 Adicione Unite.AI às suas fontes preferidas no Google

Pontos-chaveO Rarity Score da KAIST e da NAVER mede a originalidade da imagem por meio de…
Ver mais
- O Rarity Score da KAIST e da NAVER mede a originalidade da imagem por meio de distâncias do vizinho mais próximo.
- Métricas existentes, como o Truncation Trick, favorecem a autenticidade em detrimento da novidade em imagens geradas.
- O Rarity Score poderia identificar resultados verdadeiramente inventivos de sistemas como o DALL-E 2.
Um novo estudo da Coreia do Sul propôs um método para determinar se os sistemas de síntese de imagens estão produzindo imagens genuinamente novas, ou apenas variações “menores” dos dados de treinamento, potencialmente frustrando o objetivo dessas arquiteturas (como a produção de imagens novas e originais).
Muito frequentemente, o artigo sugere, o último é verdadeiro, porque as métricas existentes que esses sistemas usam para melhorar suas capacidades gerativas ao longo do treinamento são forçadas a favorecer imagens que são relativamente próximas das imagens de origem (não falsas) no conjunto de dados.
Afinal, se uma imagem gerada é “visualmente próxima” dos dados de origem, é inevitavelmente provável que obtenha uma pontuação melhor para “autenticidade” do que para “originalidade”, pois é fiel à fonte, embora pouco inspirada.
Em um setor muito novo e não testado para suas ramificações legais serem ainda conhecidas, isso pode se tornar um problema legal importante, se for descoberto que o conteúdo de imagem sintética comercializado não difere o suficiente do material de origem (muitas vezes) protegido por direitos autorais que atualmente pode permear o setor de pesquisa na forma de conjuntos de dados coletados na web (a possibilidade de reivindicações de infração futuras desse tipo chamou a atenção recentemente em relação ao GitHub Co-Pilot AI da Microsoft ).
Em termos da saída cada vez mais coerente e semanticamente robusta de sistemas como o DALL-E 2 da OpenAI, o Imagen do Google e as versões CogView da China (além do DALL-E mini de menor especificação), há muito poucas formas pós-fato confiáveis para testar a originalidade de uma imagem gerada.
De fato, procurar por algumas das imagens mais populares do novo DALL-E 2 muitas vezes levará apenas a mais instâncias dessas mesmas imagens, dependendo do mecanismo de busca.

Carregar um grupo completo de nove imagens DALL-E 2 leva apenas a outros grupos semelhantes, pois a grade é a característica mais forte. Separar e carregar a primeira imagem de esta publicação no Twitter, de 8 de junho de 2022, da conta Weird Dall-E Generations, faz o Google se fixar na bola de basquete e leva a busca a um beco sem saída semântico. Para a mesma imagem, o Yandex ao menos parece fazer análise real de pixels e correspondência de características.
Embora o Yandex seja mais provável de usar as características reais (ou seja, as características derivadas ou calculadas de uma imagem, e não necessariamente características faciais de pessoas) e características visuais (em vez de semânticas) de uma imagem submetida para encontrar imagens semelhantes, todos os mecanismos de busca de imagens têm alguma agenda ou prática que pode dificultar a identificação de instâncias de plágio fonte>gerado via buscas na web.
Além disso, os dados de treinamento para um modelo gerativo podem não estar disponíveis publicamente em sua totalidade, o que dificulta ainda mais o exame forense da originalidade das imagens geradas.
Interessantemente, realizar uma busca de imagem na web em uma das imagens sintéticas apresentadas pelo Google em seu site dedicado ao Imagen não encontra nada comparável ao assunto da imagem, em termos de realmente olhar para a imagem e buscar imagens semelhantes de forma imparcial. Em vez disso, os resultados continuam presos à semântica: não permitem uma busca puramente visual dessa imagem sem acrescentar imagen google como parâmetro adicional e limitador.

O Yandex, por outro lado, encontra uma multidão de imagens semelhantes (ou pelo menos visualmente relacionadas) da comunidade artística amadora.

Em geral, seria melhor se a novidade ou originalidade da saída dos sistemas de síntese de imagens pudesse ser medida de alguma forma, sem precisar extrair características de todas as imagens possíveis na internet no momento em que o modelo foi treinado, ou em conjuntos de dados não públicos que podem estar usando material protegido por direitos autorais.
Relacionado a essa questão, pesquisadores da Escola de Pós-Graduação em Inteligência Artificial Kim Jaechul do Instituto de Ciência e Tecnologia Avançada da Coreia (KAIST AI) colaboraram com a empresa global de ICT e busca NAVER Corp para desenvolver uma Pontuação de Raridade que pode ajudar a identificar as criações mais originais dos sistemas de síntese de imagens.

Imagens geradas com StyleGAN-FFHQ. As colunas vão dos piores aos melhores resultados, da esquerda para a direita. Truncation trick e Realism têm seus próprios objetivos, enquanto a nova Pontuação de Raridade, na primeira linha, procura imagens coerentes e originais, em vez de apenas coerentes. Devido aos limites de tamanho das imagens neste artigo, consulte o trabalho original para mais detalhes e maior resolução. Fonte: https://arxiv.org/pdf/2206.08549.pdf
O novo artigo é intitulado Pontuação de Raridade: Uma Nova Métrica para Avaliar a Raridade de Imagens Sintéticas, e vem de três pesquisadores do KAIST e três da NAVER Corp.
Além do ‘Truque Barato’
Entre as métricas anteriores que o novo artigo está tentando melhorar estão as do ‘Truncation trick’ sugeridas em 2019 em uma colaboração entre a Universidade Heriot-Watt do Reino Unido e a DeepMind do Google.
O Truncation Trick basicamente usa uma distribuição latente diferente para amostragem do que foi usado para treinar o modelo gerativo.
Os pesquisadores que desenvolveram esse método ficaram surpresos que funcionou, mas admitem no artigo original que reduz a variedade da saída gerada. No entanto, o Truncation Trick se tornou eficaz e popular, no contexto do que poderia ser redefinido como um ‘truque barato’ para obter resultados autênticos que não realmente assimilam todas as possibilidades inerentes aos dados, e podem se parecer mais com os dados de origem do que o desejado.
Sobre o Truncation Trick, os autores do novo artigo observam:
‘[Ele] não é destinado a gerar amostras raras nos conjuntos de dados de treinamento, mas sim a sintetizar imagens típicas de forma mais estável. Nós hipotetizamos que os modelos gerativos existentes serão capazes de produzir amostras mais ricas na distribuição de dados reais se o gerador puder ser induzido a produzir efetivamente amostras raras.’
Quanto à tendência geral de confiar em métricas tradicionais, como a Distância de Inception de Fréchet (FID, que foi criticada intensamente em dezembro de 2021), Inception Score (IS) e Distância de Inception do Kernel (KID) como ‘indicadores de progresso’ durante o treinamento de um modelo gerativo, os autores comentam ainda*:
‘Esse esquema de aprendizado leva o gerador a não sintetizar muitas amostras raras que são únicas e têm características fortes que não representam uma grande proporção da distribuição de imagem real. Exemplos de amostras raras de conjuntos de dados públicos incluem pessoas com vários acessórios em FFHQ, animais brancos em AFHQ, e estátuas incomuns em Metfaces.
‘A capacidade de gerar amostras raras é importante não apenas porque está relacionada à capacidade dos modelos gerativos nos limites de suas possibilidades, mas também porque a singularidade desempenha um papel importante nas aplicações criativas, como humanos virtuais.
‘No entanto, os resultados qualitativos de vários estudos recentes raramente contêm esses exemplos raros. Nós conjecturamos que a natureza do esquema de aprendizado adversarial força a distribuição de imagem gerada a ser semelhante à do conjunto de dados de treinamento. Assim, imagens com individualidade clara ou raridade apenas representam uma pequena parte das imagens sintetizadas pelos modelos.’
Técnica
A nova Pontuação de Raridade dos pesquisadores adapta uma ideia apresentada em trabalhos anteriores – o uso de K-Nearest Neighbors (KNNs) para representar os arrays de dados genuínos (de treinamento) e sintéticos (de saída) em um sistema de síntese de imagens.
Quanto a esse novo método de análise, os autores afirmam:
‘Nós hipotetizamos que as amostras comuns estarão mais próximas umas das outras, enquanto as amostras únicas e raras estarão esparsamente localizadas no espaço de características.’
A imagem de resultados acima mostra as menores distâncias de vizinhos mais próximos (NNDs) para as maiores, em uma arquitetura StyleGAN treinada em FFHQ.
‘Para todos os conjuntos de dados, as amostras com as menores NNDs mostram imagens típicas e representativas. Por outro lado, as amostras com as maiores NNDs têm forte individualidade e são significativamente diferentes das imagens típicas com as menores NNDs.’
Em teoria, usando essa nova métrica como um discriminador, ou pelo menos incluindo-a em uma arquitetura de discriminador mais complexa, um sistema gerativo poderia ser direcionado para longe da mera imitação em direção a um algoritmo mais inventivo, enquanto retém a coesão essencial de conceitos que podem ser críticos para a produção de imagens autênticas (ou seja, ‘homem’, ‘mulher’, ‘carro’, ‘igreja’, etc.).
Comparações e Experimentos
Nos testes, os pesquisadores realizaram uma comparação do desempenho da Pontuação de Raridade contra tanto o Truncation Trick quanto a Pontuação de Realismo da NVIDIA de 2019, e descobriram que, em uma variedade de frameworks e conjuntos de dados, a abordagem é capaz de individuar resultados ‘únicos’.
Embora os resultados apresentados no artigo sejam muito extensos para serem incluídos aqui, os pesquisadores parecem ter demonstrado a capacidade do novo método de identificar raridade em imagens de origem (reais) e imagens geradas (falsas) em um procedimento gerativo:
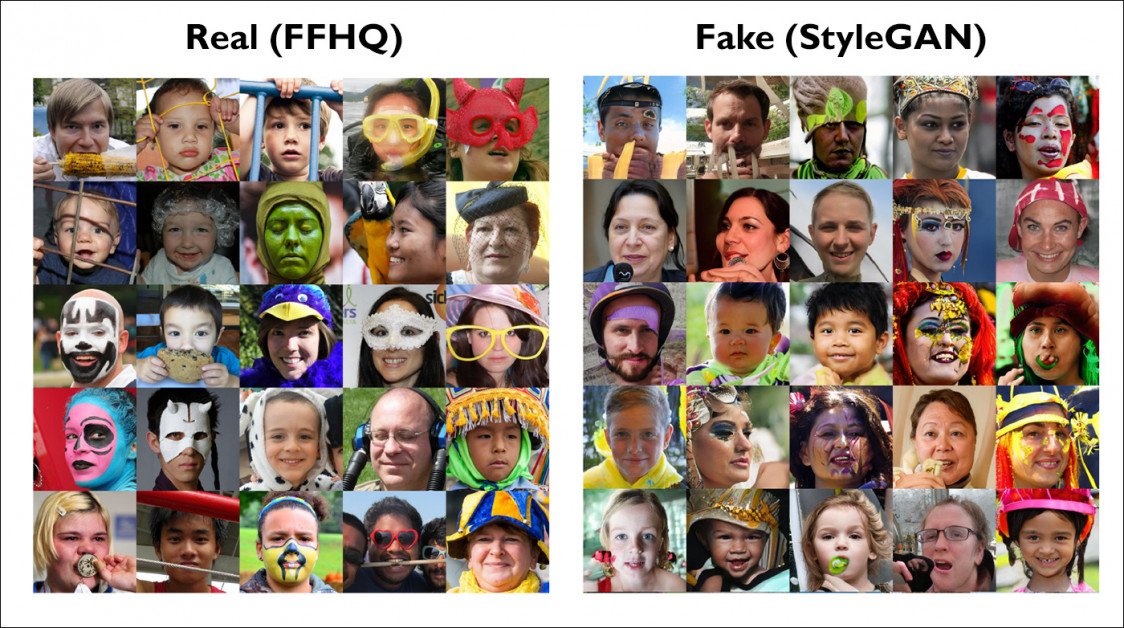
Exemplos selecionados dos extensos resultados visuais do estudo; veja a fonte acima para detalhes. À esquerda, exemplos reais do FFHQ com muito poucos vizinhos próximos no conjunto original, ou seja, novos e incomuns. À direita, imagens criadas pelo StyleGAN que a nova métrica identificou como realmente novas. Devido ao limite de tamanho das imagens, consulte o trabalho original para mais detalhes e maior resolução.
A nova métrica de Pontuação de Raridade não apenas permite a possibilidade de identificar saída gerativa nova em uma arquitetura única, mas também, segundo os pesquisadores, permite comparações entre modelos gerativos de arquiteturas variadas (ou seja, autoencoder, VAE, GAN, etc.).
O artigo observa que a Pontuação de Raridade difere das métricas anteriores ao se concentrar na capacidade de um framework gerativo de criar imagens únicas e raras, em oposição às métricas ‘tradicionais’, que examinam (de forma mais míope) a diversidade entre gerações durante o treinamento do modelo.
Além de Tarefas Limitadas
Embora os pesquisadores do novo artigo tenham realizado testes em frameworks de domínio limitado (como combinações de gerador/conjunto de dados projetadas para produzir especificamente imagens de pessoas ou de gatos, por exemplo), a Pontuação de Raridade pode potencialmente ser aplicada a qualquer procedimento de síntese de imagem arbitrário onde se deseja identificar exemplos gerados que usam as distribuições derivadas dos dados treinados, em vez de aumentar a autenticidade (e reduzir a diversidade) interpondo distribuições latentes externas, ou confiando em outros ‘atalhos’ que comprometem a novidade em favor da autenticidade.
Em essência, tal métrica poderia potencialmente distinguir instâncias de saída realmente novas em sistemas como a série DALL-E, usando a distância identificada entre um resultado aparente de ‘outlier’, os dados de treinamento e resultados de prompts ou entradas semelhantes (ou seja, prompts baseados em imagens).
Na prática, e na ausência de uma compreensão clara da extensão com que o sistema realmente assimilou conceitos visuais e semânticos (muitas vezes impedida pelo conhecimento limitado sobre os dados de treinamento), isso poderia ser um método viável para identificar um momento genuíno de ‘inspiração’ em um sistema gerativo – o ponto em que um número adequado de conceitos e dados de entrada resultou em algo genuinamente inventivo, em vez de algo excessivamente derivado ou próximo dos dados de origem.
* Minhas conversões das citações inline dos autores para links.
Publicado pela primeira vez em 20 de junho de 2022.