Fundamentos de IA
O que são Modelos de Linguagem de Grande Escala (LLMs)?

 Adicione Unite.AI às suas fontes preferidas no Google
Um modelo de linguagem de grande escala (LLM) é uma rede neural treinada em grandes coleções de sequências para prever tokens ou objetivos linguísticos relacionados. A maioria dos LLMs atuais usa arquiteturas transformer e pode gerar, classificar, resumir, traduzir, recuperar e transformar linguagem por meio de uma interface comum.
Um LLM não é um banco de dados nem um raciocinador garantido. Sua saída é uma previsão condicional moldada pelos dados de treinamento, pós‑treinamento, contexto, ferramentas e decodificação. Fluência pode coexistir com erros factuais, incerteza, viés ou comportamento inseguro.
Principais pontos
- Tokenização converte texto em unidades discretas; embeddings e atenção constroem representações contextuais.
- Pré‑treinamento aprende padrões amplos, enquanto ajuste fino e métodos de preferência moldam o comportamento em tarefas.
- Recuperação e ferramentas podem adicionar evidências ou ações atuais, mas exigem permissões e validação separadas.
- Avalie o sistema implantado quanto à qualidade, fundamentação, segurança, latência, custo e deriva.
Tokens, transformadores e pré‑treinamento
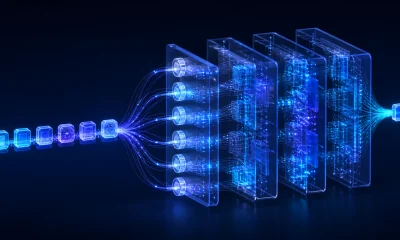
O texto é dividido em tokens. Um transformer os mapeia em vetores, mistura informações através de camadas de atenção e feed‑forward, e produz uma distribuição de probabilidade sobre o próximo token ou o token ausente.
Objetivos auto‑supervisionados criam sinais de treinamento a partir de sequências brutas. Escalar parâmetros, dados e computação pode melhorar a perda de forma previsível ao longo de intervalos, mas a qualidade do conjunto de dados, arquitetura, otimização e avaliação determinam quais capacidades surgem na prática.
Pós‑treinamento e inferência
O ajuste por instruções usa demonstrações; a otimização por preferência pode fazer com que as saídas correspondam melhor a julgamentos humanos ou a uma política. Na inferência, um prompt e o histórico da conversa definem o contexto, enquanto temperatura e configurações de amostragem influenciam a variabilidade.
RLHF e métodos semelhantes moldam o comportamento em vez de instalar um verificador de fatos completo. O modelo ainda pode gerar uma resposta plausível, porém sem suporte.
Recuperação, ferramentas e agentes
A geração aumentada por recuperação fornece trechos selecionados de uma coleção externa. A chamada de ferramentas permite que o código da aplicação consulte bancos de dados, calcule, pesquise ou execute ações. Esses padrões separam parte do conhecimento e da execução dos pesos do modelo.
A aplicação deve validar os argumentos das ferramentas, impor permissões, preservar citações e tratar o conteúdo recuperado como entrada não confiável. Busca por similaridade vetorial auxilia a recuperação, mas não comprova que um trecho sustenta a resposta.
Limitações e avaliação
LLMs podem gerar alucinações, expor conteúdo memorizado, seguir instruções maliciosas, reproduzir vieses e falhar em tarefas que parecem semelhantes a exemplos de treinamento. Contexto longo não garante que cada fato seja usado ou reconciliado corretamente.
Avalie em tarefas privadas representativas com prompts e versões documentados. Meça suporte por fontes, recusa, calibração, segurança, resultados de subgrupos, carga de trabalho humana, latência e custo. Monitore após o lançamento, pois modelos, dados e comportamento dos usuários mudam.
Dados de treinamento e desenvolvimento de modelo
Os corpora de pré‑treinamento combinam páginas da web, livros, código, material acadêmico, conversas e fontes licenciadas ou curadas. Pipelines detectam idioma, removem duplicatas, filtram conteúdo de qualidade e inseguro, tratam dados pessoais e escolhem pesos de mistura. Essas escolhas moldam conhecimento, cobertura linguística, estilo, viés e memorização.
Processos de otimização agrupam sequências de tokens e minimizam a perda de previsão com descida de gradiente. Treinamento distribuído divide dados, tensores do modelo, estágios de pipeline ou especialistas entre aceleradores. Salvamento de checkpoints, estabilidade numérica, comunicação de rede e recuperação de falhas tornam‑se grandes desafios de engenharia em escala.
A avaliação durante o treinamento acompanha a perda e suítes de capacidades, mas contaminação de benchmarks pode inflar os resultados. Reserve períodos de tempo e tarefas proprietárias, procure sobreposições e relate prompts exatos, decodificação, ferramentas e pontuação. Um modelo pode melhorar a perda média enquanto regressões surgem em segurança ou em um idioma de poucos recursos.
Janelas de contexto, decodificação e inferência
Na inferência, o cache de chave‑valor armazena projeções de atenção para tokens anteriores, de modo que não precisam ser recomputados a cada passo. A memória do cache cresce com camadas, sequência, lote e representação. Quantização e paginação reduzem a pressão, mas podem alterar a qualidade ou latência.
Decodificação gananciosa seleciona o token de maior probabilidade; temperatura reescala as probabilidades; top‑k e top‑p restringem o conjunto de candidatos; busca em feixe acompanha várias sequências. A melhor estratégia depende se a tarefa valoriza determinismo, diversidade, saída estruturada ou verossimilhança da sequência. Sempre valide o esquema após a geração.
Contexto longo aumenta a quantidade de informação disponível, mas não garante recordação ou raciocínio. Posição, distratores, contradições e estrutura do prompt afetam o uso. Recuperação pode selecionar um conjunto menor de evidências, enquanto a sumarização comprime o histórico ao risco de perder detalhes. Meça o desempenho ao longo do comprimento e da localização do contexto.
Adaptação, implantação e economia
Ajuste fino completo atualiza todos os parâmetros; métodos eficientes em parâmetros atualizam adaptadores ou matrizes de baixa rank; pré‑treinamento continuado adapta a distribuição de domínio; ajuste por instrução e preferência moldam as respostas. Recuperação costuma ser melhor para fatos que mudam frequentemente, enquanto ajuste fino é melhor para comportamento e formato de tarefa. Os métodos podem ser combinados.
As opções de implantação incluem APIs hospedadas, endpoints gerenciados, pesos abertos auto‑hospedados, modelos em dispositivo e híbridos. Compare tratamento de dados, controle de versão, latência, taxa de transferência, regiões, disponibilidade, portabilidade do modelo, suporte e custo total. Auto‑hospedagem transfere a responsabilidade por segurança, escalabilidade, atualizações e monitoramento de abusos.
Custo por token é incompleto. Um modelo fraco pode exigir repetições, prompts mais longos, mais revisões ou erros custosos. Meça o custo por tarefa concluída com sucesso em um nível de qualidade e risco exigido. Use cache, lotes, modelos menores roteados e código determinístico onde eles melhoram o fluxo de trabalho completo.
Exemplo prático: fundamentando um LLM em documentos corporativos
Um assistente de documentos deve começar com um corpus consciente de permissões, identificadores de documentos estáveis, versões e datas de vigência, estrutura analisável e um conjunto de avaliação contendo perguntas respondíveis, não respondíveis, ambíguas e conflitantes. A indexação de recuperação segmenta em blocos e metadados, mas o tamanho e a sobreposição dos blocos devem corresponder à estrutura do documento. A qualidade da busca é medida independentemente antes da geração, de modo que um modelo fluente não possa ocultar evidências ausentes.
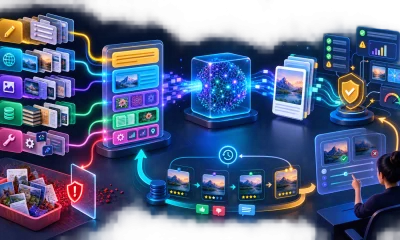
Em tempo de execução, autentique o usuário, filtre a recuperação por acesso, recupere e reordene as evidências, construa um prompt limitado, gere uma resposta citada e valide a saída requerida. O modelo deve indicar quando as fontes conflitam ou não sustentam uma resposta. O uso de ferramentas e ações externas requer autorização separada. Proteja contra instruções incorporadas em documentos recuperados tratando o conteúdo como dado, e não como política de sistema de prioridade superior.
Avalie a taxa de recuperação, precisão das citações, correção das respostas, fundamentação, recusa, latência e custo em diferentes papéis e tipos de documentos. Registre versões do modelo, prompt, índice, analisador e corpus para cada teste. Em produção, registre IDs de evidência e feedback sem expor texto privado, monitore novas perguntas não respondíveis após alterações de conteúdo e mantenha uma alternativa segura. Uma interface LLM não substitui a gestão de registros, controle de acesso ou revisão responsável de especialistas.
O planejamento de capacidade deve modelar distribuições de comprimento de prompts e saídas, usuários simultâneos, comportamento de cache, latência de ferramentas e taxas de repetição. Streaming melhora a latência percebida, mas complica moderação e cancelamento, pois conteúdo inseguro ou incorreto pode chegar ao usuário antes que a resposta completa seja verificada. Defina orçamentos de tokens e ferramentas, isole locatários, proteja credenciais do provedor e ensaie failover entre versões do modelo sem alterar silenciosamente o comportamento do qual os usuários dependem.
Checklist de implementação prática
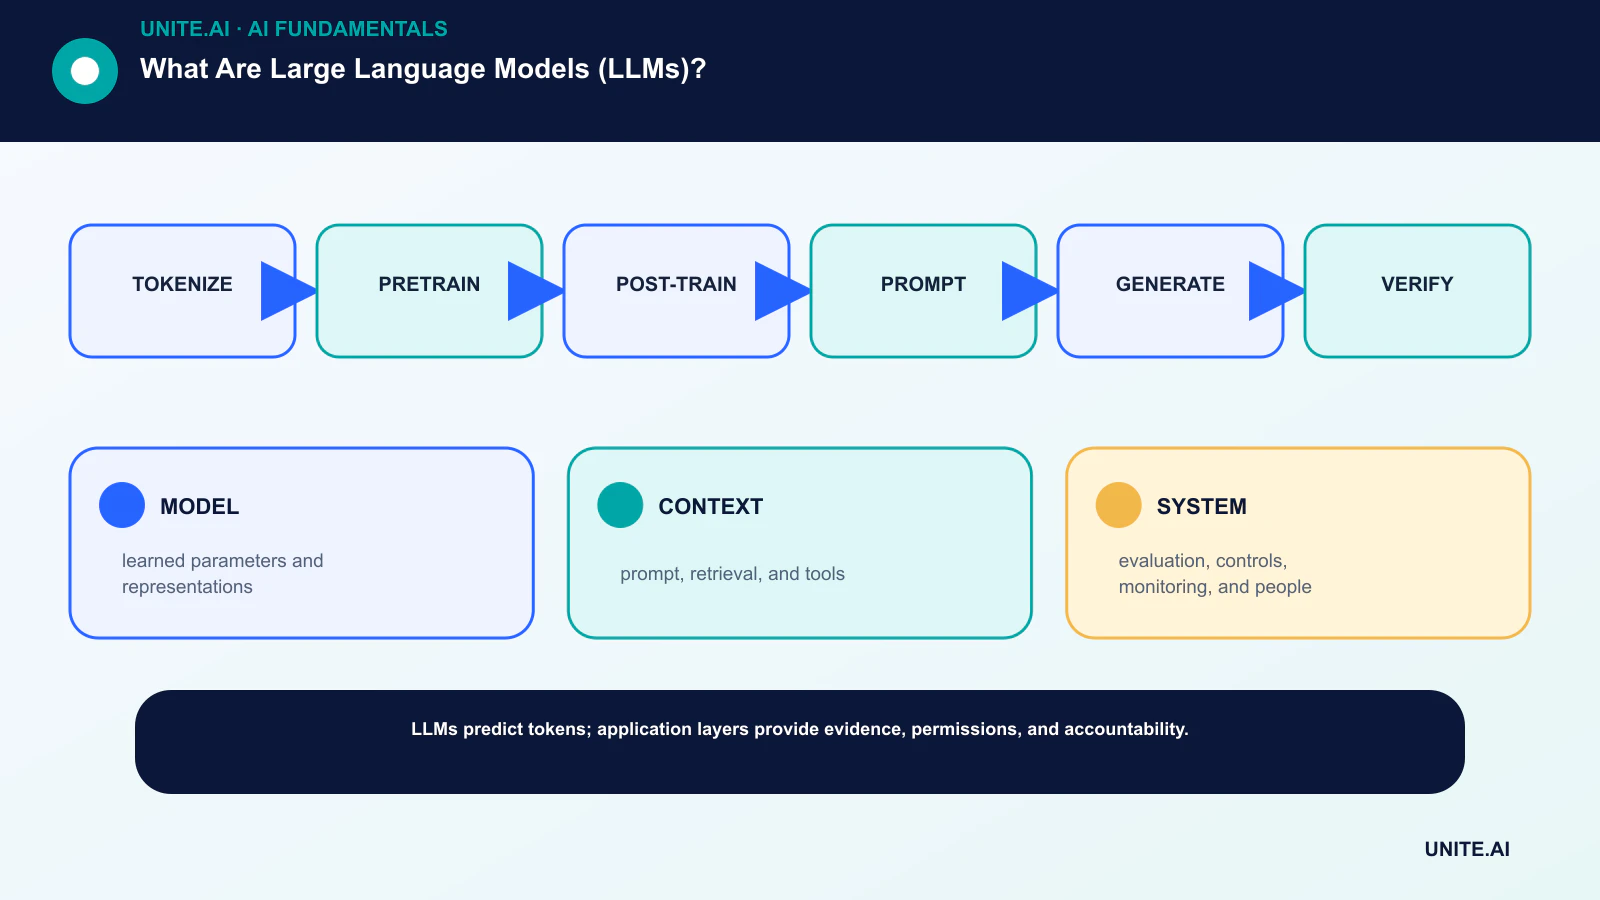
Transforme o conceito em um fluxo de trabalho limitado e testável: tokenizar → pré‑treinar → pós‑treinar → prompt → gerar → verificar. Nomeie um responsável, documente os dados e dependências, estabeleça uma linha de base simples, defina critérios de aceitação e interrupção, teste falhas representativas e defina monitoramento, rollback e revisão antes de ampliar o escopo. Registre versões e suposições para que outra equipe possa reproduzir o resultado e entender o que mudou.
Antes do lançamento, execute uma revisão de prontidão documentada com as pessoas que constroem, operam, asseguram e são afetadas pelo sistema. Teste casos normais, condições de limite, falhas de dependência e uso indevido; preserve as evidências e riscos não resolvidos. Defina quem pode aprovar a liberação, alterar um limiar, sobrescrever uma saída ou interromper a operação. Reavalie a decisão após a chegada de dados reais, pois um piloto tecnicamente bem‑sucedido não garante desempenho confiável em escala maior.
- MODEL: parâmetros aprendidos e representações.
- CONTEXT: prompt, recuperação e ferramentas.
- SYSTEM: avaliação, controles, monitoramento e pessoas.
Perguntas frequentes
Por que os LLMs são chamados de grandes?
Não existe um limiar universal de parâmetros. ‘Grande’ refere‑se à escala em relação a modelos de linguagem anteriores, incluindo parâmetros, dados de treinamento, computação e amplitude de uso.
Os LLMs entendem a linguagem?
Eles constroem representações internas úteis e exibem comportamento complexo, mas a palavra ‘entender’ tem vários significados. O desempenho deve ser demonstrado tarefa por tarefa, em vez de inferido a partir da fluência.
Referências principais
- Vaswani et al.: Attention Is All You Need
- Kaplan et al.: Scaling Laws for Neural Language Models
- Hoffmann et al.: Training Compute-Optimal Large Language Models
tand’ tem vários significados. O desempenho deve ser demonstrado tarefa por tarefa, em vez de inferido a partir da fluência.