
Fundamentos de IA
O que são Redes Neurais?

 Adicione Unite.AI às suas fontes preferidas no Google
Uma rede neural artificial é um modelo matemático parametrizado composto por camadas de operações conectadas. Durante o treinamento, a rede ajusta seus parâmetros para que as entradas sejam mapeadas a saídas úteis. Redes neurais podem aproximar relações não lineares complexas e aprender representações diretamente a partir de texto, imagens, áudio, séries temporais e outros dados.
O nome tem inspiração histórica nos neurônios biológicos, mas as redes modernas são sistemas de engenharia, não simulações realistas do cérebro. Termos como “neurônio” e “aprendizado” são abreviações úteis e não devem ser confundidos com evidência de cognição semelhante à humana.
Principais pontos
- Um neurônio calcula uma soma ponderada, adiciona um viés treinável e aplica uma função de ativação.
- Uma passagem forward gera previsões; uma função de perda mede o erro; a retropropagação calcula gradientes; um otimizador atualiza os parâmetros.
- MLPs, CNNs, RNNs e transformers organizam as conexões de forma diferente.
- Mais camadas ou parâmetros não produzem automaticamente um modelo melhor ou mais confiável.
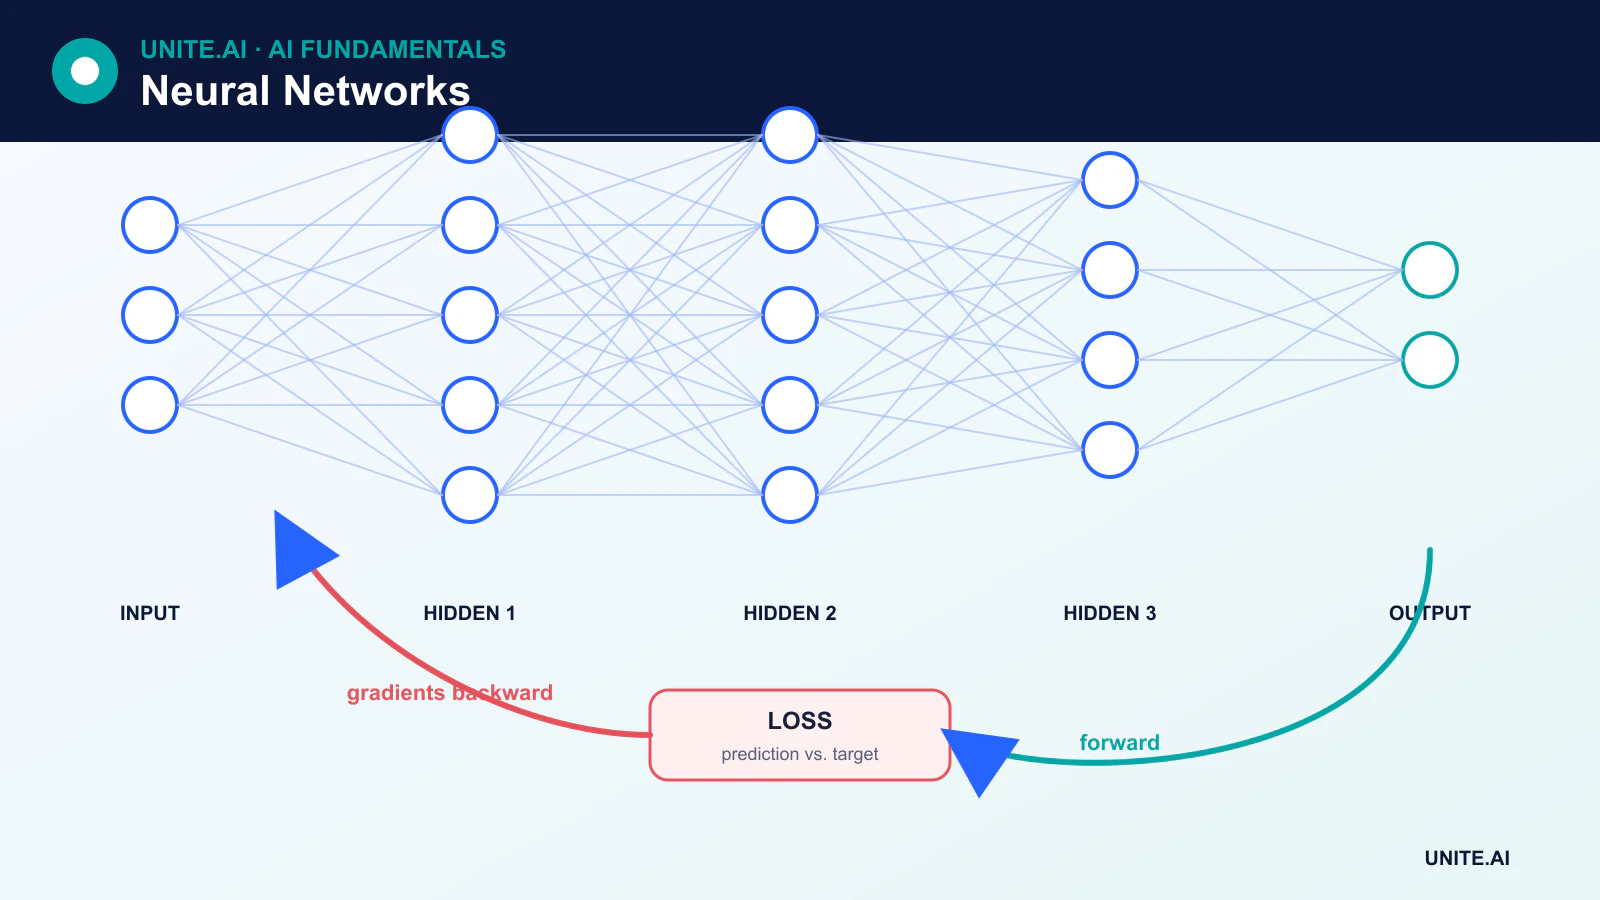
De um único neurônio artificial a uma rede
Para um vetor de entrada x, uma unidade básica calcula:
z = Wx + boutput = activation(z)
W contém pesos treináveis e b é um viés treinável. A função de ativação introduz não linearidade. Os pesos não “passam através” da ativação por si mesmos; a ativação é aplicada à soma ponderada e ao viés.
Um perceptron multicamadas (MLP) empilha camadas densas. A camada de entrada representa as características, as camadas ocultas as transformam, e a camada de saída é projetada para a tarefa — por exemplo, logits de classe ou um valor de regressão.
Como as redes neurais aprendem
- O modelo inicializa os parâmetros treináveis.
- Uma passagem forward processa um lote e produz previsões.
- Uma função de perda compara as previsões com o objetivo de treinamento.
- Retropropagação usa a regra da cadeia para calcular os gradientes.
- Um otimizador, como gradiente descendente estocástico ou AdamW, atualiza pesos e vieses.
A retropropagação tornou-se central no treinamento de redes neurais por meio de trabalhos desenvolvidos e popularizados ao longo de várias décadas; não foi criada inicialmente na era recente do deep learning. Estruturas modernas implementam diferenciação automática em modo reverso, de modo que os praticantes não precisam derivar manualmente cada gradiente.
Por que as funções de ativação são importantes
Sem ativações não lineares, múltiplas camadas lineares ordinárias se reduzem a uma única transformação linear. ReLU é amplamente usado porque é simples e eficiente. GELU e SiLU são comuns em arquiteturas modernas. Sigmoid e softmax continuam úteis para interpretações específicas de saída, mas sigmoid pode saturar em camadas ocultas e contribuir para gradientes que desaparecem.
Principais arquiteturas de redes neurais
Redes neurais convolucionais
CNNs aplicam filtros aprendidos em vizinhanças locais e compartilham parâmetros entre posições. Essas propriedades as tornam eficientes para imagens e outros sinais em forma de grade.
Redes recorrentes
RNNs, LSTMs, and GRUs atualizam um estado oculto ao longo de uma sequência. Elas continuam úteis para streaming e tarefas de séries temporais, embora a recorrência limite o processamento paralelo e possa ter dificuldades com dependências longas.
Transformadores
Transformers usam atenção para criar representações dependentes de contexto. Conexões residuais, normalização, informação de posição e blocos feed‑forward são partes centrais da arquitetura. Transformers agora sustentam muitos modelos grandes de linguagem e multimodais.
Autoencoders e redes generativas
Autoencoders aprendem representações por meio da reconstrução. GANs, modelos de difusão e redes autorregressivas geram novas amostras usando diferentes objetivos e procedimentos de treinamento.
Componentes que tornam redes profundas treináveis
Sistemas modernos utilizam mais que camadas e ativações. Conexões residuais permitem que informação e gradientes contornem blocos. Normalização estabiliza as ativações. Regularização, aumento de dados, dropout e decaimento de peso podem reduzir overfitting. Camadas de embedding mapeiam itens discretos, como tokens, para vetores. Atenção permite que uma representação dependa dinamicamente de outros elementos.
Pontos fortes e limitações
Redes neurais podem aprender características a partir de dados brutos de alta dimensionalidade e escalar com dados e computação. Elas também podem exigir grandes conjuntos de dados, hardware especializado e ajuste cuidadoso. Suas previsões podem ser mal calibradas, frágeis diante de mudanças de distribuição, vulneráveis a manipulações adversariais ou difíceis de explicar.
A arquitetura deve seguir a tarefa e as restrições de implantação. Para muitos problemas tabulares, um conjunto de árvores ou um modelo linear pode ser mais rápido e mais fácil de validar. Para aplicações de alto risco, o desempenho do modelo deve ser avaliado por subgrupos e modos de falha, não apenas por um benchmark agregado.
Camadas, ativações e fluxo de informação
Uma rede neural compõe funções parametrizadas. Cada unidade forma uma combinação ponderada de entradas, adiciona um viés e passa o resultado por uma ativação como ReLU, sigmoid, tanh ou GELU. Empilhar camadas permite recursos hierárquicos e fronteiras de decisão não lineares. Largura controla unidades por camada; profundidade controla transformações sucessivas; conectividade e compartilhamento de pesos codificam a arquitetura. A saída da rede depende de pré‑processamento, parâmetros, normalização e modo de inferência em conjunto. Um neurônio é uma operação matemática, não um neurônio biológico literal ou um conceito independente com significado.
A propagação forward calcula previsões; uma perda quantifica o erro; a retropropagação aplica a regra da cadeia aos gradientes; um otimizador atualiza os parâmetros. Inicialização, taxa de aprendizado, estatísticas de lote, caminhos residuais e normalização afetam se os gradientes desaparecem, explodem ou permanecem úteis. Regularização inclui decaimento de peso, dropout, aumento de dados, parada precoce e restrições arquiteturais. Plote o comportamento de treinamento e validação, inspecione estatísticas de gradientes e ativações, e compare execuções repetidas. Uma rede grande pode memorizar dados de treinamento, enquanto uma pequena pode subajustar ou perder estrutura necessária.
Seleção, avaliação e implantação de arquitetura
Perceptrons multicamadas processam vetores fixos; redes convolucionais exploram estrutura local; modelos recorrentes e de espaço de estado processam sequências; transformers usam atenção; redes de grafos trocam informações ao longo de arestas. Híbridos são comuns. Escolha com base no viés indutivo, dados, tamanho da sequência ou imagem, latência, memória, interpretabilidade e hardware disponível. Avalie contra um baseline linear ou de árvore e realize ablações para aprender qual complexidade importa. A contagem de parâmetros por si só não prediz qualidade, custo de inferência ou necessidade de dados.
Servir requer pré‑processamento congelado, um grafo exportado ou compilado, validação numérica e testes de recursos sob carga realista. Quantização e poda podem reduzir o tamanho, mas podem alterar o comportamento de classes raras. Monitore entradas, saídas, calibração, latência e resultados confirmados; teste dados adversariais e deslocados. Proteja modelos, dependências e dados por meio de artefatos assinados, controle de acesso e revisão da cadeia de suprimentos. Explicações a partir de ativações individuais ou saliência exigem verificação causal e comportamental. Redes neurais são aproximadores de funções flexíveis, não garantias de compreensão, verdade ou robustez.
Exemplo prático: um previsores de demanda neural
Um varejista prevê a demanda semanal de itens a partir de vendas, promoções, preço, feriados, disponibilidade e clima. A rede é comparada com linhas de base sazonal‑naïve, linear e de árvore usando divisões temporais rolantes. Promoções futuras são incluídas apenas quando realmente conhecidas no momento da previsão, enquanto rupturas de estoque são modeladas porque vendas observadas podem subestimar a demanda. A avaliação usa erro absoluto ponderado, viés, cobertura de intervalo e resultados por velocidade do item e loja.
O pipeline de serviço versiona disponibilidade, modelo e horizonte e rejeita uma previsão quando as entradas necessárias estão desatualizadas. Planejadores veem intervalos e podem sobrescrever com razões registradas. O monitoramento detecta feeds ausentes, erro em mudança, viés e previsões incomuns; os resultados de negócios são separados da precisão da previsão porque a política de pedidos também afeta o estoque. Uma atualização de modelo é sombreada ao longo de vários ciclos, e o previsores anterior permanece disponível para rollback durante interrupções sazonais ou de fornecedores.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de limite, entradas malformadas ou ausentes, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, mudanças, rollback e aposentadoria. Use um rollout em fases, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade das entradas, comportamento das saídas, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação em vez de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
Todo rede neural é deep learning?
Não. Uma rede pequena com uma camada oculta é uma rede neural, enquanto deep learning geralmente se refere a arquiteturas com múltiplas etapas de processamento aprendidas. O limite é convencional, não um limiar científico estrito.
Redes neurais armazenam seus dados de treinamento?
Elas armazenam parâmetros aprendidos, não uma cópia pesquisável ordinária do conjunto de dados. No entanto, modelos grandes podem memorizar e reproduzir exemplos individuais de treinamento, o que gera riscos de privacidade e direitos autorais que precisam ser testados.
Referências principais












