
Fundamentos de IA
O que são RNNs e LSTMs em Deep Learning?

 Adicione Unite.AI às suas fontes preferidas no Google
Redes neurais recorrentes (RNNs) processam sequências atualizando um estado oculto ao longo do tempo. Long short-term memory (LSTM) são RNNs com portas projetadas para preservar e controlar informações de forma mais eficaz que uma unidade recorrente básica.
RNNs e LSTMs dominaram muitas tarefas de linguagem, mas os grandes chatbots modernos são baseados principalmente em transformers. Modelos recorrentes continuam úteis para streaming, séries temporais, fala, controle e sistemas com recursos limitados, onde estado incremental e baixa latência são importantes.
Principais conclusões
- Uma RNN reutiliza os mesmos parâmetros em cada passo da sequência e transporta um estado oculto adiante.
- O treinamento ao longo do tempo pode gerar gradientes que desaparecem ou explodem.
- Um LSTM adiciona um estado de célula e portas de entrada, esquecimento e saída.
- Transformers lidam com relações de longo alcance e treinamento paralelo de forma diferente; nenhuma arquitetura é a melhor para todas as implementações.
Como funciona uma RNN básica
No passo t, uma unidade recorrente simples combina a entrada atual xₜ com o estado oculto anterior hₜ₋₁:
hₜ = activation(Wₓxₜ + Wₕhₜ₋₁ + b)
O estado oculto é um resumo aprendido usado no próximo passo e, dependendo da tarefa, como saída. Um diagrama “desenrolado” desenha uma cópia por passo de tempo, mas todas as cópias compartilham parâmetros. A saída não é simplesmente copiada de volta como nova entrada bruta; a recorrência passa o estado oculto por uma transformação definida.
Retropropagação no tempo
RNNs são treinadas com retropropagação no tempo (BPTT). A sequência desenrolada forma um grafo computacional profundo, e a retropropagação calcula como a perda depende dos parâmetros recorrentes compartilhados.
Multiplicações repetidas podem fazer os gradientes encolherem até zero ou crescerem sem limites. Gradientes que desaparecem impedem o aprendizado de dependências longas; gradientes que explodem criam atualizações instáveis. O recorte de gradiente trata gradientes explosivos, enquanto portas, inicialização, normalização e janelas de treinamento mais curtas podem ajudar.
Dentro de uma célula LSTM
Um LSTM mantém um estado de célula cₜ além do estado oculto hₜ. Suas portas são controles aprendidos e dependentes dos dados:
- A porta de esquecimento controla quanto do estado de célula anterior é mantido.
- A porta de entrada controla quanta informação candidata é escrita.
- A porta de saída controla quanta informação da célula contribui para o estado oculto.
Saídas sigmoides entre zero e um atuam como portas suaves, enquanto um candidato transformado por tanh fornece novo conteúdo. O caminho aditivo do estado de célula ajuda os gradientes a persistirem, mas LSTMs não garantem memória ilimitada nem eliminam todos os problemas de otimização.
GRUs e recorrência bidirecional
Uma unidade recorrente com portas (GRU) combina os mecanismos de portas em uma célula recorrente mais simples, sem um estado de célula separado ao estilo LSTM. GRUs podem treinar mais rápido e apresentar desempenho semelhante em algumas tarefas.
Uma RNN bidirecional processa uma sequência completa em ambas as direções e combina os estados. Ela pode usar contexto futuro para rotulação ou codificação, mas é inadequada para streaming causal quando entradas futuras ainda não estão disponíveis.
Modelos sequência‑para‑sequência
RNNs codificador‑decodificador mapeiam uma sequência para outra. Atenção foi introduzida para permitir que um decodificador consulte diferentes estados do codificador ao invés de depender de um vetor fixo. Essa linha de pesquisa levou à arquitetura transformer, que substituiu a recorrência por blocos baseados em atenção.
RNNs versus transformers
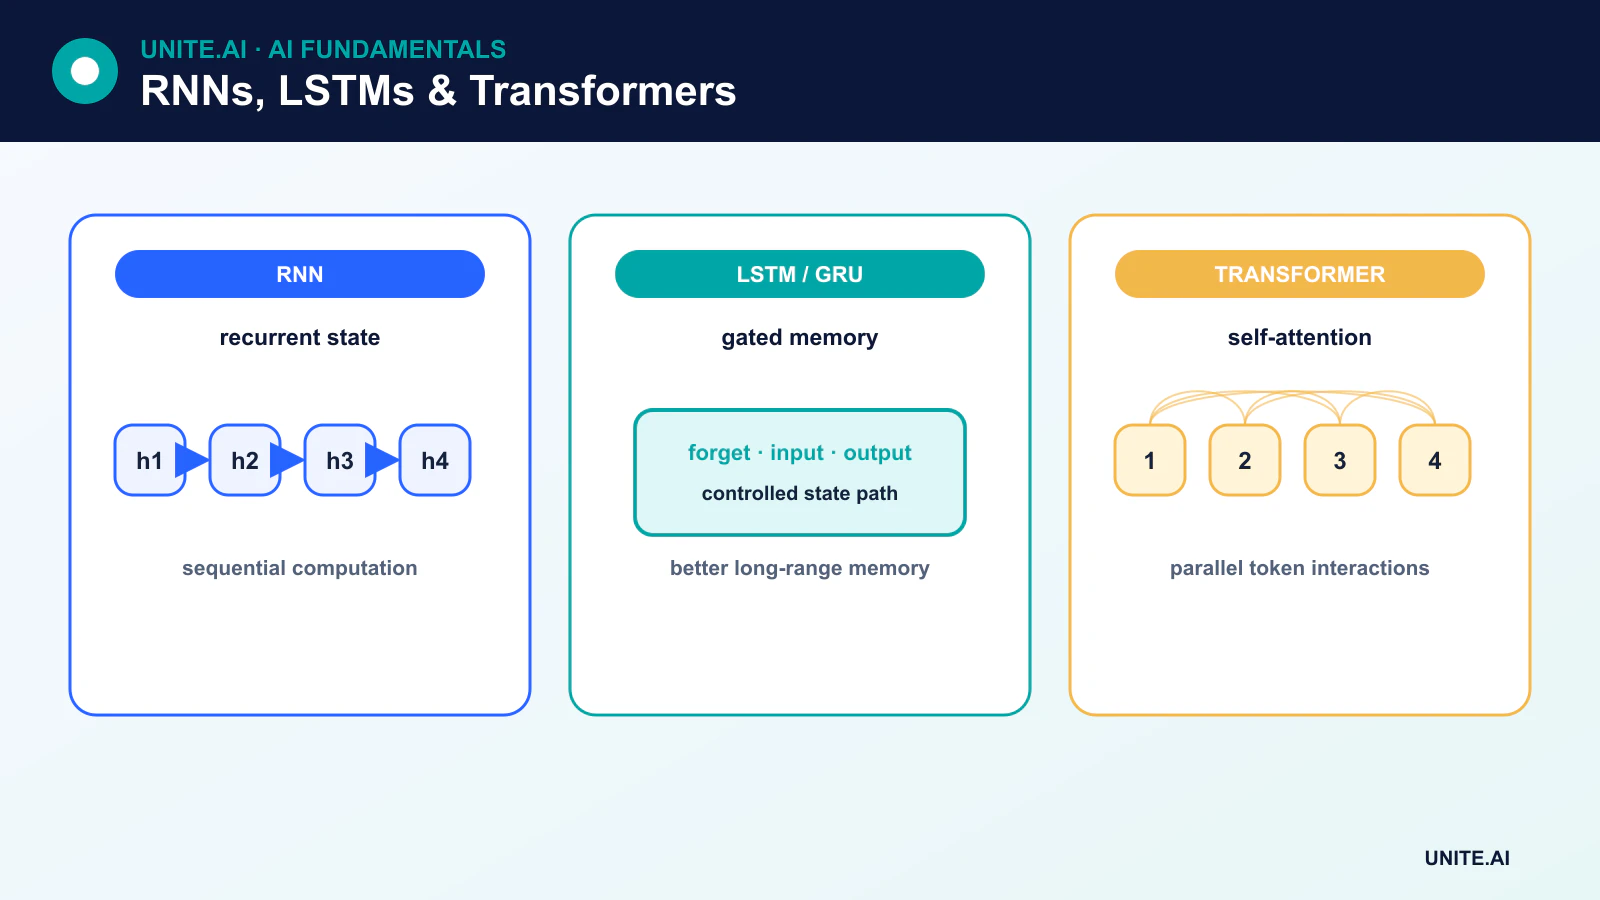
Transformers processam posições de treinamento em paralelo e criam caminhos curtos de atenção entre tokens distantes. RNNs processam o estado sequencialmente, limitando o paralelismo mas oferecendo um estado recorrente de tamanho constante durante streaming. A inferência de transformers pode precisar de um cache de chave‑valor em crescimento, enquanto uma RNN comprime o histórico em seu estado oculto e pode perder detalhes.
Escolha com base no comprimento da sequência, escala de dados, hardware, latência, memória e se a tarefa é offline ou streaming. Arquiteturas híbridas e de espaço de estado oferecem trade‑offs adicionais.
Casos de uso atuais
RNNs e LSTMs continuam relevantes para previsão, detecção de anomalias, processamento de sensores, componentes de fala, escrita manual, controle embarcado e modelagem de sequência de baixa latência. Eles não são a explicação padrão para os atuais grandes modelos de linguagem ou chatbots de IA.
Recorrência, portas e memória de sequência
Uma rede neural recorrente processa uma sequência combinando a entrada atual com um estado oculto transportado dos passos anteriores. Pesos compartilhados permitem comprimentos de sequência variáveis, e o desenrolamento expõe o cálculo ao longo do tempo para treinamento. RNNs básicas podem representar dependência temporal, mas gradientes multiplicados repetidamente ao longo de sequências longas tendem a desaparecer ou explodir. A retropropagação truncada limita memória e computação, enquanto o recorte de gradiente controla atualizações extremas. O estado oculto é um resumo aprendido, não um armazenamento fiel de cada token anterior.
Redes de memória de longo prazo (LSTM) adicionam um estado de célula e portas de entrada, esquecimento e saída que regulam escrita, retenção e exposição de informações. Unidades recorrentes com portas (GRU) usam uma estrutura mais simples de reinicialização e atualização. Variantes bidirecionais usam contexto futuro e, portanto, não podem fazer streaming causal sem atraso. Modelos recorrentes empilhados, residuais e aumentados com atenção aumentam a capacidade. Preenchimento (padding) e máscaras devem impedir que elementos de sequência artificiais afetem o estado ou a perda, e o estado deve ser reiniciado nas verdadeiras fronteiras da sequência para evitar vazamento entre exemplos.
Treinamento, comparação e serviço com estado
RNNs e LSTMs continuam úteis para streaming, modelos compactos em dispositivos, séries temporais e cargas de trabalho onde estado sequencial é eficiente. Transformers paralelizam o treinamento e modelam interações de longo alcance de forma diferente, mas podem exigir mais memória e cache. Compare arquiteturas em acurácia, latência, taxa de transferência, memória, energia e desempenho conforme o comprimento da sequência varia. Avalie previsão com divisões temporais rolantes, linguagem com métricas sensíveis à sequência e detecção de anomalias com medidas ao nível de evento. Inspecione falhas após longas lacunas, mudanças de regime, amostras ausentes e fronteiras de sequência abruptas.
Implantações com estado devem associar o estado oculto à sessão correta, expirá‑lo, criptografá‑lo se sensível e reiniciá‑lo após erros ou mudanças de modelo. Eventos fora de ordem ou duplicados podem corromper o estado; inclua timestamps, números de sequência e idempotência. Monitore a idade do estado, comprimento da sequência, ausências, deriva da saída e latência. A quantização requer validação sensível às portas, pois pequenas mudanças numéricas podem se acumular ao longo do tempo. A memória de RNN permite contexto, mas também pode preservar informações privadas ou desatualizadas, portanto retenção e controles de usuário devem fazer parte do design.
Exemplo prático: um LSTM para sequências de sensores em streaming
Um utilitário usa um LSTM para prever carga de curto prazo a partir de medições recentes, calendário e clima. Sequências são construídas com ordem temporal estrita; o estado oculto é reiniciado nas fronteiras dos alimentadores, e o preenchimento é mascarado. Baselines sazonal‑naïve e impulsionadas por gradiente são comparadas com o LSTM em janelas rolantes. Testes cobrem intervalos ausentes, clima atrasado, feriados, interrupções e comprimentos de sequência além do treinamento típico.
O serviço de streaming associa o estado a um alimentador, rejeita duplicatas fora de ordem e expira o estado após longas lacunas ou atualizações de modelo. Uma previsão estatística segura substitui a saída quando sensores ou estado são inválidos. A inferência quantizada é verificada em sequências longas para detectar deriva acumulada. O monitoramento rastreia a idade do estado, ausências, latência, viés e erro de intervalo. O modelo é re‑treinado apenas após mudanças na rede e os resultados revisados mostram que as relações temporais aprendidas não generalizam mais.
Evidências de implementação e prontidão operacional
Uma decisão de produção requer mais do que uma demonstração bem‑sucedida. Defina os usuários pretendidos, ambiente operacional, entradas, saídas, dependências, responsável e a consequência de cada falha importante. Estabeleça uma linha de base reproduzível e um conjunto de avaliação versionado antes do ajuste. Teste casos ordinários, condições de fronteira, entrada malformada ou ausente, mudança de distribuição, falha de dependência, uso indevido e os grupos ou ambientes mais propensos a serem negligenciados. Meça a qualidade da tarefa juntamente com calibração ou incerteza, latência, taxa de transferência, custo de recursos, acessibilidade, privacidade e segurança. Registre cada transformação e limiar para que um revisor independente possa reproduzir o resultado e distinguir evidência de um protótipo atraente.
Antes do lançamento, atribua autoridade para liberação, exceções, mudanças, rollback e aposentadoria. Use um rollout em etapas, preserve um fallback seguro e verifique o monitoramento com falhas injetadas deliberadamente. A telemetria operacional deve revelar a qualidade da entrada, comportamento da saída, versão do modelo ou regra, saúde das dependências, intervenções humanas e resultados confirmados sem coletar dados sensíveis desnecessários. Defina limites de alerta e um responsável pela resposta, depois revise evidências do mundo real após a implantação ao invés de assumir que o desempenho offline persistirá. Reavalie sempre que fontes de dados, usuários, modelos, fornecedores, políticas, hardware ou objetivos mudarem. Um sistema mantido também precisa de recuperação documentada, aprendizado de incidentes, procedimentos de exclusão e retenção, e um ponto claro em que deve ser desativado ou substituído.
Perguntas frequentes
Um LSTM é sempre melhor que uma RNN básica?
Não. Portas ajudam em muitos problemas de dependência longa, mas adicionam computação e parâmetros. Uma RNN básica pode ser adequada para sequências curtas e simples, e outra arquitetura pode ser melhor para contextos muito longos.
Um LSTM pode processar um histórico ilimitado?
Não. Seu estado tem capacidade finita, gradientes e dados de treinamento impõem limites, e detalhes relevantes podem ser sobrescritos. O desempenho em contextos longos deve ser medido em vez de inferido a partir do nome da arquitetura.
Referências principais












