
Grundlagen der KI
Wie funktioniert die Bildklassifizierung?

 Unite.AI zu deinen bevorzugten Quellen auf Google hinzufügen
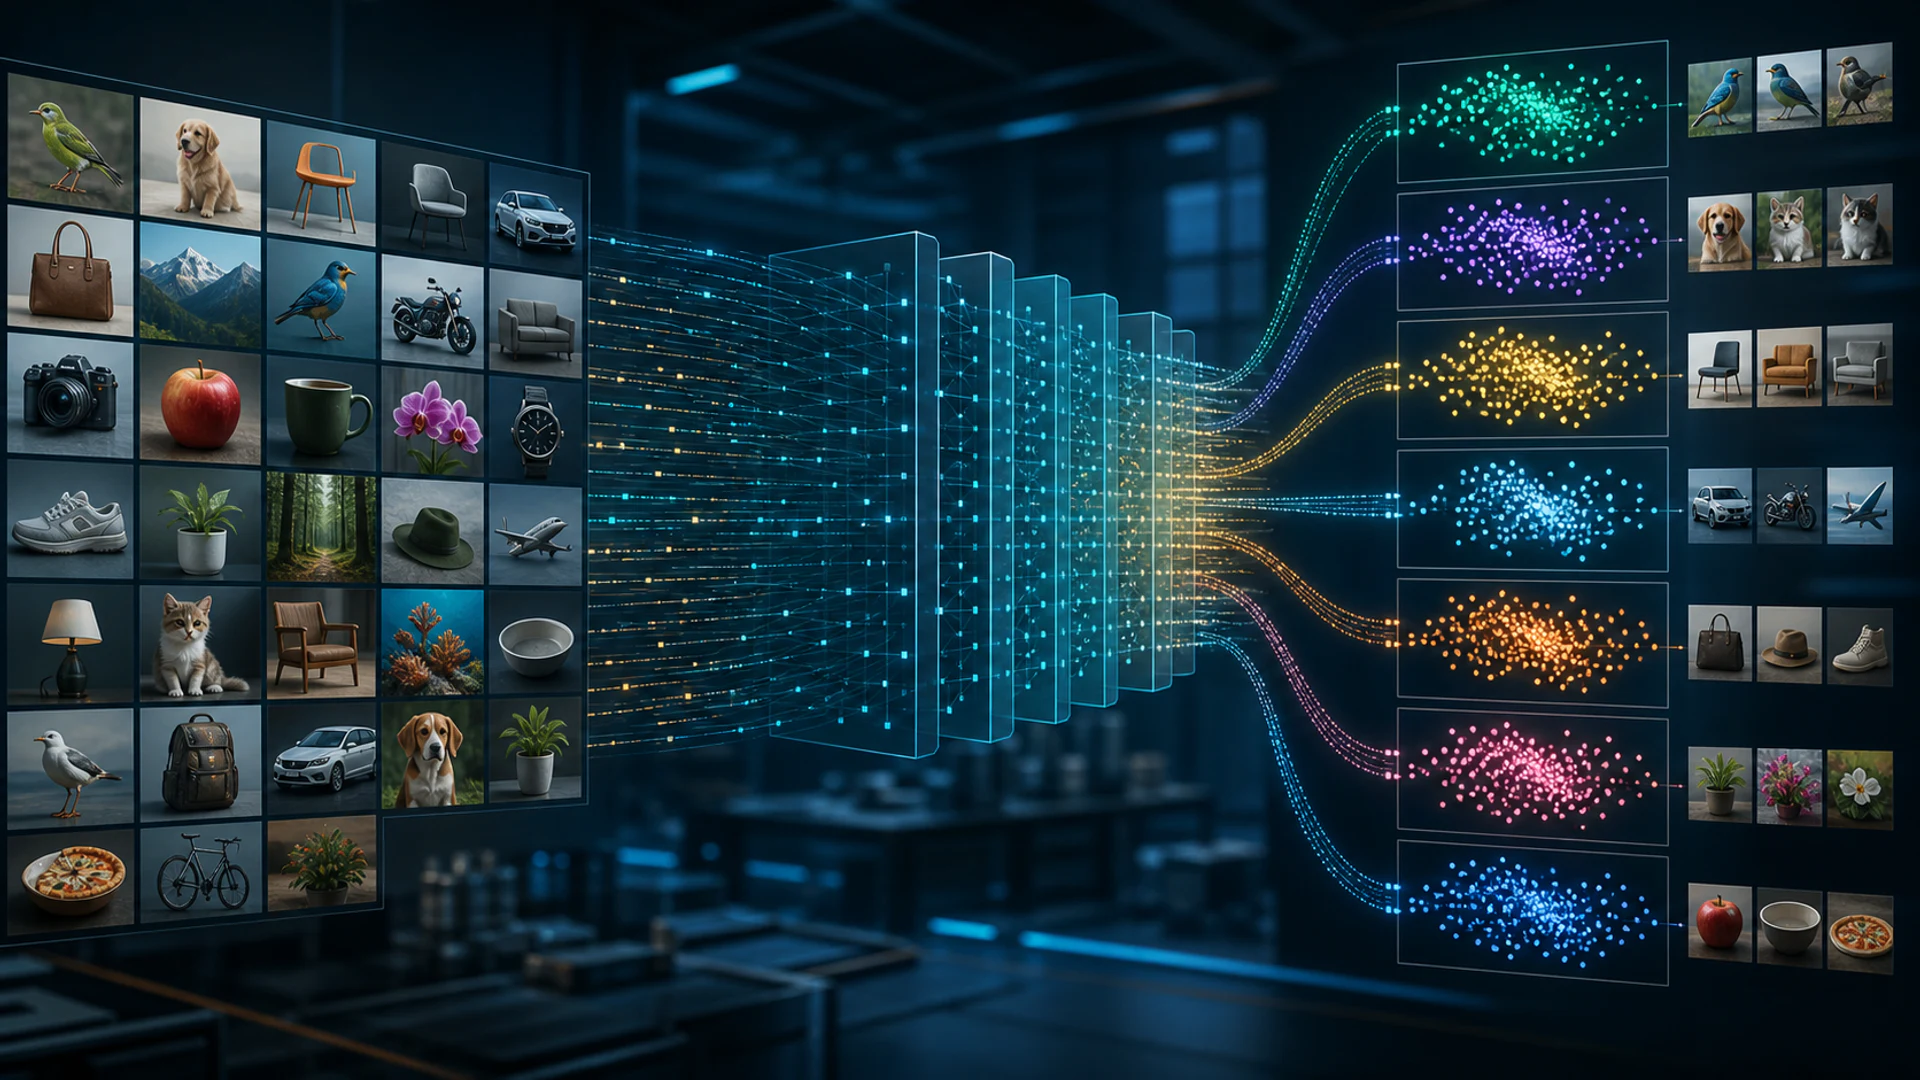
Bildklassifizierung sagt ein Label für ein ganzes Bild voraus. Sie beantwortet Fragen wie „Welche Produktkategorie wird gezeigt?“ oder „Enthält dieser Scan ein Zielobjekt?“ Sie lokalisiert jedoch nicht jedes Objekt und zeichnet dessen Pixel nicht nach.
Moderne Systeme verwenden häufig konvolutionale neuronale Netze oder Vision Transformers, oft mit vortrainierten Gewichten initialisiert. Zuverlässige Leistung hängt weiterhin von Labels, Stichproben, Datenaugmentation, Kalibrierung und Tests unter realen Einsatzbedingungen ab.
Wesentliche Erkenntnisse
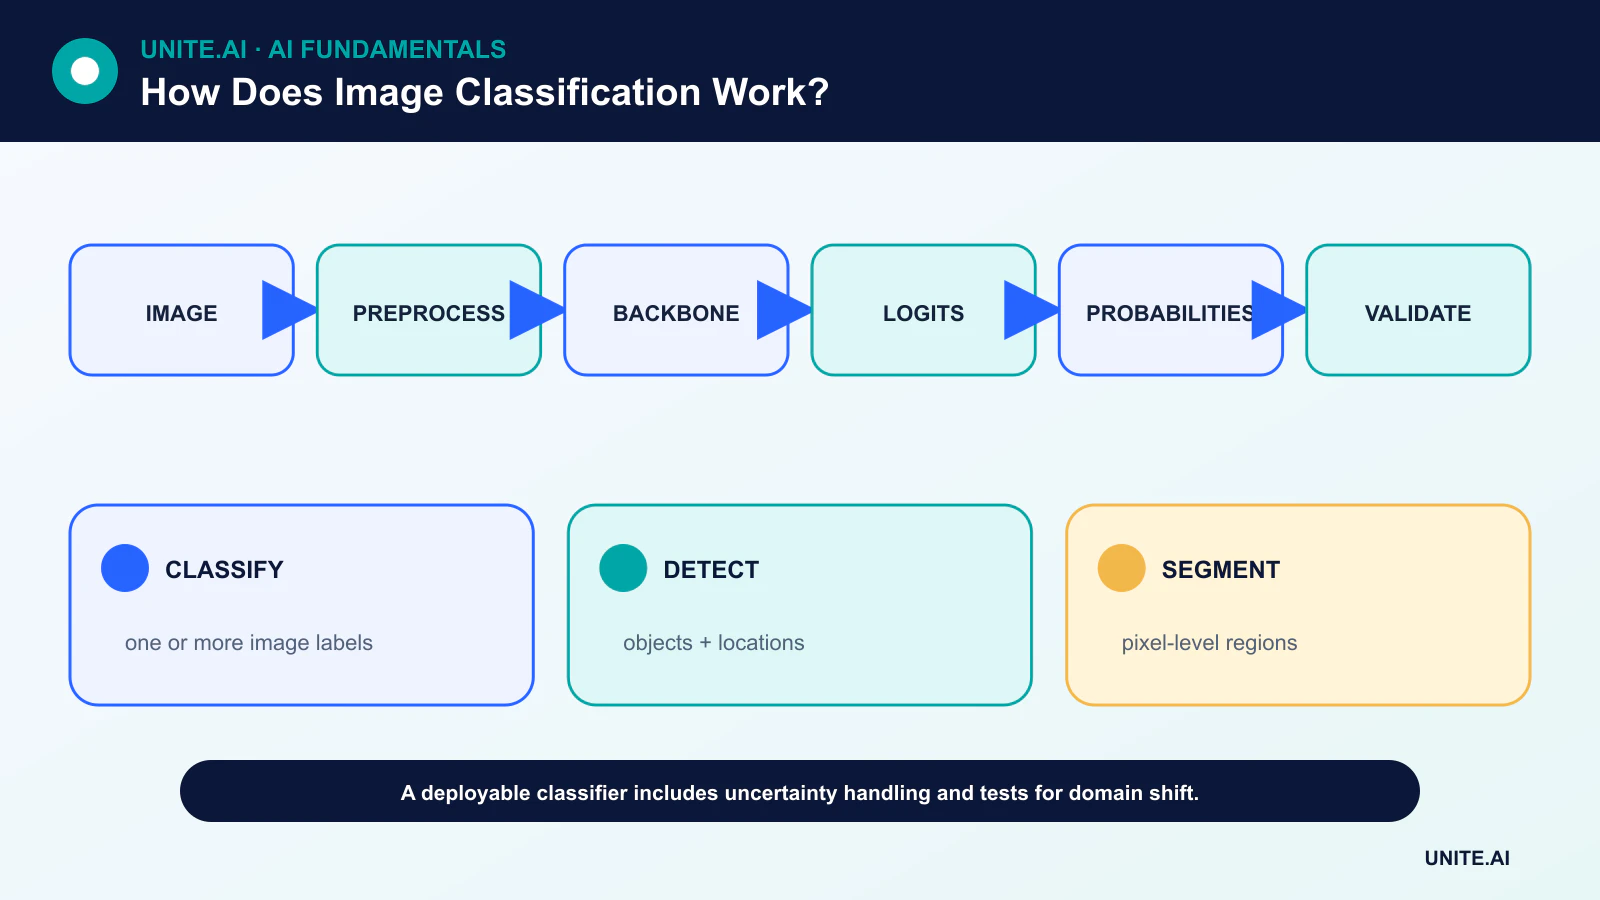
- Die Klassifizierung versieht das gesamte Bild mit einem Label; die Erkennung zeichnet Objektboxen und die Segmentierung weist Pixel‑Level‑Regionen zu.
- Vortraining und Transferlernen können den Datenbedarf reduzieren, doch ein Domänen‑Mismatch kann den Nutzen zunichtemachen.
- Die reine Genauigkeit kann Klassenungleichgewicht, irreführende Abkürzungen und schlechte Kalibrierung verbergen.
- Bildqualität, Aufnahmeeinrichtung, geografische Lage und Änderungen im Arbeitsablauf können alle zu einer Verteilungsverschiebung führen.
Von Pixeln zu Punktzahlen
Bilder werden skaliert oder zugeschnitten, normalisiert und in Tensoren umgewandelt. Datenaugmentation kann label‑erhaltende Transformationen wie Spiegelungen, Zuschnitte oder Farbänderungen anwenden. Ein Backbone wandelt Pixel in Merkmale um; ein Klassifikations‑Head erzeugt Logits, die in relative Klassen‑Scores umgerechnet werden.
Die gewählte Vorverarbeitung muss zum Einsatz passen. Ein Center‑Crop, das das relevante Objekt entfernt, oder ein Normalisierungs‑Mismatch können die Leistung beeinträchtigen, selbst wenn die trainierten Gewichte unverändert bleiben.
CNNs und Vision Transformers
Convolutional neural networks nutzen lokale Filter und geteilte Gewichte, um räumliche Merkmale zu erzeugen. Residual‑Verbindungen erleichtern die Optimierung sehr tiefer CNNs. Vision Transformers teilen ein Bild in Patches auf und verwenden Attention, um die Beziehungen zwischen ihnen zu modellieren.
Architekturvergleiche sollten Trainingsdaten, Augmentation, Rechenleistung und Auflösung kontrollieren. Das beste Modell in einem öffentlichen Benchmark ist möglicherweise nicht optimal für ein Edge‑Gerät, einen kleinen Datensatz oder Anforderungen an die Erklärbarkeit.
Transferlernen und Datenaufbau
Transfer learning beginnt mit Gewichten, die auf einem größeren Quell‑Datensatz trainiert wurden. Ein Team kann den Backbone einfrieren, spätere Schichten feinabstimmen oder das gesamte Modell aktualisieren. Feinabstimmung erfordert in der Regel eine niedrigere Lernrate und einen Validierungssatz, der Leckagen verhindert.
Labels sollten beschreiben, was visuell ableitbar ist. Wenn eine Diagnose von der Patienten‑Historie abhängt, die im Bild nicht ersichtlich ist, kann der Klassifikator die vollständige klinische Entscheidung nicht erlernen. Duplikate, Frames aus demselben Video und Bilder derselben Person müssen im selben Split bleiben.
Metriken, Unsicherheit und Abkürzungen
Top‑1‑Genauigkeit erfordert, dass die höchstbewertete Klasse korrekt ist; Top‑k‑Genauigkeit akzeptiert die korrekte Klasse unter den k höchsten Scores. Präzision, Recall pro Klasse und eine Verwirrungsmatrix zeigen ungleichmäßige Fehler.
Modelle können Hintergründe, Wasserzeichen, Aufnahmeequipment oder Bildrahmen ausnutzen, anstatt das beabsichtigte Objekt zu berücksichtigen. Kontrafaktische Tests, Subgruppen‑Analysen und Salienz‑Tools können helfen, Abkürzungen zu entdecken, doch eine Erklärungs‑Heatmap ist kein Beweis für kausales Schließen.
Monitoring beim Einsatz
Produktionsprüfungen sollten beschädigte Dateien, unerwartete Abmessungen, Unschärfe, Beleuchtung, Kameramodelle und neue Klassen abdecken. Das Vertrauen sollte auf deployments‑ähnlichen Daten kalibriert werden, und Eingaben außerhalb des Anwendungsbereichs sollten abgelehnt oder überprüft werden.
Die Überwachung verzögerter Labels und Änderungen der Fehlkosten ist essenziell. Ein Modell, das anhand von Eingabestatistiken stabil erscheint, kann dennoch versagen, wenn sich die Beziehung zwischen Pixeln und Labels ändert.
Erstellung eines Bildklassifizierungs‑Datensatzes
Bildklassifizierung weist einem gesamten Bild ein oder mehrere Labels zu. Sie unterscheidet sich von der Erkennung, die Objekte lokalisiert, und von der Segmentierung, die Pixel labelt. Definieren Sie den Klassenumfang, die Hierarchie, Multi‑Label‑Regeln, Hintergrund‑ oder Unbekannt‑Kategorien und welche Evidenz sichtbar sein muss. Sammeln Sie deployments‑repräsentative Kameras, Standorte, Beleuchtung, Blickwinkel, Entfernungen und Motive. Teilen Sie nach Motiv, Szene, Sitzung oder Quelle vor der Augmentation; benachbarte Videoframes oder duplizierte Produktbilder über Partitionen hinweg verursachen gravierende Leckagen.
Anleitungs‑Hinweise für die Annotation sollten Okklusion, mehrdeutige Objekte, mehrere Klassen, niedrige Qualität und Ablehnung abdecken. Messen Sie die Übereinstimmung und prüfen Sie systematische Diskrepanzen. Klassenbalance allein garantiert keine Abdeckung: eine Krankheitsklasse kann nur ein Gerät enthalten, eine Wildtierklasse nur einen Hintergrund. Prüfen Sie Metadaten und nahe Duplikate und behalten Sie einen geschützten Test‑Set aus unabhängiger Erfassung. Synthetische Daten und Web‑Scraping können die Vielfalt erweitern, bringen jedoch Lizenz‑, Herkunfts‑, Stil‑ und Label‑Probleme mit sich, die an realen Bildern gemessen werden müssen.
Modelle, Training und Evaluation
Klassische Methoden kombinieren handgefertigte Deskriptoren mit einem Klassifikator; moderne Systeme nutzen konvolutionale Netze oder Vision Transformers, häufig mittels Transferlernen. Entscheidungen zu Skalierung und Zuschnitt bestimmen, welche Informationen erhalten bleiben. Augmentation sollte gültige Variationen widerspiegeln und Labels bewahren. Optimieren Sie einen auf die Aufgabe abgestimmten Loss, behandeln Sie Ungleichgewichte durch Gewichtung oder sorgfältige Stichproben und wählen Sie Checkpoints anhand von Validierungsdaten. Vergleichen Sie mit einer einfachen Basislinie und entfernen Sie Augmentation, Auflösung und vortrainierte Initialisierung, um zu verstehen, wo die Verbesserungen herkommen.
Berichten Sie über Präzision, Recall, F1, Verwirrung, Top‑k‑Genauigkeit (wenn relevant), Kalibrierung und Leistung nach Bedingungen pro Klasse. Testen Sie Unschärfe, Kompression, Beleuchtung, Zuschnitt, Okklusion, Gerät und Eingaben ohne unterstützte Klasse. Konfidenz‑Schwellen können unsichere Fälle zur Überprüfung weiterleiten; Softmax‑Wahrscheinlichkeit ist kein garantierter Vertrauenswert, besonders bei Verschiebungen. Kontrafaktische Hintergründe und Okklusionstests zeigen das Erlernen von Abkürzungen. Für sicherheitsrelevante Anwendungen evaluieren Sie Worst‑Case‑Fehler und die Konsequenzen von Fehlalarmen und Fehlnegativen.
Einsatz und Monitoring
Packen Sie Dekodierung, Farbkonvertierung, Orientierung, Normalisierung, Modell und Label‑Map zusammen. Validieren Sie das exportierte oder quantisierte Artefakt auf Zielgeräten und messen Sie End‑zu‑End‑Latenz, Speicher, Energieverbrauch und Durchsatz. Überwachen Sie Bildqualität, Eingabe‑ und Ausgabe‑Verteilungen, Kalibrierung, bestätigte Labels und Sensor‑Gesundheit. Minimieren und sichern Sie die Bildaufbewahrung, insbesondere für Gesichter, Standorte und Passanten. Stellen Sie ein Fallback für beschädigte oder außerhalb des Anwendungsbereichs liegende Eingaben bereit und rollen Sie Modellversionen zurück. Die Klassifizierung beantwortet die definierte Bild‑Ebene‑Frage; sie sollte nicht zu nicht unterstützter Lokalisierung, Identität oder Intent‑Ansprüchen ausgedehnt werden.
Praktisches Beispiel: Klassifizierung von recycelbaren Materialien
Eine Anlage fotografiert Gegenstände auf einem Förderband und kennzeichnet Materialklasse, Kontamination und Unbekanntes. Bilder werden nach Sammel‑Tag und Objekt‑Batch aufgeteilt, wobei Beleuchtung, nasse Oberflächen, Zerknittern, Überlappungen und leere Bänder berücksichtigt werden. Ein kleines CNN und ein vortrainiertes Modell werden mit Farb‑ und Formregeln verglichen. Per‑Klasse‑Recall, Fehl‑Sortierung, Kalibrierung, Durchsatz und Ergebnisse nach Kamera und Materialzustand bestimmen die Auswahl.
Die Produktionspipeline prüft Kamera‑Belichtung und Band‑Timing und leitet unsichere Gegenstände in einen allgemeinen Strom weiter, anstatt eine Klasse zu erzwingen. Quantisierte Inferenz wird auf exakt derselben Hardware validiert. Das Monitoring verfolgt Eingabequalität, Klassenraten, Ablehnungen und stichprobenartige manuelle Audits; neue Verpackungen lösen ein überprüftes Daten‑Update aus. Das Modell steuert einen begrenzten Sortierer mit physischen Schutzvorrichtungen, und ein Sensor‑ oder Modell‑Fehler versetzt den Mechanismus in einen sicheren Zustand, anstatt das Material stillschweigend falsch zu leiten.
Nachweis der Implementierung und betriebliche Bereitschaft
Eine Produktionsentscheidung erfordert mehr als eine erfolgreiche Demonstration. Definieren Sie die vorgesehenen Nutzer, das Betriebsumfeld, Eingaben, Ausgaben, Abhängigkeiten, den Eigentümer und die Konsequenz jedes wichtigen Fehlers. Etablieren Sie eine reproduzierbare Basislinie und einen versionierten Evaluations‑Set vor dem Tuning. Testen Sie reguläre Fälle, Randbedingungen, fehlerhafte oder fehlende Eingaben, Verteilungsverschiebungen, Ausfall von Abhängigkeiten, Fehlgebrauch und die Gruppen oder Umgebungen, die am wahrscheinlichsten unzureichend versorgt werden. Messen Sie die Aufgabenqualität zusammen mit Kalibrierung oder Unsicherheit, Latenz, Durchsatz, Ressourcen‑Kosten, Zugänglichkeit, Datenschutz und Sicherheit. Dokumentieren Sie jede Transformation und Schwelle, damit ein unabhängiger Prüfer das Ergebnis reproduzieren und Evidenz von einem attraktiven Prototyp unterscheiden kann.
Vor dem Rollout weisen Sie Zuständigkeiten für Veröffentlichung, Ausnahmen, Änderungen, Rollback und Stilllegung zu. Nutzen Sie ein gestuftes Rollout, bewahren Sie ein sicheres Fallback und prüfen Sie das Monitoring mit bewusst eingebrachten Fehlfunktionen. Operative Telemetrie sollte Eingabequalität, Ausgabeverhalten, Modell‑ oder Regel‑Version, Abhängigkeits‑Gesundheit, menschliche Overrides und bestätigte Ergebnisse offenlegen, ohne unnötige sensible Daten zu sammeln. Definieren Sie Alarm‑Schwellen und einen Verantwortlichen für die Reaktion und prüfen Sie anschließend reale Evidenz nach dem Einsatz, anstatt anzunehmen, dass Offline‑Leistung anhält. Evaluieren Sie neu, sobald Datenquellen, Nutzer, Modelle, Anbieter, Richtlinien, Hardware oder Ziele sich ändern. Ein gepflegtes System benötigt zudem dokumentierte Wiederherstellungs‑, Incident‑Lern‑, Lösch‑ und Aufbewahrungs‑Verfahren sowie einen klaren Punkt, an dem es deaktiviert oder ersetzt werden soll.
Häufig gestellte Fragen
Kann ein Bildklassifikator mehrere Objekte identifizieren?
Ein Mehrklassen‑Klassifikator kann angeben, welche Kategorien vorhanden sind, lokalisiert jedoch keine einzelnen Instanzen. Für Boxen oder Zählungen ist eine Objekterkennung erforderlich.
Warum kann ein Modell bei Fotos versagen, die für eine Person normal aussehen?
Er kann sich auf Aufnahme‑Artefakte, Texturen oder Korrelationen stützen, die sich geändert haben. Kleine Unterschiede in der Vorverarbeitung und Domänenschift können ebenfalls die gelernten Merkmale beeinflussen.
Primärreferenzen












