Основы ИИ
Что такое машинное обучение?

 Добавьте Unite.AI в избранные источники в Google
Машинное обучение (ML) — это отрасль искусственного интеллекта, в которой система извлекает закономерности из данных, чтобы делать предсказания, классификации, рекомендации или принимать решения без того, чтобы разработчик писал отдельное правило для каждого возможного случая. Результат не представляет собой машину, «мыслящую» как человек. Это статистическая модель, сопоставляющая входы с полезными выходами и способная оцениваться на данных, которые она не видела во время обучения.
Машинное обучение находится внутри более широкой области ИИ, тогда как глубокое обучение представляет собой семейство методов машинного обучения, построенных вокруг многослойных нейронных сетей. Это различие имеет значение: не каждая система ИИ использует МЛ, и не каждая задача МЛ требует нейронной сети.
Ключевые выводы
- МЛ изучает взаимосвязи на основе примеров, а не полагается исключительно на вручную написанные правила.
- Полезная модель должна обобщать новые данные, а не просто запоминать обучающий набор.
- Контролируемое, неконтролируемое, полуконтролируемое, самоконтролируемое и обучение с подкреплением решают разные типы задач.
- Качество данных, дизайн оценки и мониторинг так же важны, как и алгоритм.
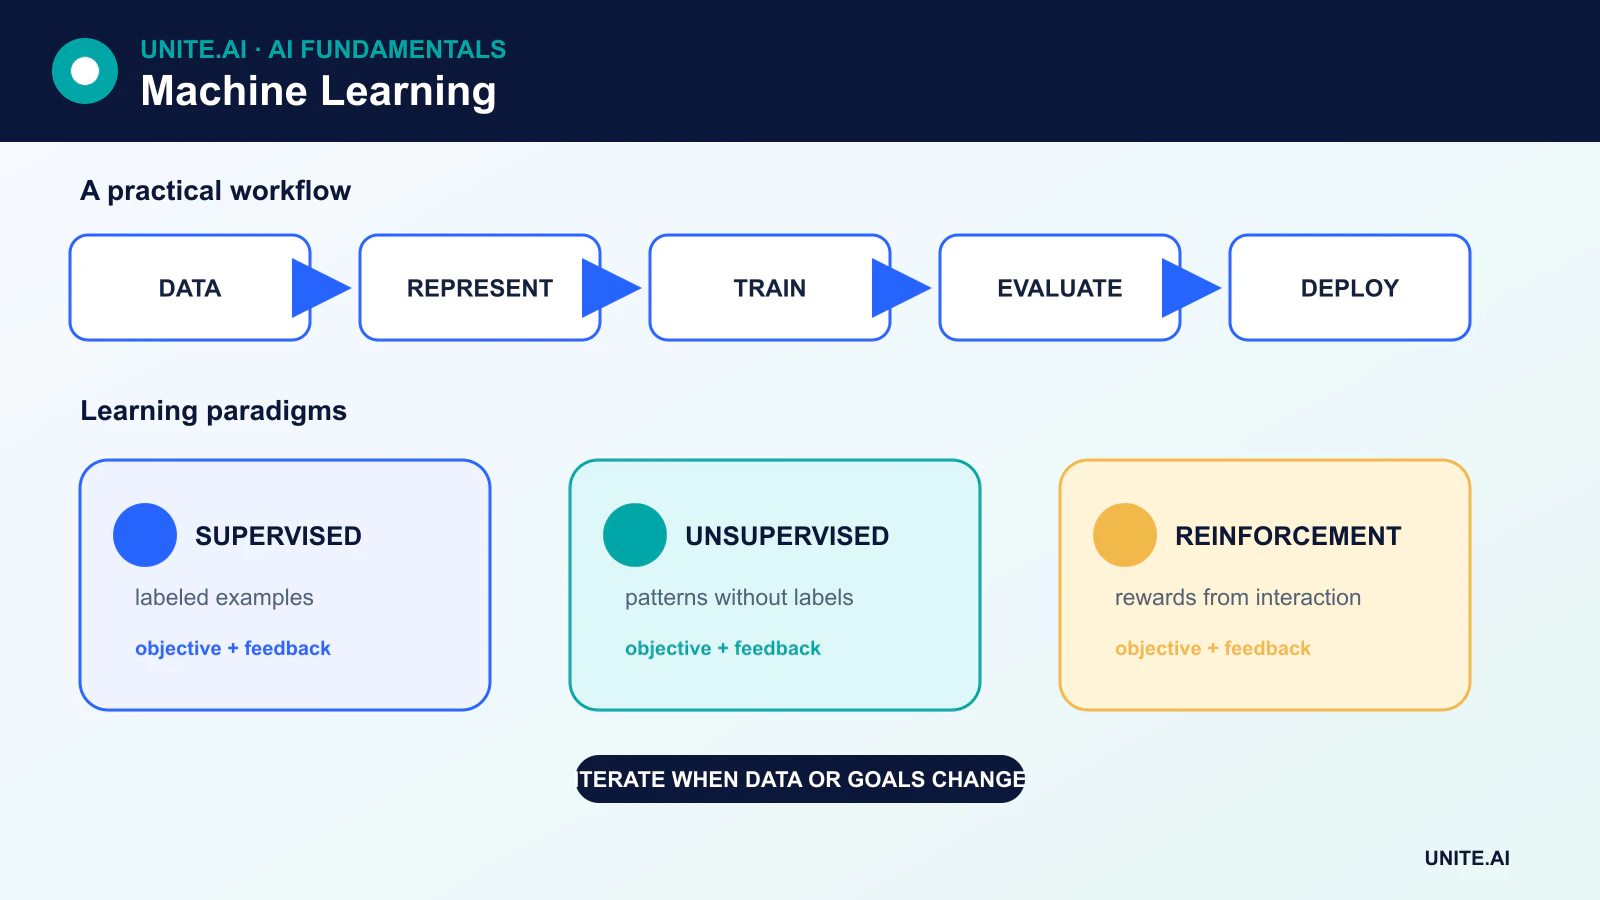
Как работает машинное обучение
Большинство проектов МЛ можно представить как последовательность шести этапов:
- Определить задачу. Решите, что система должна предсказывать или обнаруживать, и что считается успехом в реальном применении.
- Собрать и подготовить данные. Очистите записи, обработайте пропущенные значения, создайте полезные признаки и задокументируйте источник данных.
- Разделить данные. Обучающий набор используется для подгонки модели, набор валидации помогает выбрать параметры, а тестовый набор дает окончательную оценку на невидимых данных.
- Обучить модель. Алгоритм корректирует параметры модели, чтобы уменьшить функцию потерь или удовлетворить другую цель обучения.
- Оценить обобщаемость. Метрики должны отражать задачу, баланс классов, стоимость ошибок и популяцию, в которой будет работать модель.
- Развернуть и мониторить. Данные в реальном мире могут изменяться, поэтому команды следят за дрейфом, ухудшением производительности, предвзятостью и операционными сбоями.
Переменные, подаваемые в модель, обычно называют признаками. В контролируемом обучении желаемый ответ называется меткой или целью. Выученные параметры модели кодируют взаимосвязь между признаками и выходом; они не представляют собой базу явных правил.
Основные парадигмы обучения
Контролируемое обучение
В контролируемом обучении примеры содержат как входы, так и известные цели. Классификационная модель предсказывает категории, например, является ли транзакция мошеннической. Регрессионная модель предсказывает непрерывное значение, например, ожидаемый спрос на энергию.
К распространённым алгоритмам контролируемого обучения относятся деревья решений, машины опорных векторов, метод k-ближайших соседей, линейная и логистическая регрессия, градиентный бустинг деревьев и нейронные сети. Порог классификации, например 0,5, — это решение, принимаемое после того, как модель выдаёт оценку или вероятность; он не является неизменным свойством логистической регрессии.
Неконтролируемое обучение
Неконтролируемое обучение работает с данными, не содержащими целевых меток. Цель может заключаться в поиске кластеров, обнаружении аномальных наблюдений, оценке распределения или создании представления в более низком измерении. Кластер — это группа, предложенная правилом схожести; она не автоматически является значимым реальным классом.
Примеры включают кластеризацию k-средних, метод главных компонент, оценку плотности и некоторые формы автокодировщиков. Автокодировщик обучается восстанавливать свой ввод через сжатое представление. Он не создаёт автоматически истинные метки.
Полуконтролируемое и самоконтролируемое обучение
Полуконтролируемое обучение сочетает небольшой набор размеченных данных с большим набором неразмеченных. Самоконтролируемое обучение создает обучающий сигнал из самих данных — например, предсказывая скрытые слова или сопоставляя два преобразованных представления одного изображения. Самоконтроль является центральным в многих современных конвейерах трансформеров и фундаментальных моделей, поскольку позволяет использовать большие коллекции текста, изображений, аудио или видео без ручной разметки каждого примера.
Обучение с подкреплением
В обучении с подкреплением агент совершает действия в среде и получает вознаграждения или издержки. Цель — выучить политику, максимизирующую ожидаемое совокупное вознаграждение. Это отличается от контролируемого обучения тем, что правильное действие не предоставляется для каждого состояния, и действие может влиять на то, какие данные агент будет получать дальше.
Обучение, валидация и обобщаемость
Модель, хорошо работающая на обучающих примерах, всё равно может провалиться на новых данных. Этот провал известен как переобучение. Команды снижают его с помощью соответствующей ёмкости модели, регуляризации, кросс‑валидации, аугментации данных, предотвращения утечек и действительно независимого тестового набора.
Для каждой задачи МЛ нет единой метрики. Для классификации могут потребоваться точность, полнота, F1, калибровка или взвешенная по стоимости мера вместо простой точности. Для регрессии могут использоваться средняя абсолютная ошибка, корень средней квадратичной ошибки или специфическая для области функция потерь. Для кластеризации требуются различные формы внутренней или внешней валидации. Метрика должна отражать, что ошибка значит для пользователя или организации.
Алгоритмы машинного обучения — это инструменты, а не гарантии
Алгоритм несёт в себе предположения. Линейные модели предполагают определённую форму взаимосвязи. Метод k‑ближайших соседей предполагает, что выбранное расстояние отражает значимую схожесть. Наивный Байес предполагает условную независимость признаков при заданном классе. Деревья решений делят пространство признаков с помощью выученных правил разбиения; их листы содержат предсказания, основанные на группах обучающих наблюдений, а не обязательно на одном наблюдении.
Следовательно, выбор модели зависит от объёма данных, типов признаков, требований к задержке, необходимости интерпретируемости и стоимости ошибок. Более простая модель может превзойти более сложную, когда данные ограничены или операционные ограничения отдают предпочтение скорости и прозрачности.
Где применяется машинное обучение
МЛ поддерживает ранжирование поиска, рекомендации, прогнозирование, обнаружение аномалий, перевод, распознавание речи, компьютерное зрение, предиктивное обслуживание, обнаружение мошенничества и научный анализ. Те же техники могут усиливать историческую предвзятость, раскрывать конфиденциальную информацию или вести себя непредсказуемо при смещении распределения. Ответственное развертывание требует документации, человеческого контроля там, где это уместно, тестирования безопасности и постоянного мониторинга.
От определения проблемы к валидному эксперименту машинного обучения
Проект машинного обучения должен начинаться с принятия решения и измеримого результата, а не с выбора алгоритма. Определите единицу предсказания, цель, время наблюдения, время принятия решения, доступные признаки и стоимость каждой ошибки. Например, для модели оттока использование событий, записанных после отмены, приведёт к утечке ответа. Установите простое правило или статистическую базу, затем разделите данные по времени, клиенту, местоположению или иной границе, отражающей развертывание. Случайные разбиения строк могут разместить почти идентичные наблюдения в обучающем и тестовом наборах, создавая вводящий в заблуждение показатель.
Инжиниринг признаков преобразует сырые записи в представления, пригодные для модели, но каждый признак требует происхождения и гарантии доступности. Нормализацию, словарь, имputation и понижение размерности следует выполнять только на обучающих данных, а затем применять выученное преобразование к данным валидации и теста. Кросс‑валидация оценивает вариативность между выборками; окончательный неизменённый тестовый набор поддерживает решение о выпуске. Выбирайте метрики в зависимости от последствий: точность и полнота для неравномерных ошибок классификации, калибровка, когда вероятности влияют на действия, и взвешенные по стоимости или полезности меры, когда ошибки имеют разные операционные последствия.
Развертывание, мониторинг и ответственная эксплуатация
Вывод в продакшн повторяет полное преобразование, выполненное во время обучения, и возвращает предсказание в рамках ограничений по задержке, пропускной способности и доступности. Упакуйте предобработку вместе с моделью, проверьте схемы входных данных, версионируйте артефакты и сравните результаты между офлайн‑реализацией и обслуживанием. Выбирайте порог, исходя из эксплуатационной ёмкости и компромисса ошибок, а не по умолчанию 0,5. Выполняйте развертывание через теневую оценку, ограниченную когорту или эксперимент с контрольными метриками. Сохраняйте детерминированный резервный вариант и путь отката на случай сбоя зависимости или недопустимого поведения.
Следите за качеством входных данных, дрейфом признаков, распределением предсказаний, калибровкой, результатами подгрупп, задержкой, стоимостью и подтверждёнными метками, когда они поступают. Дрейф — это сигнал к исследованию, а не автоматическое доказательство того, что переобучение поможет. Переобучение требует проверки данных, повторяемых тестов, одобрения и сравнения с текущим лидером. Документируйте предполагаемые и недопустимые применения, права на данные, конфиденциальность, безопасность, возможность человеческого вмешательства и обжалования, когда затронуты люди. Машинное обучение — это поддерживаемая система принятия решений; файл модели — лишь один заменяемый компонент.
Практический пример: предсказание отказа оборудования
Производитель определяет одно предсказание на машину‑день: произойдёт ли подтверждённый отказ в течение семи дней, используя только телеметрию, доступную в начале дня. Данные разделяются по машине и времени, сравниваются с правилами, основанными на возрасте и порогах, предобработка подгоняется на обучающих данных, а оцениваются полнота событий, ложные сигналы, время предупреждения, калибровка и пропускная способность обслуживания. Замена датчиков и плановые отключения моделируются как контекст эксплуатации, а не рассматриваются как обычные наблюдения.
Модель сначала работает в теневом режиме. Оповещения показывают contributing telemetry и степень неопределённости, но обслуживающий персонал решает, проводить ли проверку. Выводы и подтверждённые причины становятся управляемыми метками; отсутствие наряд‑заказа не считается доказательством отсутствия отказа. Поэтапное развертывание использует лимиты оповещений и ручной резерв, в то время как мониторинг отслеживает состояние датчиков, дрейф входных данных, проверенную точность, простои и ненужное обслуживание. Переобучение происходит только после того, как проверка данных и порогов демонстрирует вероятное улучшение по сравнению с текущей развернутой системой.
Доказательства внедрения и готовность к эксплуатации
Решение о внедрении требует большего, чем успешная демонстрация. Определите целевых пользователей, эксплуатационную среду, входы, выходы, зависимости, владельца и последствия каждой важной ошибки. Установите воспроизводимую базовую линию и версионированный набор для оценки до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входные данные, смещение распределения, сбой зависимости, неправильное использование и группы или среды, которые, скорее всего, будут обслуживаться недостаточно. Оценивайте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Зафиксируйте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапное развертывание, сохраняйте безопасный резерв и проверяйте мониторинг с преднамеренно введёнными сбоями. Оперативная телеметрия должна раскрывать качество входных данных, поведение выходов, версию модели или правила, состояние зависимостей, человеческие вмешательства и подтверждённые результаты без сбора ненужных конфиденциальных данных. Определите пороги оповещений и ответственного за реакцию, затем проверяйте реальные доказательства после развертывания, а не полагайтесь на сохранение офлайн‑производительности. Переоценивайте при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также требует документированного восстановления, обучения на инцидентах, процедур удаления и хранения, а также чёткой точки, в которой её следует отключить или заменить.
Основные ссылки