
Основы ИИ
Что такое глубокое обучение?

 Добавьте Unite.AI в избранные источники в Google
Глубокое обучение — это семейство методов машинного обучения, использующих нейронные сети с несколькими слоями обработки для обучения полезным представлениям данных. Эти модели являются движущей силой многих современных систем для языка, изображений, аудио, рекомендаций, научных предсказаний и генеративного ИИ.
Слово deep относится к количеству преобразований между входом и выходом, а не к машине, обладающей более глубоким пониманием. Глубокая модель изучает числовые взаимосвязи, полезные для её цели обучения, и её производительность всё равно должна проверяться на новых данных.
Ключевые выводы
- Глубокое обучение является подмножеством машинного обучения.
- Слои преобразуют тензоры, используя обученные параметры, нелинейные активации, нормализацию и другие операции.
- Обратное распространение вычисляет градиенты; оптимизатор использует эти градиенты для обновления обучаемых параметров, включая веса и смещения.
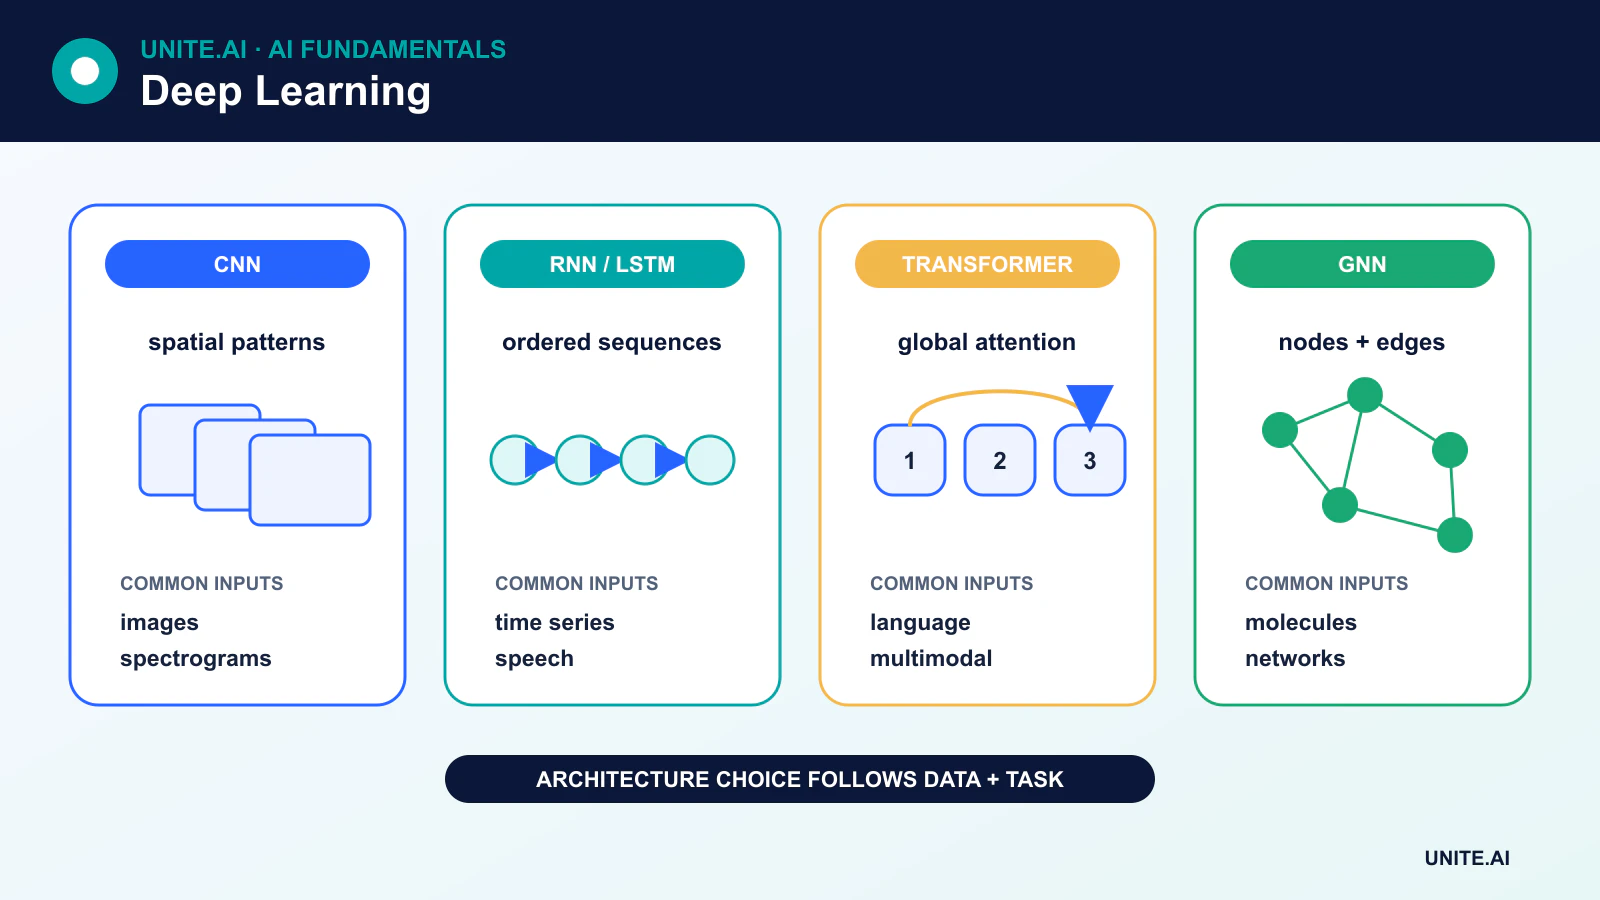
- CNN, рекуррентные сети, трансформеры, автокодеры и диффузионные модели имеют разные структуры и сильные стороны.
Как обучается глубокая нейронная сеть
Нейронная сеть получает данные в виде тензоров — многомерных массивов чисел. Тензор изображения может кодировать каналы пикселей, тогда как языковая модель использует векторы, представляющие токены. Каждый слой выполняет дифференцируемое преобразование и передаёт результат следующему слою.
В простом полносвязном слое модель вычисляет взвешенную сумму своих входов, добавляет обучаемый смещение и затем применяет функцию активации:
output = activation(Wx + b)
Функция активации вводит нелинейность. Без неё стек обычных линейных слоёв всё равно представлял бы лишь линейное преобразование. ReLU и её варианты часто используются в скрытых слоях, тогда как функции активации на выходе зависят от задачи.
Обучение обычно состоит из четырёх шагов:
- Прямой проход генерирует предсказания.
- Функция потерь измеряет, насколько предсказания отличаются от цели.
- Обратное распространение применяет правило цепочки для вычисления градиента функции потерь по каждому обучаемому параметру.
- Оптимизатор, такой как стохастический градиентный спуск или AdamW, обновляет параметры.
Повторяя эти шаги на многих пакетах, можно улучшать модель, но более низкий тренировочный потери не гарантируют надёжное поведение в реальном мире. Валидация, регуляризация, репрезентативные данные и мониторинг остаются необходимыми.
Основные архитектуры глубокого обучения
Многослойные перцептроны
Многослойный перцептрон (MLP) использует полностью связанные слои, в которых каждый выходной нейрон зависит от всех входов предыдущего слоя. MLP полезны для табличных признаков и как компоненты внутри более крупных систем, однако они не учитывают предположения о локальности изображений или порядке последовательностей.
Сверточные нейронные сети
Сверточные нейронные сети (CNN) применяют обученные фильтры к локальным областям. Совместное использование весов делает их эффективными для решёток, таких как изображения и спектрограммы. CNN остаются важными для компьютерного зрения и развертывания на периферийных устройствах, хотя трансформеры для зрения и гибридные модели также широко используются.
Рекуррентные сети, LSTM и GRU
Рекуррентные нейронные сети (RNN) обновляют скрытое состояние по мере обработки последовательности. LSTM и гейтовые рекуррентные блоки помогают сохранять информацию и снижают проблему исчезающего градиента, из‑за которой базовые RNN испытывают трудности с длительными зависимостями. Они не устраняют все ограничения длинного контекста, но остаются полезными для потоковых сигналов, временных рядов и компактных последовательных моделей.
Трансформеры
Трансформеры используют механизм внимания для моделирования взаимосвязей между элементами последовательности или множества. Их способность обрабатывать множество позиций параллельно помогла им заменить рекуррентность в большинстве крупномасштабных языковых систем, а варианты трансформеров теперь обрабатывают изображения, аудио, видео, белки и мультимодальные данные.
Автокодеры и генеративные модели
Автокодер сжимает вход в представление и восстанавливает вход из него. Это создаёт задачу самосупервизионного восстановления; она не автоматически превращает неразмеченные данные в размеченные примеры.
Генеративные состязательные сети обучают генератор и дискриминатор в состязании. Диффузионные модели учатся обратному процессу постепенного добавления шума. Автокорректирующие трансформеры генерируют один токен или единицу за раз. Эти подходы отличаются динамикой обучения, управляемостью и вычислительными требованиями.
Почему глубина помогает — и почему архитектура имеет значение
Несколько слоёв позволяют модели комбинировать простые преобразования в более сложные. В зрении некоторые изученные признаки могут переходить от локальных текстур к специфическим для задачи паттернам. В языке слои внимания формируют контекстно-зависимые представления токенов. Эти описания являются полезными интуитивными представлениями, а не фиксированными правилами того, чему каждый слой должен учиться.
Современные сети также используют остаточные соединения, нормализацию, тщательную инициализацию, регуляризацию и оптимизированное оборудование. Простое добавление слоёв или параметров может сделать модель сложнее для обучения, медленнее или более подверженной переобучению. Масштаб модели помогает только когда данные, цель, оптимизация и условия развертывания это поддерживают.
Обучение и вывод
Обучение настраивает параметры и обычно является вычислительно затратным этапом. Вывод запускает обученную модель для получения результата. Вывод всё ещё может быть дорогим для больших моделей, поэтому команды используют квантизацию, дистилляцию, пакетирование, кэширование, разреженность и специализированное оборудование, такое как нейронные процессорные блоки.
Ограничения и ответственное использование
Глубокие модели могут наследовать предвзятость, запоминать конфиденциальную информацию, давать сбои при смещении распределения и генерировать убедительные, но неверные результаты. Они также могут быть трудны для интерпретации и дорогие в обучении. Оценка должна охватывать больше, чем средний показатель бенчмарка: командам необходима производительность на уровне классов или подгрупп, устойчивость, калибровка, безопасность, задержка, энергопотребление и последствия отказов.
Представления, оптимизация и выбор архитектуры
Глубокие сети обучаются последовательным представлениям через параметризованные слои. Линейные преобразования смешивают входы; нелинейные активации позволяют сети аппроксимировать сложные функции; нормализация и остаточные соединения помогают оптимизации; внимание, свёртка, рекуррентность или операции в пространстве состояний кодируют разные структурные предположения. Глубина увеличивает количество преобразований, но не гарантирует интеллект. Архитектура должна отражать тип данных, объём, задержку, память и инвариантности задачи. Более небольшая сверточная модель может превзойти трансформер, когда данные ограничены и доминирует локальная пространственная структура.
Обучение вычисляет функцию потерь, дифференцирует её с помощью обратного распространения и обновляет параметры оптимизатором, например стохастическим градиентным спуском или Adam. Размер пакета, скорость обучения, расписание, инициализация, регуляризация и численная точность взаимодействуют. Графики тренировочных и валидационных потерь помогают различать недообучение, переобучение, нестабильность и утечку, но они не устанавливают практическую полезность. Используйте независимые данные оценки, повторные запуски, где важна дисперсия, абляции и сравнение с более простыми базовыми моделями. Большое количество параметров также повышает потребность в управлении данными, планировании вычислений и воспроизводимой конфигурации.
Развёртывание глубоких моделей безопасно и эффективно
Развёртывание может использовать хост‑эндпоинт, специализированный ускоритель, браузер, телефон или встроенное устройство. Экспорт и компиляция могут объединять операции, квантизировать веса и активации или менять числовое поведение, поэтому следует проверять развернутый артефакт, а не только контрольную точку обучения. Измеряйте холодный запуск, стабильную задержку, пропускную способность, потребление памяти, энергии и качество при реалистичных размерах пакетов и последовательностей. Методы сжатия — обрезка, дистилляция, квантизация и адаптация низкого ранга — компрометируют размер или скорость в обмен на точность и сложность инженерии и должны оцениваться на чувствительных классах и граничных случаях.
Глубокие модели могут уверенно давать сбои при смещении распределения, враждебных входах, ложных корреляциях и плохо представленными группами. Мониторьте распределения входов и выходов, результаты задач, калибровку, использование ресурсов и версии зависимостей. Применяйте контроль доступа, подписанные артефакты, защищённые обучающие данные, красные команды и ограничения скорости, соответствующие модели угроз. Объяснения, такие как карты значимости или представления внимания, являются диагностическими доказательствами, а не доказательством причинности. Сочетайте их с поведенческими тестами, контрфактуальными сценариями, человеческим ревью, реагированием на инциденты и явными ограничениями автоматических решений.
Практический пример: обучение детектора дефектов изображений
Завод собирает изображения продукции с разных камер, смен, материалов и известных классов дефектов, затем разбивает их по производственным партиям, чтобы почти одинаковые изделия не пересекались между частями. Небольшой сверточный базовый вариант сравнивается с предобученной глубокой сетью. Аугментация воспроизводит проверенное освещение и вариацию ракурсов без стирания дефектов. Оценка включает отзыв по каждому типу дефекта, уровень ложных отклонений, калибровку, задержку вывода и устойчивость к размытию, блику, замене камеры и редким цветам материалов.
Экспортированная модель и точный код изменения размера, цвета и нормализации тестируются на оборудовании линии для устойчивой пропускной способности и теплового поведения. Случаи с низкой уверенностью передаются инспекторам; отдельное правило останавливает линию при критическом отказе датчика. Изображения сохраняются только в разрешённом объёме, а артефакты модели подписываются. Мониторинг связывает предсказания с последующими результатами инспекции и партиями продукции. Новая камера или материал инициируют контролируемую переоценку, а не тихое онлайн‑обучение на непроверенных метках.
Доказательства реализации и готовность к эксплуатации
Производственное решение требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочую среду, входы, выходы, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базовую линию и версионированный набор оценок до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входы, смещение распределения, сбои зависимостей, неправильное использование и группы или среды, наиболее подверженные недостаточному обслуживанию. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Зафиксируйте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развёртывание, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно внедрёнными сбоями. Оперативная телеметрия должна показывать качество входов, поведение выходов, версию модели или правила, состояние зависимостей, вмешательства людей и подтверждённые результаты без сбора ненужных конфиденциальных данных. Определите пороги оповещений и ответственного за реакцию, затем проверяйте реальные доказательства после развертывания, а не полагайтесь на сохранение офлайн‑производительности. Переоценивайте систему при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также требует документированных процедур восстановления, обучения на инцидентах, удаления и хранения, а также чёткой точки, в которой её следует отключить или заменить.
Основные ссылки












