
Основы ИИ
Что такое градиентный спуск?

 Добавьте Unite.AI в избранные источники в Google
Градиентный спуск — это метод оптимизации, который изменяет параметры модели для уменьшения целевой функции. При обучении нейронных сетей эта цель обычно представляет собой потери, вычисляемые по примерам. Градиент указывает направление наибольшего локального увеличения, поэтому градиентный спуск делает шаг в противоположном направлении.
Градиент описывает локальную чувствительность; его величина не является прямой мерой скорости «обучения» модели. Реальный прогресс также зависит от скорости обучения, кривизны, шума, параметризации, состояния оптимизатора и данных.
Ключевые выводы
- Обратное распространение вычисляет градиенты, а градиентный спуск использует их для обновления параметров.
- Оптимизация мини‑пакетами является стандартным практическим подходом в глубоком обучении.
- Скорость обучения контролирует масштаб обновления и может следовать расписанию, а не уменьшаться после каждого шага.
- Моментум, AdamW, обрезка и нормализация решают разные задачи оптимизации.
Базовое правило обновления
Для векторa параметров θ, скорости обучения η и функции потерь L:
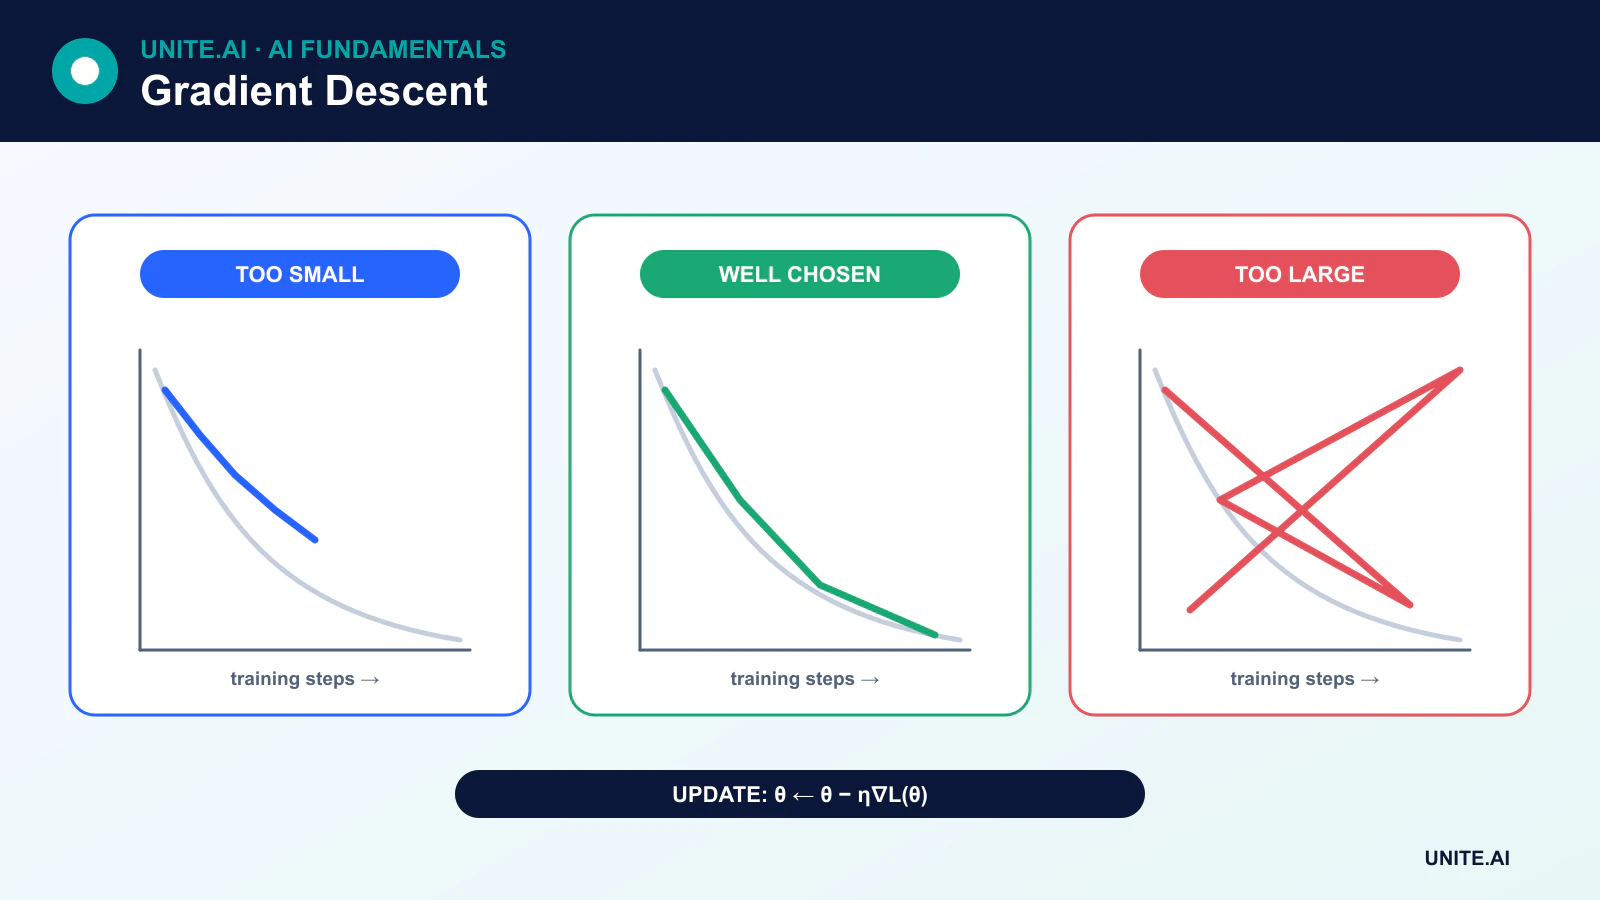
θ ← θ - η∇L(θ)
Градиент ∇L(θ) содержит одну частную производную для каждого параметра. Вычитание его приводит к локальному спуску. Стационарная точка имеет нулевой градиент, но может быть минимумом, максимумом, седловой точкой или плоской областью. Поверхности потерь в глубоком обучении являются невыпуклыми, поэтому обучение не гарантирует нахождение единственного глобального минимума или нулевых потерь.
Методы пакетного, стохастического и мини‑пакетного градиентного спуска
Пакетный градиентный спуск
Пакетный градиентный спуск вычисляет градиент, используя весь набор обучающих данных при каждом обновлении. Оценка стабильна, но может быть затратной по времени и памяти, а одно обновление может недостаточно использовать современные ускорители.
Стохастический градиентный спуск
Строгий стохастический градиентный спуск использует один случайно выбранный пример при каждом обновлении. Его градиенты шумные, что может способствовать исследованию поверхности потерь, но операции с одним примером могут быть неэффективными на параллельном оборудовании.
Мини‑пакетный градиентный спуск
Обучение мини‑пакетами оценивает градиент по подмножеству примеров. Оно балансирует статистический шум с эффективными матричными операциями и является обычным подходом в глубоком обучении. Размер пакета влияет на память, пропускную способность, шум градиента, нормализацию и иногда на обобщающую способность.
Выбор скорости обучения
Слишком большая скорость может перескочить полезные области или вызвать расходимость. Слишком маленькая скорость может сделать обучение непрактически медленным или привести к застреванию в плоских областях. Наилучший масштаб зависит от оптимизатора, размера пакета, модели, инициализации и цели.
Расписания могут постепенно разогреваться, уменьшаться на определённых этапах, следовать косинусной кривой или реагировать на прогресс валидации. Скорость не обязана монотонно уменьшаться после каждого обновления. Тёплые перезапуски и циклические расписания сознательно увеличивают её в отдельных фазах обучения.
Моментум
Моментум поддерживает экспоненциальное скользящее среднее прошлых градиентов. Он может ускорять прогресс вдоль согласованных направлений и снижать осцилляции в крутых, узких направлениях. Моментум в стиле Нестерова вычисляет или приближает градиент, глядя вперёд по направлению моментума.
Адаптивные оптимизаторы
RMSProp масштабирует обновления, используя скользящее среднее квадратов градиентов. Adam сочетает моменты первого порядка, похожие на моментум, со шкалированием второго порядка. AdamW отделяет затухание весов от адаптивного обновления градиента и широко используется для трансформеров.
Адаптивные оптимизаторы часто упрощают раннее обучение, но они не автоматически превосходят другие методы для каждой модели или конечной цели обобщения. Сравнение оптимизаторов требует согласованных расписаний и тщательной настройки.
Обрезка и накопление градиентов
Обрезка градиента ограничивает норму или значения градиента, уменьшая влияние взрывающихся градиентов, особенно в рекуррентных или нестабильных тренировках. Накопление градиентов складывает градиенты из нескольких небольших пакетов перед обновлением, приближая эффект большего пакета при ограниченной памяти.
Мониторинг оптимизации
Отслеживайте потери обучения и валидации, метрики задачи, скорость обучения, нормы градиентов, нормы параметров и численные ошибки. Падение потерь обучения при ухудшении показателей валидации указывает на переобучение, а не на успех оптимизации, который следует автоматически продолжать.
Оптимизация минимизирует заданную цель. Низкие потери не доказывают, что данные, метрика или поведение в реальном мире соответствуют требованиям. Утечки, плохие метки и несоответствующая цель могут привести к хорошо оптимизированной, но вредной модели.
Геометрия оптимизации и правила обновления
Градиентный спуск обновляет параметры в противоположном направлении градиента функции потерь. Полный пакетный спуск использует каждый обучающий пример на шаг; стохастический — один; методы мини‑пакетов оценивают градиент по подмножеству и доминируют в глубоком обучении. Скорость обучения задаёт масштаб шага. Слишком малая тратит вычисления или останавливается; слишком большая приводит к осцилляциям или расходимости. Моментум накапливает движущееся направление, в то время как адаптивные методы, такие как Adam, масштабируют координаты, используя моменты градиента. Их разные скрытые предвзятости могут давать модели с похожими потерями обучения, но разным обобщением.
Поверхности потерь в нейронных сетях содержат плоские и резкие области, седловые точки, симметрии и плохо обусловленные направления. Масштабирование признаков, нормализация, инициализация, остаточные соединения и предобусловливание меняют геометрию, видимую оптимизатором. Расписания могут разогреваться, уменьшаться, циклически повторяться или реагировать на плато. Затухание весов отличается от простого добавления L2‑штрафа в некоторых адаптивных оптимизаторах. Размер пакета влияет на шум, память, параллелизм и режим скорости обучения, поэтому сравнение оптимизаторов требует согласованных бюджетов обучения и тщательной настройки.
Диагностика, воспроизводимость и остановка
Отслеживайте потери обучения и валидации, метрики задачи, нормы градиентов и параметров, скорость обучения, пропускную способность и численные предупреждения. Расходимость может возникнуть из‑за повреждённых пакетов, неверных меток, нестабильной смешанной точности или неправильного усреднения потерь. Плато может указывать на недостаточную ёмкость, насыщенные активации, плохие признаки, избыточную регуляризацию или проблему расписания. Переобучение требует данных, аугментации, регуляризации или ранней остановки — а не утверждения, что оптимизатор провалился. Исследуйте типичные ошибки и сравните с простым базовым уровнем перед увеличением сложности обучения.
Воспроизводимость требует фиксированных семян, порядка данных, кода, конфигурации, версий оборудования и библиотек, хотя некоторые ядра ускорителей остаются недетерминированными. Сохраняйте контрольные точки вместе с состоянием оптимизатора и планировщика, чтобы обучение могло возобновиться последовательно. Выбирайте контрольную точку по заранее установленным критериям валидации и оставляйте нетронутый тестовый набор. В распределённом обучении проверяйте эффективный размер пакета, усреднение градиентов и обработку отказавших рабочих. Оптимизация минимизирует выбранную цель на доступных данных; она не гарантирует калиброванные вероятности, причинно‑следственное рассуждение, справедливость, безопасность или практическую полезность.
Практический пример: настройка оптимизатора для языковой модели
Команда фиксирует токенизатор, порядок данных, модель, эффективный размер пакета и бюджет токенов для обучения, затем сравнивает SGD с моментумом и AdamW по обоснованным расписаниям скорости обучения. Разогрев, уменьшение, затухание весов, обрезка и точность фиксируются. Каждый кандидат запускает несколько семян, а валидация использует отложенный временной отрезок плюс оценку задач. Пропускная способность и энергопотребление сообщаются вместе с потерями, чтобы слегка лучший оптимизатор не выбирался за несоразмерную цену.
Диагностика показывает, происходит ли нестабильность в одном фрагменте данных, из‑за слишком большого шага, недополнения или архитектуры модели. Контрольные точки сохраняют состояние оптимизатора и планировщика и возобновляются в тесте. Окончательный выбор основывается на качестве и надёжности валидации, а не на минимальных потерях обучения. Закрытый тестовый набор запускается один раз после выбора. Производственный вывод отдельно калибруется и мониторится, поскольку успех оптимизатора во время предобучения не гарантирует безопасное или правдивое поведение.
Доказательства внедрения и готовность к эксплуатации
Производственное решение требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочую среду, входные и выходные данные, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базу и версионированный набор оценок перед настройкой. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входные данные, сдвиг распределения, отказ зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развёртывание, сохраняйте безопасный резерв и проверяйте мониторинг с преднамеренно введёнными сбоями. Операционная телеметрия должна показывать качество входных данных, поведение выходов, версию модели или правила, состояние зависимостей, вмешательства человека и подтверждённые результаты без сбора лишних конфиденциальных данных. Определите пороги тревоги и ответственного за реакцию, затем проверяйте реальные доказательства после развертывания, а не полагайтесь на то, что офлайн‑производительность сохранится. Переоценивайте при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также требует документированного восстановления, обучения на инцидентах, процедур удаления и хранения, а также чёткой точки, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Всегда ли градиентный спуск достигает глобального минимума?
Нет. Для выпуклых целей при соблюдении определённых условий существуют сильные гарантии. Цели глубоких сетей являются невыпуклыми, и практические оптимизаторы обычно ищут полезное решение, а не доказывают, что нашли единственный глобальный минимум.
Почему нулевой градиент может вводить в заблуждение?
Нулевой или крошечный градиент может указывать на минимум, максимум, седловую точку, насыщение или плоское плато. Диагностика обучения должна учитывать историю потерь, кривизну, масштаб параметров и показатели валидации.
Основные ссылки












