
Основы ИИ
Что такое NPU? Объяснение нейронных процессорных блоков

 Добавьте Unite.AI в избранные источники в Google
Нейронный процессорный блок (NPU) — это специализированный ускоритель, предназначенный для эффективного выполнения типичных операций нейронных сетей. В смартфонах, ПК, автомобилях, камерах и встроенных системах он может выполнять поддерживаемые задачи ИИ с меньшим энергопотреблением или освобождать ЦПУ и ГПУ для других задач.
NPU — это широкое отраслевое понятие, а не единая архитектура. Производительность зависит от поддерживаемых операторов, числовых форматов, памяти, компилятора и среды выполнения, тепловых ограничений и того, какая часть приложения может оставаться на ускорителе.
Ключевые выводы
- NPUs ориентированы на матричные, векторные и тензорные операции с высоким повторным использованием данных и низким энергопотреблением.
- Пиковый показатель TOPS не является сквозным бенчмарком приложения и может предполагать определённую точность или разреженность.
- Модель может потребовать конвертации, квантизации, разбиения графа и резервного выполнения для неподдерживаемых операций.
- Сравнивайте задержку, пропускную способность, энергопотребление, память, качество, конфиденциальность и переносимость на реальной нагрузке.
Роли CPU, GPU и NPU
CPU превосходят в общем управлении потоками и широкой совместимости. GPU обеспечивают программируемую параллельную пропускную способность и имеют обширные программные экосистемы. NPU специализируются на повторяющихся тензорных операциях и могут включать локальную память, массивы умножения‑накопления и поток данных, оптимизированный для вывода.
Гетерогенные системы распределяют различные части туда, где они работают лучше всего. Это важно для edge AI, где устойчивое энергопотребление и отзывчивость могут быть важнее пиковой пропускной способности дата‑центра.
Компиляция модели и её выполнение
Граф фреймворка преобразуется в промежуточное представление, оптимизируется, при необходимости квантизируется и компилируется для поддерживаемых операторов. Среда выполнения может разбивать граф, чтобы неподдерживаемые слои исполнялись на CPU или GPU.
Передачи между процессорами могут нивелировать выгоду от ускорителя. Статические формы, расположение, точность, пакетирование и повторное использование памяти влияют на производительность. Тестируйте скомпилированный артефакт, поскольку качество модели deep‑learning может измениться после конвертации.
Понимание TOPS и заявлений об эффективности
TOPS указывает триллионы операций в секунду при определённых предположениях. Производители могут считать умножение и сложение отдельно, использовать низкоразрядную целочисленную точность или предполагать разреженность. Более высокое число не гарантирует меньшую задержку для конкретной модели.
Измеряйте холодный и тёплый запуск, задержку на запрос, пропускную способность, энергопотребление, пиковую память, тепловое ограничение, поддерживаемый контекст или размер изображения и долю графа, ускоряемую. Используйте сопоставимую точность и версии программного обеспечения.
Компромиссы ИИ на устройстве
Локальное выполнение может снизить зависимость от сети и сохранять необработанные данные на устройстве, но загруженные модели, журналы, резервные копии и резервные облачные сервисы всё равно создают потоки данных. Необходимо обеспечить безопасную доставку моделей и обновления платформы.
NPU могут поддерживать задачи в области зрения, аудио, языка и датчиков, включая нагрузки, смежные с TinyML. Разработчики должны проектировать плавный резервный режим и информировать, когда обработка переходит за пределы устройства.
Архитектура NPU и поддерживаемые операции
NPU ускоряют тензорные операции, используя массивы блоков умножения‑накопления, локальную память, планирование потоков данных и специализированные числовые форматы. Размещение весов и активаций рядом с вычислительными блоками уменьшает дорогостоящие перемещения данных. Реальные устройства различаются поддержкой операторов, иерархией памяти, точностью, разреженностью, программируемостью и тем, как работа распределяется между CPU и GPU.
Пиковая производительность часто рекламируется в TOPS, однако TOPS не указывает точность, загрузку, ограничения памяти, покрытие операторов или сквозную задержку. Два процессора с одинаковым заголовочным числом могут показывать разный результат на одной и той же модели. Проводите бенчмарк скомпилированной модели, реалистичных размеров пакетов и последовательностей, предобработки, передач и режима питания.
NPU эффективны для поддерживаемых нейронных задач, таких как зрение, речь, подавление шума, эффекты фона и компактные языковые модели. Неподдерживаемые операторы могут переключаться на CPU или GPU, создавая передачи и непредсказуемую задержку. Анализируйте отчёты компилятора и трассы выполнения, чтобы подтвердить размещение, а не предполагать, что весь граф использует ускоритель.
Конверсия модели, квантизация и развертывание
Развёртывание обычно проходит от фреймворка обучения через экспорт, оптимизацию графа, квантизацию, компиляцию поставщиком и интеграцию в среду выполнения. Статические формы и распространённые операторы легче всего ускорять. Динамический контроль потока, пользовательские ядра, большие промежуточные тензоры и неподдерживаемые схемы нормализации или внимания могут потребовать изменения графа или гибридного выполнения.
Целочисленные и низкоточные форматы уменьшают размер модели, пропускную способность, энергопотребление и задержку, но калибровочные данные должны отражать реальные входы. Сравнивайте квантизацию после обучения с обучением с учётом квантизации, когда качество чувствительно. Оценивайте поведение по классам и в худших случаях, поскольку средняя точность может скрывать деградацию в редких или критически важных сценариях.
Вывод на устройстве улучшает задержку, автономную работу и конфиденциальность за счёт ограничения передачи данных, однако устройству всё равно нужны защищённые модели, доступ к данным с учётом разрешений и механизмы обновления. Защищайте файлы моделей при необходимости, подписывайте обновления, раскрывайте резервные облачные варианты и гарантируйте, что телеметрия не восстанавливает утечку конфиденциальности, которую должна была уменьшить локальная архитектура.
Оценка производительности и системные компромиссы
Измеряйте задержку при холодном запуске и в устойчивом состоянии, пропускную способность, энергопотребление на вывод, память, тепловое поведение, точность и влияние на батарею. Длительные тесты выявляют ограничение, которое упускают короткие бенчмарки. Включайте предобработку и постобработку, поскольку изменение размера, токенизация, декодирование или копирование данных могут доминировать над иначе быстрым ускорителем.
Планирование — это системная задача. CPU управляет логикой приложения, GPU может рендерить или выполнять неподдерживаемые слои, а NPU исполняет совместимые графы. Одновременно работающие камеры, аудио, дисплей и задачи ИИ конкурируют за пропускную способность памяти и энергию. Тестируйте полную пользовательскую ситуацию, а не изолированную модель в инструменте поставщика.
Переносимость остаётся ограниченной между компиляторами и средами выполнения. Предпочитайте стандартные представления моделей там, где они работают, изолируйте код, специфичный для поставщика, за интерфейсами, сохраняйте эталонные выводы и поддерживайте покрытие тестами устройств. Выбирайте оборудование, основываясь на проверенных нагрузках, поддержке программного обеспечения, горизонте обновлений и общей стоимости системы, а не на одной спецификации ускорителя.
Практический пример: развертывание модели зрения на ноутбуке с NPU
Команда обучает модель сегментации для фоновых эффектов, экспортирует её в поддерживаемый формат обмена, заменяет неподдерживаемые операторы и калибрует целочисленную квантизацию с представительным набором камер, освещения, оттенков кожи, одежды и фонов. Компилятор поставщика сообщает, какие узлы работают на NPU, а какие переключаются на резерв. Команда рассматривает любые переключения как системные затраты, поскольку передачи тензоров могут превзойти быстрый отдельный ядро.
Бенчмаркинг измеряет предобработку камеры, выполнение модели, композитинг, память, холодный запуск, устойчивую задержку, стабильность кадров, потребление энергии и тепловое ограничение во время реального видеозвонка. Результаты сравниваются с путями CPU и GPU при одинаковом качестве вывода. Приложение использует обнаружение возможностей и проверенный резервный режим, а не предполагает наличие ускорителя или поддержку того же графа после обновления драйвера.
Тестирование релиза охватывает модели устройств, версии операционной системы и драйверов, одновременные нагрузки, режимы батареи и некорректные входные данные. Пакеты моделей подписываются и версионируются; телеметрия фиксирует производительность и сбои без сбора лишнего видео. Продукт объясняет, когда обработка остаётся на устройстве, а когда используются облачные функции. NPU заслуживает место, улучшая весь опыт при реалистичных ограничениях, а не достигая изолированного TOPS или ядрового бенчмарка.
Практический чек‑лист реализации
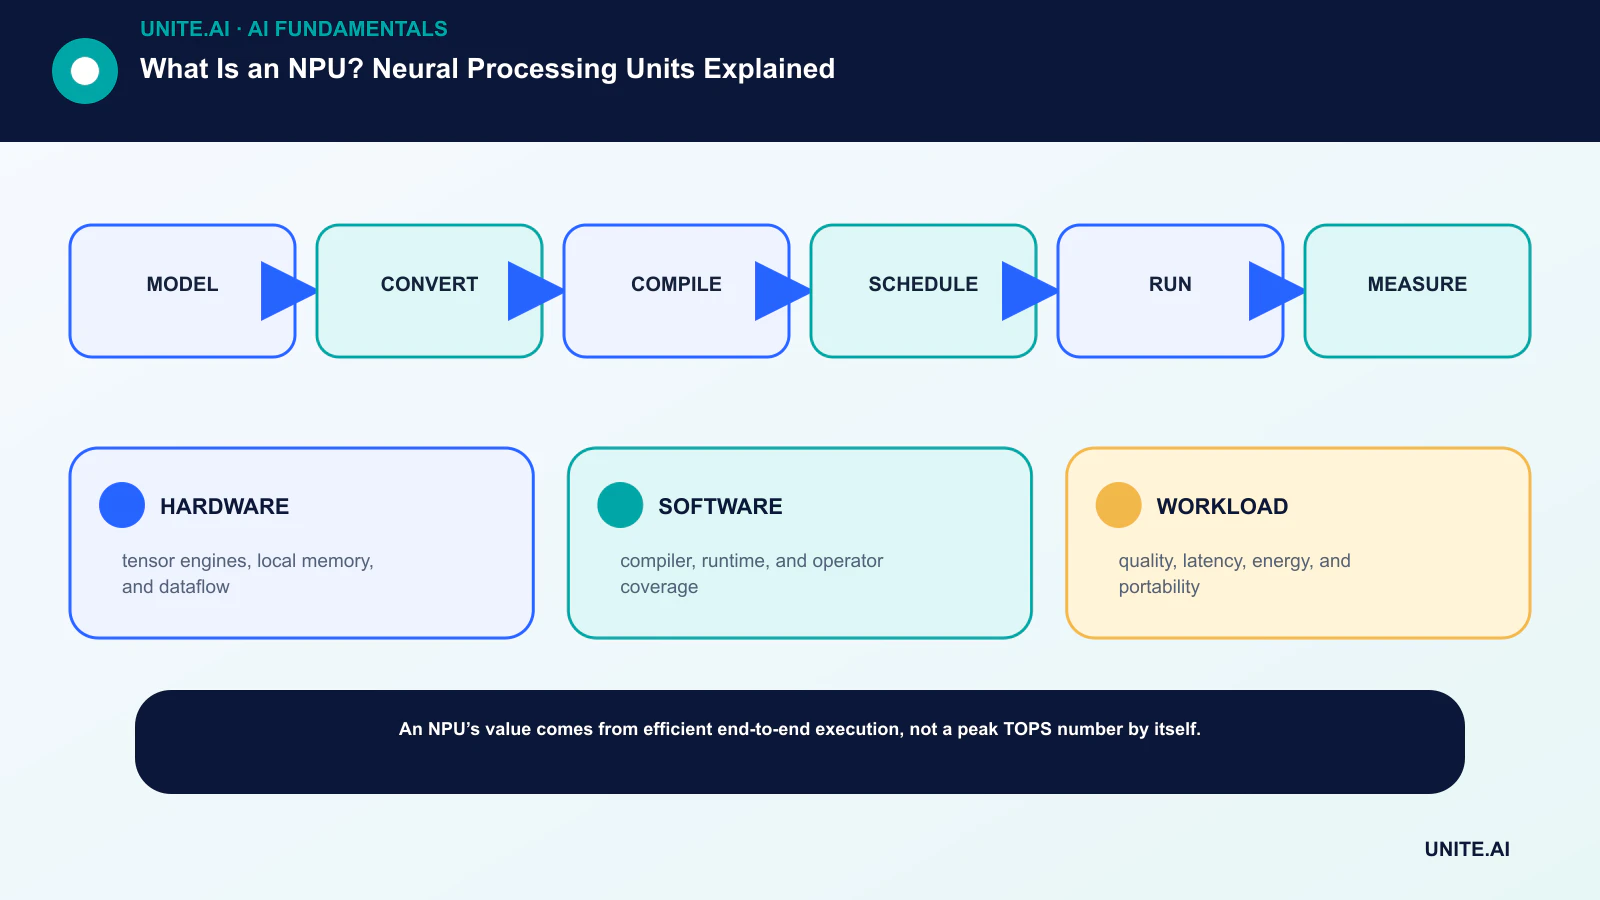
Превратите концепцию в ограниченный, проверяемый рабочий процесс: модель → конверсия → компиляция → планирование → запуск → измерение. Назначьте ответственного, задокументируйте данные и зависимости, установите простую базовую линию, определите критерии приёма и остановки, протестируйте типичные сбои и задайте мониторинг, откат и обзор перед расширением объёма. Записывайте версии и предположения, чтобы другая команда могла воспроизвести результат и понять, что изменилось.
Перед запуском проведите документированный обзор готовности с людьми, которые разрабатывают, эксплуатируют, защищают и затронуты системой. Тестируйте обычные случаи, граничные условия, сбои зависимостей и неправильное использование; сохраняйте доказательства и нерешённые риски. Определите, кто может одобрять релиз, менять порог, переопределять вывод или останавливать работу. Пересмотрите решение после получения реальных данных, поскольку технически успешный пилот не гарантирует надёжную работу в более широком масштабе.
- ОБОРУДОВАНИЕ: тензорные движки, локальная память и поток данных.
- ПРОГРАММНОЕ ОБЕСПЕЧЕНИЕ: компилятор, среда выполнения и покрытие операторов.
- НАГРУЗКА: качество, задержка, энергопотребление и переносимость.
Часто задаваемые вопросы
Является ли NPU быстрее, чем GPU?
Это зависит от модели, точности, поддержки операторов, размера пакета, ограничения мощности и программного обеспечения. NPU может быть более эффективным для поддерживаемой нагрузки на устройстве, тогда как GPU может быть быстрее или гибче в других случаях.
Сохраняет ли NPU всю конфиденциальность данных ИИ?
Нет. Он позволяет выполнять обработку локально, но приложение всё равно может отправлять данные или результаты в облачные сервисы. Конфиденциальность зависит от полной архитектуры и политики.
Основные ссылки












