Основы ИИ
Что такое нейронные сети?

 Добавьте Unite.AI в избранные источники в Google
Искусственная нейронная сеть — это параметризованная математическая модель, состоящая из слоёв связанных операций. Во время обучения сеть корректирует свои параметры, чтобы входные данные преобразовывались в полезные выходы. Нейронные сети могут аппроксимировать сложные нелинейные зависимости и обучаться представлениям непосредственно из текста, изображений, аудио, временных рядов и других данных.
Название исторически вдохновлено биологическими нейронами, однако современные сети являются инженерными системами, а не реалистичными симуляциями мозга. Такие термины, как «нейрон» и «обучение», являются удобным сокращением и не должны восприниматься как доказательство наличия человеческого сознания.
Ключевые выводы
- Нейрон вычисляет взвешенную сумму, добавляет обучаемый смещение и применяет функцию активации.
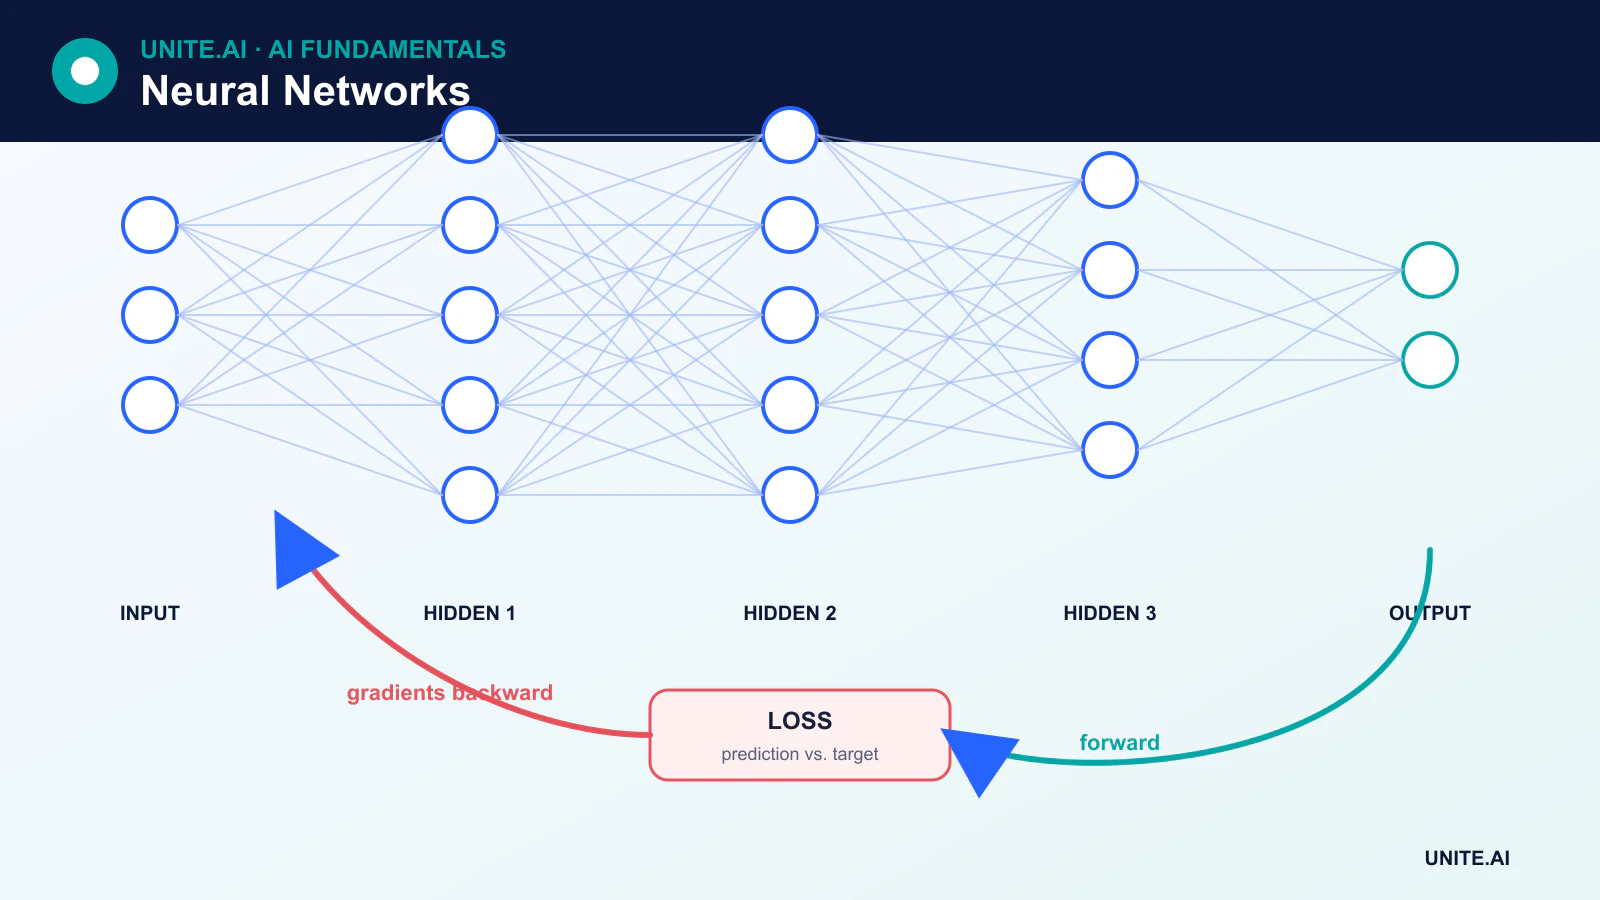
- Прямой проход генерирует предсказания; функция потерь измеряет ошибку; обратное распространение вычисляет градиенты; оптимизатор обновляет параметры.
- MLP, CNN, RNN и трансформеры по‑разному организуют соединения.
- Большее количество слоёв или параметров не гарантирует лучшую или более надёжную модель.
От отдельного искусственного нейрона к сети
Для входного вектора x базовый элемент вычисляет:
z = Wx + boutput = activation(z)
W содержит обучаемые веса, а b — обучаемое смещение. Функция активации вводит нелинейность. Веса сами по себе не «проходят» через активацию; активация применяется к взвешенной сумме и смещению.
Многослойный перцептрон (MLP) состоит из плотных слоёв. Входной слой представляет признаки, скрытые слои преобразуют их, а выходной слой предназначен для конкретной задачи — например, логиты классов или значение регрессии.
Как нейронные сети обучаются
- Модель инициализирует обучаемые параметры.
- Прямой проход обрабатывает пакет данных и генерирует предсказания.
- Функция потерь сравнивает предсказания с целевой функцией обучения.
- Backpropagation использует правило цепочки для вычисления градиентов.
- Оптимизатор, такой как стохастический градиентный спуск или AdamW, обновляет веса и смещения.
Backpropagation стал центральным в обучении нейронных сетей благодаря работе, разработанной и популяризированной в течение нескольких десятилетий; он не был впервые создан в эпоху современного глубокого обучения. Современные фреймворки реализуют обратное автоматическое дифференцирование, поэтому практикующие специалисты не обязаны вручную выводить каждый градиент.
Почему функции активации важны
Без нелинейных функций активации несколько обычных линейных слоёв сводятся к одной линейной трансформации. ReLU широко используется благодаря своей простоте и эффективности. GELU и SiLU часто встречаются в современных архитектурах. Sigmoid и softmax остаются полезными для определённых интерпретаций выходов, однако sigmoid может насыщаться в скрытых слоях и способствовать исчезновению градиентов.
Основные архитектуры нейронных сетей
Сверточные нейронные сети
CNN применяют обученные фильтры к локальным окрестностям и разделяют параметры между позициями. Эти свойства делают их эффективными для изображений и других сигналов, представимых в виде сетки.
Рекуррентные сети
RNN, LSTM и GRU обновляют скрытое состояние по последовательности. Они остаются полезными для потоковых и временных задач, хотя рекурсия ограничивает параллельную обработку и может сталкиваться с проблемами долгосрочных зависимостей.
Трансформеры
Трансформеры используют механизм внимания для создания контекстно-зависимых представлений. Оставшиеся соединения, нормализация, позиционная информация и блоки прямого распространения являются ключевыми элементами архитектуры. Трансформеры сейчас лежат в основе многих крупных языковых и мультимодальных моделей.
Автоэнкодеры и генеративные сети
Автоэнкодеры обучаются представлениям через реконструкцию. GAN, диффузионные модели и автокорреляционные сети генерируют новые образцы, используя различные цели и процедуры обучения.
Компоненты, делающие глубокие сети обучаемыми
Современные системы используют не только слои и функции активации. Оставшиеся соединения позволяют информации и градиентам обходить блоки. Нормализация стабилизирует активации. Регуляризация, аугментация данных, dropout и затухание весов могут уменьшать переобучение. Слои вложений отображают дискретные элементы, такие как токены, в векторы. Механизм внимания позволяет представлению динамически зависеть от других элементов.
Сильные и слабые стороны
Нейронные сети могут извлекать признаки из высокоразмерных сырых данных и масштабироваться вместе с ростом объёма данных и вычислительных ресурсов. Однако они могут требовать больших наборов данных, специализированного оборудования и тщательной настройки. Их предсказания могут быть плохо откалиброваны, хрупки при смещении распределения, уязвимы к атакующим манипуляциям и трудно объяснимы.
Архитектура должна соответствовать задаче и ограничениям развертывания. Для многих табличных задач ансамбль деревьев или линейная модель могут быть быстрее и проще валидации. Для критически важных приложений производительность модели необходимо оценивать по подгруппам и сценариям отказов, а не только по агрегированному бенчмарку.
Слои, активации и поток информации
Нейронная сеть состоит из параметризованных функций. Каждый элемент формирует взвешенную комбинацию входов, добавляет смещение и пропускает результат через функцию активации, такую как ReLU, sigmoid, tanh или GELU. Сложение слоёв позволяет получать иерархические признаки и нелинейные границы решений. Ширина контролирует количество единиц в слое; глубина — последовательные преобразования; связность и совместное использование весов задают архитектуру. Выход сети зависит от предобработки, параметров, нормализации и режима инференса. Нейрон — это математическая операция, а не буквальный биологический нейрон или самостоятельное понятие.
Прямое распространение вычисляет предсказания; функция потерь измеряет ошибку; обратное распространение применяет правило цепочки к градиентам; оптимизатор обновляет параметры. Инициализация, скорость обучения, статистика батчей, оставшиеся пути и нормализация влияют на то, исчезают ли градиенты, взрываются ли они или остаются полезными. Регуляризация включает затухание весов, dropout, аугментацию, раннюю остановку и архитектурные ограничения. Стройте графики поведения обучения и валидации, анализируйте статистику градиентов и активаций, сравнивайте повторные запуски. Большая сеть может запоминать обучающие данные, тогда как небольшая может недообучаться или упускать необходимую структуру.
Выбор архитектуры, оценка и развертывание
Многослойные перцептроны обрабатывают фиксированные векторы; сверточные сети используют локальную структуру; рекуррентные и модели состояний обрабатывают последовательности; трансформеры применяют внимание; графовые сети обмениваются информацией по ребрам. Гибридные решения распространены. Выбор основывается на индуктивных предположениях, данных, размере последовательности или изображения, задержке, памяти, интерпретируемости и доступном оборудовании. Оценивайте по сравнению с линейной или деревяной базой и проводите абляции, чтобы понять, какая сложность имеет значение. Одного лишь количества параметров недостаточно для предсказания качества, стоимости инференса или требований к данным.
Развертывание требует зафиксированной предобработки, экспортированного или скомпилированного графа, числовой валидации и тестов нагрузки в реальных условиях. Квантование и обрезка могут уменьшить размер, но могут изменить поведение редких классов. Мониторьте входы, выходы, калибровку, задержку и подтверждённые результаты; тестируйте на атакующие и смещённые данные. Защищайте модели, зависимости и данные с помощью подписанных артефактов, контроля доступа и проверки цепочки поставок. Объяснения, основанные на отдельных активациях или важности, требуют причинно-следственной и поведенческой верификации. Нейронные сети — гибкие аппроксиматоры функций, но не гарантии понимания, истины или надёжности.
Практический пример: нейронный прогноз спроса
Ритейлер прогнозирует недельный спрос на товар на основе продаж, акций, цены, праздников, наличия и погоды. Сеть сравнивается с сезонным наивным, линейным и деревяным базовыми моделями с использованием скользящих временных разбиений. Будущие акции учитываются только когда они действительно известны на момент прогноза, а дефицит моделируется, поскольку наблюдаемые продажи могут недооценивать спрос. Оценка проводится с помощью взвешенной абсолютной ошибки, смещения, охвата интервалов и результатов по скорости оборота товаров и магазинам.
Конвейер развертывания учитывает доступность функции, модель и горизонт и отклоняет прогноз, если необходимые входные данные устарели. Планировщики видят интервалы и могут переопределить их, указав причины. Мониторинг обнаруживает отсутствие потоков, изменение ошибки, смещения и необычные прогнозы; бизнес‑результаты отделяются от точности прогноза, поскольку политика заказов также влияет на запасы. Обновление модели проходит в теневом режиме несколько циклов, а предыдущий прогнозировщик остаётся доступным для отката в случае сезонных или поставочных сбоев.
Доказательства реализации и готовность к эксплуатации
Решение о внедрении требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочую среду, входы, выходы, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базу и версионированный набор для оценки до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входные данные, смещение распределения, отказ зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Измеряйте качество задачи совместно с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный релиз, сохраняйте безопасный резерв и проверяйте мониторинг с преднамеренно внедрёнными сбоями. Оперативная телеметрия должна показывать качество входных данных, поведение выходов, версию модели или правила, состояние зависимостей, вмешательства людей и подтверждённые результаты без сбора лишних конфиденциальных данных. Определите пороги тревоги и ответственного за реакцию, затем проверяйте реальные доказательства после развертывания, а не полагайтесь на офлайн‑производительность. Переоценивайте при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также требует документированных процедур восстановления, обучения на инцидентах, удаления и хранения, а также чёткой точки, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Все ли нейронные сети относятся к глубокому обучению?
Нет. Небольшая сеть с одним скрытым слоем является нейронной сетью, тогда как глубокое обучение обычно подразумевает архитектуры с несколькими обучаемыми этапами обработки. Граница условна, а не строгий научный порог.
Хранят ли нейронные сети свои обучающие данные?
Они сохраняют обученные параметры, а не обычную поисковую копию набора данных. Тем не менее, крупные модели могут запоминать и воспроизводить отдельные обучающие примеры, что создает риски для конфиденциальности и авторских прав, которые необходимо проверять.
Основные ссылки