
Основы ИИ
Что такое уменьшение размерности?

 Добавьте Unite.AI в избранные источники в Google
Уменьшение размерности представляет данные с меньшим числом переменных, сохраняя информацию, полезную для задачи. Оно может уменьшать объём хранения и шум, улучшать визуализацию, снижать избыточность признаков и упрощать обучение последующих моделей.
Ни один метод не сохраняет все взаимосвязи. Полезное уменьшение начинается с определения того, что должно сохраняться: дисперсия, разделение классов, локальные окрестности, глобальная геометрия, качество восстановления или интерпретируемость.
Основные выводы
- Отбор признаков сохраняет исходные переменные; извлечение признаков создаёт новые координаты в более низком измерении.
- PCA является линейным и ориентированным на дисперсию; t-SNE и UMAP подчёркивают структуру окрестностей для визуализации.
- Визуализационные вложения могут искажать расстояния, размеры кластеров и глобальное разделение.
- Обучайте уменьшение только на тренировочных данных, а затем применяйте полученное преобразование к данным валидации и теста.
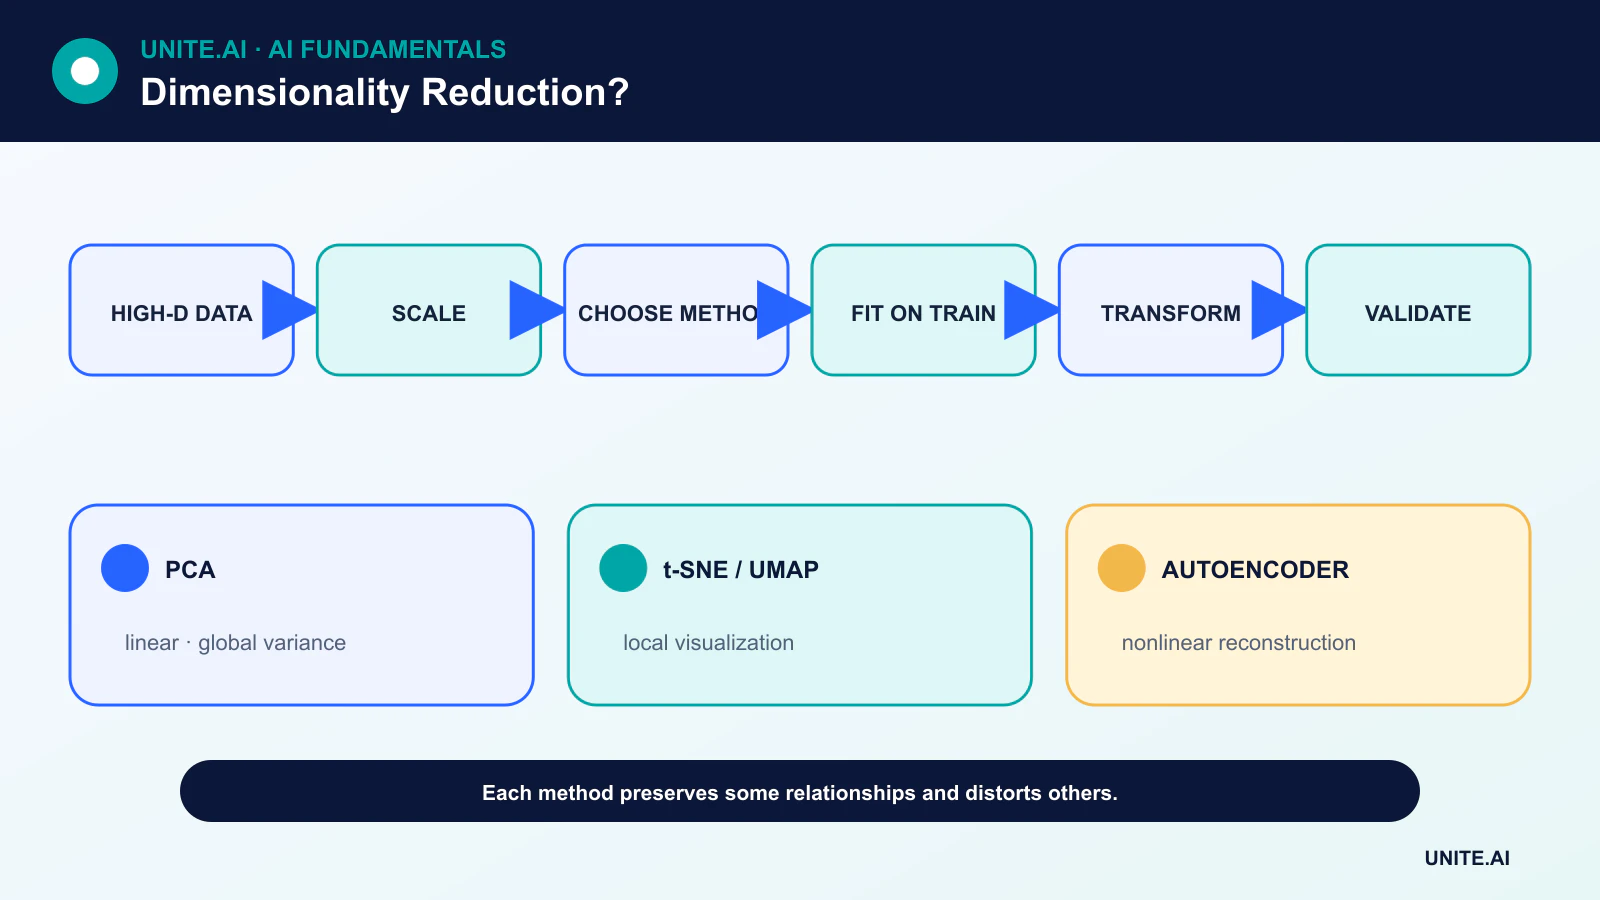
Отбор признаков против проекции
Отбор признаков удаляет переменные с помощью правил предметной области, отсутствия данных, избыточности, предиктивных тестов или регуляризации. Он сохраняет исходные значения, что может способствовать управляемости и объяснимости.
Методы проекции объединяют переменные в новые координаты. Они способны захватывать распределённую структуру, но могут усложнять интерпретацию каждой координаты. Автоэнкодер обучает нелинейную проекцию через восстановление.
PCA и SVD
Метод главных компонент (PCA) определяет ортогональные направления с убывающей дисперсией после центрирования данных. Сингулярное разложение (SVD) предоставляет общий численный путь. Масштабирование имеет значение: измерение с высокой дисперсией может доминировать над компонентами.
PCA детерминирована за исключением знака и повторяющихся собственных значений, поддерживает преобразование новых образцов и предоставляет сводки объяснённой дисперсии. Высокая дисперсия не всегда релевантна задаче, и линейные компоненты не могут разворачивать каждую изогнутую многообразие.
t-SNE и UMAP
t-SNE строит вероятностные распределения по соседям и оптимизирует низкоразмерную карту, подчёркивающую локальное сходство. UMAP формирует взвешенный граф окрестностей и оптимизирует низкоразмерное представление с учётом целей локальной структуры.
Оба метода являются мощными исследовательскими инструментами, но чувствительны к предобработке, метрике расстояния и гиперпараметрам. Пустое пространство, площадь кластера и расстояние между кластерами на 2‑мерном графике не должны автоматически трактоваться как реальные свойства.
Контролируемые методы и представления, учитывающие задачу
Линейный дискриминантный анализ (LDA) использует метки классов для поиска разделения, что отличает его от неконтролируемого PCA. Обучение нейронных представлений может оптимизировать предсказание или контрастивные цели вместо восстановления.
Если метки управляют уменьшением, всё обучение и настройка должны оставаться внутри процесса обучения. Иначе информация из тестового набора может просочиться в выбор модели и создать оптимистичный результат.
Выбор и проверка метода
Начните с предобработки и простого базового уровня. Для сжатия измеряйте восстановление или производительность downstream‑модели по разным размерностям. Для визуализации проверяйте стабильность при разных seed‑ах и гиперпараметрах и сравнивайте сохранение окрестностей с предметными знаниями.
Для продакшна задайте вопросы: может ли метод преобразовывать новые записи, как он обрабатывает пропущенные значения, меняется ли он при переобучении и нужны ли пользователям объяснения исходных признаков. Переобучение может возникнуть на этапе уменьшения так же, как и в конечной модели.
Линейные и нелинейные методы уменьшения
Уменьшение размерности отображает данные высокой размерности в меньшее число координат, сохраняя выбранную структуру. Метод главных компонент ищет ортогональные направления максимальной дисперсии после центрирования; требуется масштабирование, когда единицы измерения должны вносить сопоставимый вклад. Сингулярное разложение вычисляет связанную низкоранговую структуру и поддерживает разреженные матрицы. Линейный дискриминантный анализ использует метки для поиска направлений, разделяющих классы. Эти методы дают явные преобразования, но дисперсия или разделение классов могут не сохранять информацию, необходимую для последующей задачи.
Методы многообразий, такие как t‑SNE и UMAP, строят окрестности и оптимизируют низкоразмерную раскладку. Они мощны для исследования, но искажают глобальные расстояния, плотность, размер кластеров и иногда разделение. Результаты зависят от предобработки, метрики, количества соседей или perplexity, инициализации и seed‑а. Привлекательный кластер в двух измерениях может появиться даже без дискретных групп. Используйте несколько настроек, раскрашивайте только по метаданным, не использованным при обучении, и проверяйте видимую структуру в исходном пространстве или с независимыми метками.
Отбор признаков, вложения и оценка
Отбор признаков сохраняет исходные переменные с помощью фильтров, обёрток или важности, основанной на модели; обучение представлениям создаёт новые скрытые признаки с помощью автоэнкодеров или контролируемых моделей. Случайные проекции приближённо сохраняют расстояния при определённых условиях и предоставляют эффективные базовые линии. Выбирайте метод исходя из сжатия, визуализации, снижения шума, скорости, объёма хранения или производительности модели. Обучайте уменьшитель только на тренировочных данных, а затем применяйте к наборам валидации и теста. Контролируемое уменьшение должно быть вложено в кросс‑валидацию, чтобы избежать утечки меток.
Оценивайте объяснённую дисперсию или восстановление для линейного сжатия, надёжность и сохранение окрестностей для визуализации, а также точность, калибровку, задержку и устойчивость downstream‑модели для предсказания. Измеряйте стабильность по образцам и seed‑ам. Проверяйте, не объединяются ли редкие классы или уязвимые группы, и возможна ли обратная трансформация. Сокращённые координаты могут всё ещё содержать конфиденциальную информацию; двумерный график не обеспечивает анонимизацию. Документируйте преобразование, масштабировщик, порядок признаков и ограничения.
Использование в продакшене
Обслуживание требует точного обученного преобразования и схемы входных данных. Следите за отсутствующими признаками, сдвигом диапазонов, распределением оценок компонентов, ошибкой восстановления и downstream‑результатами. Если появляются новые категории или датчики, переобучайте и версионируйте весь конвейер, а не добавляйте столбцы незаметно. Уменьшение может ускорить вычисления и убрать шум из модели, но также может отбрасывать слабые сигналы, важные для редких событий. Рассматривайте его как обученный измерительный шаг, информация которого должна проверяться в контексте принятия решений.
Практический пример: уменьшение признаков поведения клиентов
Аналитик стандартизирует 200 измерений поведения и применяет PCA только к клиентам обучающего набора. Кросс‑валидация выбирает количество компонентов по производительности по оттоку и стабильности, а не по двумерному графику. Загрузки (loadings) проверяются на доминирующие источники и пропуски. PCA, отбор признаков, случайная проекция и нередуцированная регуляризованная модель сравниваются по калибровке, задержке и результатам для редких сегментов клиентов. Повторные выборки также проверяют, остаются ли ведущие компоненты и downstream‑выводы стабильными.
Развернутый конвейер фиксирует порядок признаков, масштабировщик и компоненты и отклоняет версии схем с пропусками. Мониторинг отслеживает распределения компонентов, ошибку восстановления и downstream‑результаты. Визуализация с видимыми кластерами используется для генерации вопросов, а не для назначения персон клиентам. Поскольку скрытые компоненты всё ещё кодируют поведение, доступ и удержание остаются контролируемыми. Если исходные определения меняются, полностью пере‑строивают и валидируют преобразование и модель, а не проецируют несовместимые данные в старые компоненты.
Доказательства внедрения и готовность к эксплуатации
Решение о внедрении в продакшн требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочую среду, входные и выходные данные, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базу и версионированный набор для оценки до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входные данные, сдвиг распределения, отказ зависимостей, неправильное использование и группы или среды, наиболее подверженные недообслуживанию. Измеряйте качество задачи совместно с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развёртывание, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно введёнными сбоями. Оперативные телеметрические данные должны раскрывать качество входов, поведение выходов, версию модели или правила, состояние зависимостей, вмешательства человека и подтверждённые результаты без сбора лишних конфиденциальных данных. Определите пороги тревог и ответственного за реакцию, затем оценивайте реальные доказательства после внедрения, а не полагайтесь на сохранение офлайн‑производительности. Переоценивайте при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также требует документированного восстановления, обучения на инцидентах, процедур удаления и хранения, а также чёткой точки, когда её следует отключить или заменить.
Часто задаваемые вопросы
Всегда ли уменьшение размерности улучшает модель?
Нет. Оно может отбрасывать предиктивную информацию или усложнять интерпретацию. Сравните с базовой моделью без уменьшения на отложенных данных.
Доказаны ли реальными классы отдельные кластеры t‑SNE?
Нет. Карта — это оптимизированная визуализация отношений соседства и может создавать кажущееся разделение. Проверяйте кластеры независимыми доказательствами.
Основные ссылки












