
Основы ИИ
Что такое обучение с небольшим числом примеров?

 Добавьте Unite.AI в избранные источники в Google
Обучение с небольшим числом примеров изучает, как модель может адаптироваться к новой задаче или классу, имея лишь небольшое количество размеченных примеров. В классических бенчмарках эпизод предоставляет набор поддержки — например, пять классов с одним или пятью примерами на класс — и просит модель классифицировать невидимые запросы.
Термин также используется для обучения в контексте, когда предобученная языковая модель получает несколько демонстраций в подсказке без обновления параметров. Эти настройки имеют общую цель — обучение на небольшом числе примеров, но используют разные механизмы адаптации и требуют различных схем оценки.
Ключевые выводы
- N‑way K‑shot описывает N классов и K размеченных примеров поддержки на каждый класс.
- Методы метрического обучения сравнивают запросы с обученными представлениями примеров поддержки.
- Метапоиск оптимизирует множество задач, чтобы новая задача могла быть выучена быстро.
- Небольшое число примеров усиливает влияние ошибок разметки, утечек, неоднозначности классов и неопределённости, поэтому базовые модели и отчётность о уверенности имеют значение.
Эпизоды, наборы поддержки и наборы запросов
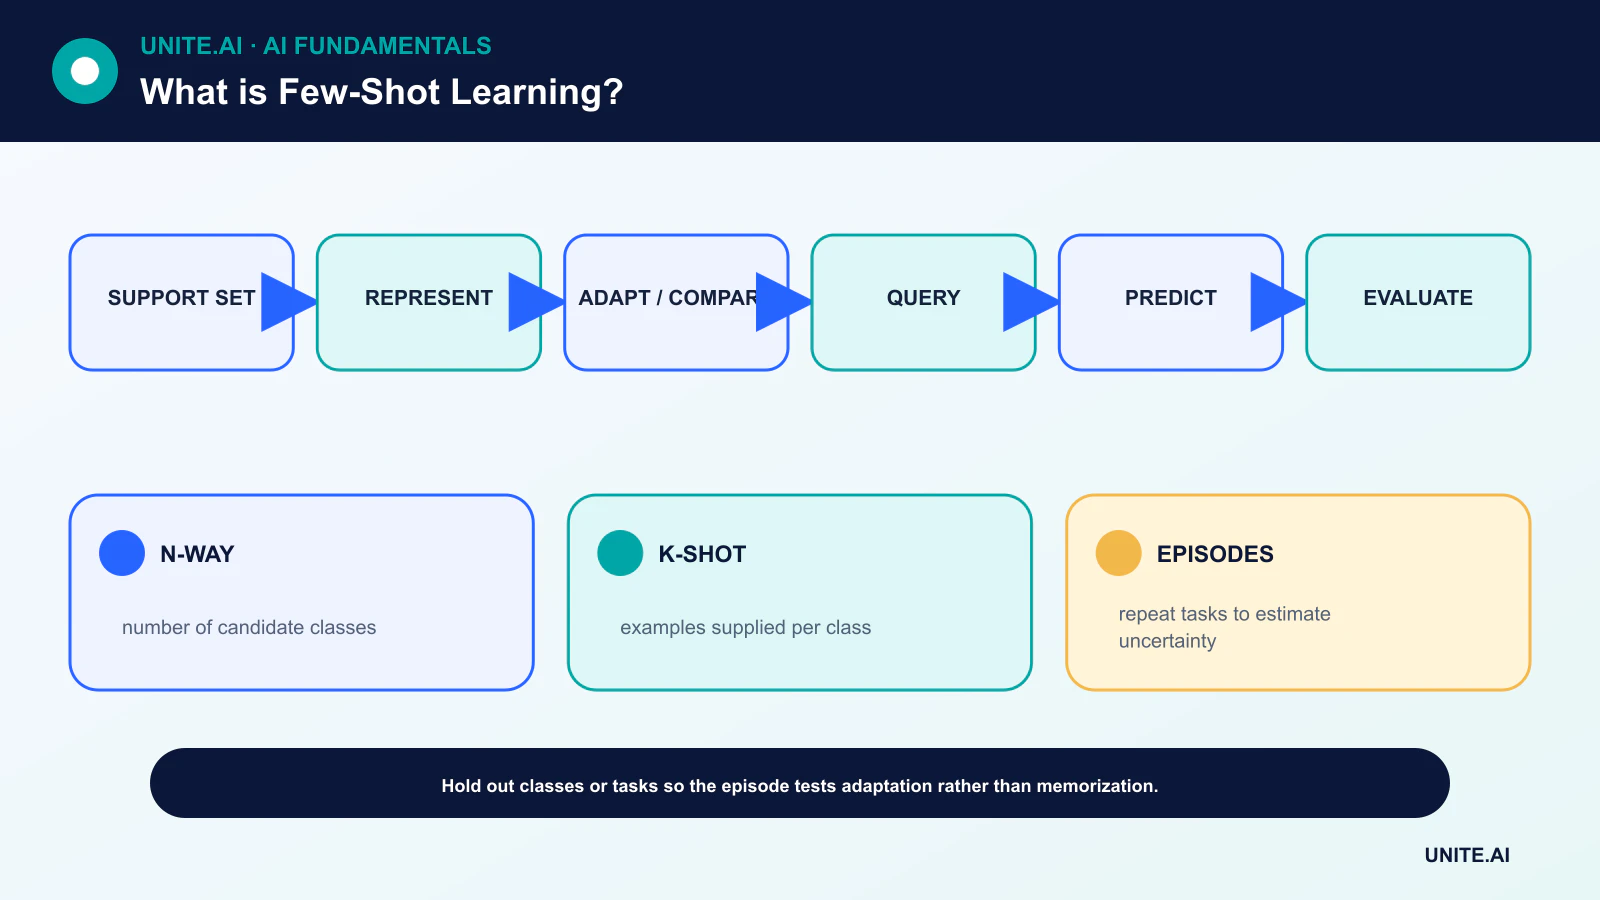
Эпизод обучения с небольшим числом примеров отделяет небольшой размеченный набор поддержки от набора запросов, используемого для оценки. Во время мета‑обучения модель видит множество таких эпизодов. Надёжная оценка исключает целые классы, задачи или домены, чтобы тестовый эпизод измерял адаптацию, а не запоминание.
Отчитывайтесь о распределениях точности по множеству эпизодов, а не об одной удобной выборке. Сравнивайте с простыми базовыми методами — ближайший сосед и линейный классификатор; сложный метод, который не превосходит хорошо обученное представление плюс базовый классификатор, может не оправдывать свою сложность.
Метрика обучения и прототипы
Сети сопоставления и похожие методы встраивают примеры поддержки и запросов в пространство, где близкие векторы должны иметь одинаковую метку. Прототипные сети усредняют встраивания поддержки для каждого класса и классифицируют запрос по расстоянию до этих прототипов класса.
Это связывает обучение с небольшим числом примеров с качеством представлений. Предобученная глубокое обучение модель может уже хорошо организовывать релевантные признаки, тогда как несоответствующее представление делает каждое расстояние вводящим в заблуждение.
Оптимизационное мета‑обучение
Model-Agnostic Meta-Learning ищет параметры, которые могут адаптироваться за небольшое число шагов градиентного спуска. Другие методы обучают оптимизатор, инициализацию или правило обновления параметров. Внешний цикл оценивает производительность после адаптации по множеству задач.
Метапоиск предполагает, что полезная структура общая для обучающих и целевых задач. Когда целевое распределение резко отличается, быстрая адаптация может провалиться. Валидацию следует проводить, варьируя число примеров, классов, доменов и сложность задач, а не считая один бенчмарк универсальным.
Переносное обучение и стратегии на уровне данных
Переносное обучение часто является самым сильным практическим стартом — заморозьте предобученный энкодер, обучите небольшой голова, затем при наличии достаточного количества данных выполните выборочную донастройку. Аугментация данных может ввести инвариантности, но нереалистичные синтетические примеры могут усилить предвзятость или создать «короткие пути».
Активное обучение может приоритизировать, какие примеры размечать, тогда как полуподконтрольное обучение использует дополнительные неразмеченные данные. Это взаимодополняющие стратегии, а не синонимы обучения с небольшим числом примеров.
Промптинг с небольшим числом примеров отличается
Трансформер может вывести закономерность из демонстраций, помещённых в его контекст. Постоянное обновление параметров не требуется. Порядок, формулировка и баланс меток могут существенно менять вывод, а примеры могут занимать большую часть окна контекста.
Используйте репрезентативный набор для оценки, версионируйте каждый промпт и демонстрацию, и тестируйте нулевой, небольшом числом примеров и донастроенный варианты. Небольшой набор поддержки не поддерживает сильные общепопуляционные утверждения, особенно для редких или критически важных случаев.
Парадигмы обучения с небольшим числом примеров и построение задач
Обучение с небольшим числом примеров стремится выполнить задачу, имея очень мало размеченных примеров. В методах, основанных на метриках, энкодер отображает примеры в пространство, где ближайшие прототипы или соседи представляют классы. Оптимизационное мета‑обучение обучает инициализацию или правило обновления для быстрой адаптации. Переносное обучение донастраивает предобученную модель на небольшом целевом наборе. Обучение в контексте подаёт примеры в подсказке без обновления весов. Эти механизмы различаются, поэтому утверждения должны уточнять, меняются ли параметры, какое предобучение использовалось и как отбираются примеры.
Оценка должна разделять обучающие и тестовые классы, задачи, субъекты или домены в соответствии с заявленной обобщаемостью. Эпизод N‑way K‑shot содержит N классов и K примеров поддержки на каждый класс, плюс запросы для оценки. Повторные эпизоды позволяют оценить дисперсию от выбора поддержки. Для промптинга порядок примеров, формулировка меток, формат и схожесть демонстраций могут существенно влиять на результаты. Сравнивайте с нулевым, ближайшим соседом, линейным пробой и обычными донастроенными базовыми моделями, используя одинаковое представление и бюджет данных.
Качество данных, неопределённость и негативный перенос
При небольшом числе примеров ошибочно размеченные или атипичные случаи имеют непропорционально большое влияние. Определите правила аннотации, проверяйте каждый элемент поддержки и сохраняйте возможность «неизвестно» или отказа. Аугментация данных и синтетические примеры помогают только тогда, когда они сохраняют задачу и добавляют реалистичную вариативность. Предобученная модель может перенести «короткие пути» или предвзятость из исходного домена. Тестируйте случаи вне домена, редкие группы и чувствительность к удалению одного примера поддержки. Сообщайте доверительные интервалы по задачам и случайным инициализациям, а не одну благоприятную подсказку.
Активное обучение может запрашивать метки для информативных случаев, тогда как полуподконтрольные методы используют неразмеченные данные при дополнительных предположениях. Поиск может динамически подбирать релевантные демонстрации, но должен избегать утечки меток теста. Адаптация может быстро переобучаться, поэтому ограничивайте обновления, используйте регуляризацию и проверяйте на отдельном наборе. Для задач с высоким риском несколько меток вряд ли оправдывают автономные решения; используйте модель для приоритизации или помощи в проверке, пока не будет достаточного количества подтверждённых результатов.
Эксплуатация в продакшене
Версионируйте базовую модель, эмбеддинги или шаблон подсказки, демонстрации, схему меток и параметры адаптации. Защищайте примеры, поскольку подсказки или градиенты могут раскрывать конфиденциальные записи. Отслеживайте производительность по мере изменения классов и языка, и обновляйте примеры поддержки через управляемый обзор, а не автоматическое самораскрытие. Обучение с небольшим числом примеров уменьшает требование к размеченным целевым данным, используя предшествующую структуру; однако оно не устраняет необходимость в репрезентативной оценке, тщательном определении задачи, экспертизе домена и безопасном резерве, когда новая задача выходит за пределы имеющихся знаний.
Практический пример: классификация с небольшим числом примеров для нового продукта
Команда поддержки нуждается в метках маршрутизации для продукта, имеющего лишь пять проверенных примеров на каждый тип обращения. Она сравнивает ближайшие прототипы в предобученном эмбеддинге, линейную голову, параметрически‑эффективную донастройку и промптинг в контексте. Семейства продуктов, клиенты и последующие сообщения исключаются из мета‑обучения и выбора модели. Повторная выборка наборов поддержки сообщает о полноте по классам, калибровке, дисперсии и чувствительности к одной ошибочно размеченной демонстрации.
Сообщения с низкой уверенностью и без поддержки перенаправляются в общую поддержку, а проверяющие корректируют метки через управляемую очередь. Примеры анонимизируются, версионируются и никогда не берутся из финального тестового набора. Мониторинг отслеживает новую лексику, частоту классов, исправления и разногласия. Когда накапливается достаточное количество меток, система с небольшим числом примеров сравнивается с обычным контролируемым обучением. Быстрая настройка полезна, но не оправдывает автоматизацию, если производительность остаётся нестабильной или новый продукт существенно отличается от предыдущих семейств задач.
Доказательства внедрения и готовность к эксплуатации
Решение о внедрении требует больше, чем успешная демонстрация. Определите целевых пользователей, рабочую среду, входы, выходы, зависимости, владельца и последствия каждого критического сбоя. Установите воспроизводимую базовую линию и версионированный набор оценки до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входы, сдвиг распределения, отказ зависимостей, неправильное использование и группы или среды, наиболее подверженные недостаточному обслуживанию. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, затратами ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый проверяющий мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развёртывание, сохраняйте безопасный резерв и проверяйте мониторинг с преднамеренно внесёнными сбоями. Оперативная телеметрия должна показывать качество входов, поведение выходов, версию модели или правила, состояние зависимостей, человеческие вмешательства и подтверждённые результаты без сбора избыточных конфиденциальных данных. Определите пороги оповещений и ответственного за реакцию, затем после развертывания проверяйте реальные данные, а не полагайтесь на офлайн‑результаты. Переоценивайте при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также требует документированных процедур восстановления, обучения на инцидентах, удаления и хранения, а также чёткой точки, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Является ли обучение one‑shot тем же, что обучение с небольшим числом примеров?
Обучение one‑shot — это частный случай, когда на каждый класс или задачу имеется один размеченный пример поддержки. Обучение zero‑shot использует вообще без размеченных целевых примеров.
Устраняет ли обучение с небольшим числом примеров необходимость в данных?
Нет. Оно смещает зависимость в сторону предобученных данных, связанных задач, представлений и предположений. Целевых меток мало; общая история обучения обычно велика.
Основные ссылки












