
Основы ИИ
Что такое мета-обучение?

 Добавьте Unite.AI в избранные источники в Google
Meta-learning обучает систему на распределении задач, чтобы она могла адаптироваться к новой, связанной задаче, используя ограниченные данные или вычисления. Часто это резюмируют как “learning to learn”, но техническая цель более точна: оптимизировать обучающегося так, чтобы опыт из предыдущих задач улучшал адаптацию к последующей.
Мета-обучение пересекается с few-shot learning и transfer learning, но термины не являются взаимозаменяемыми. Few-shot описывает количество целевых данных; transfer описывает повторное использование; мета-обучение явно делает адаптацию между задачами частью обучения.
Ключевые выводы
- Мета-обучение использует множество задач, а не только множество независимых примеров.
- Эпизод N-way K-shot содержит N классов и K помеченных поддерживающих примеров на каждый класс.
- Методы, основанные на градиенте, метрике, памяти и обучаемых оптимизаторах, адаптируются разными способами.
- Эффективность сильно зависит от того, насколько задачи мета-обучения похожи на целевую задачу.
Задачи, наборы поддержки и наборы запросов
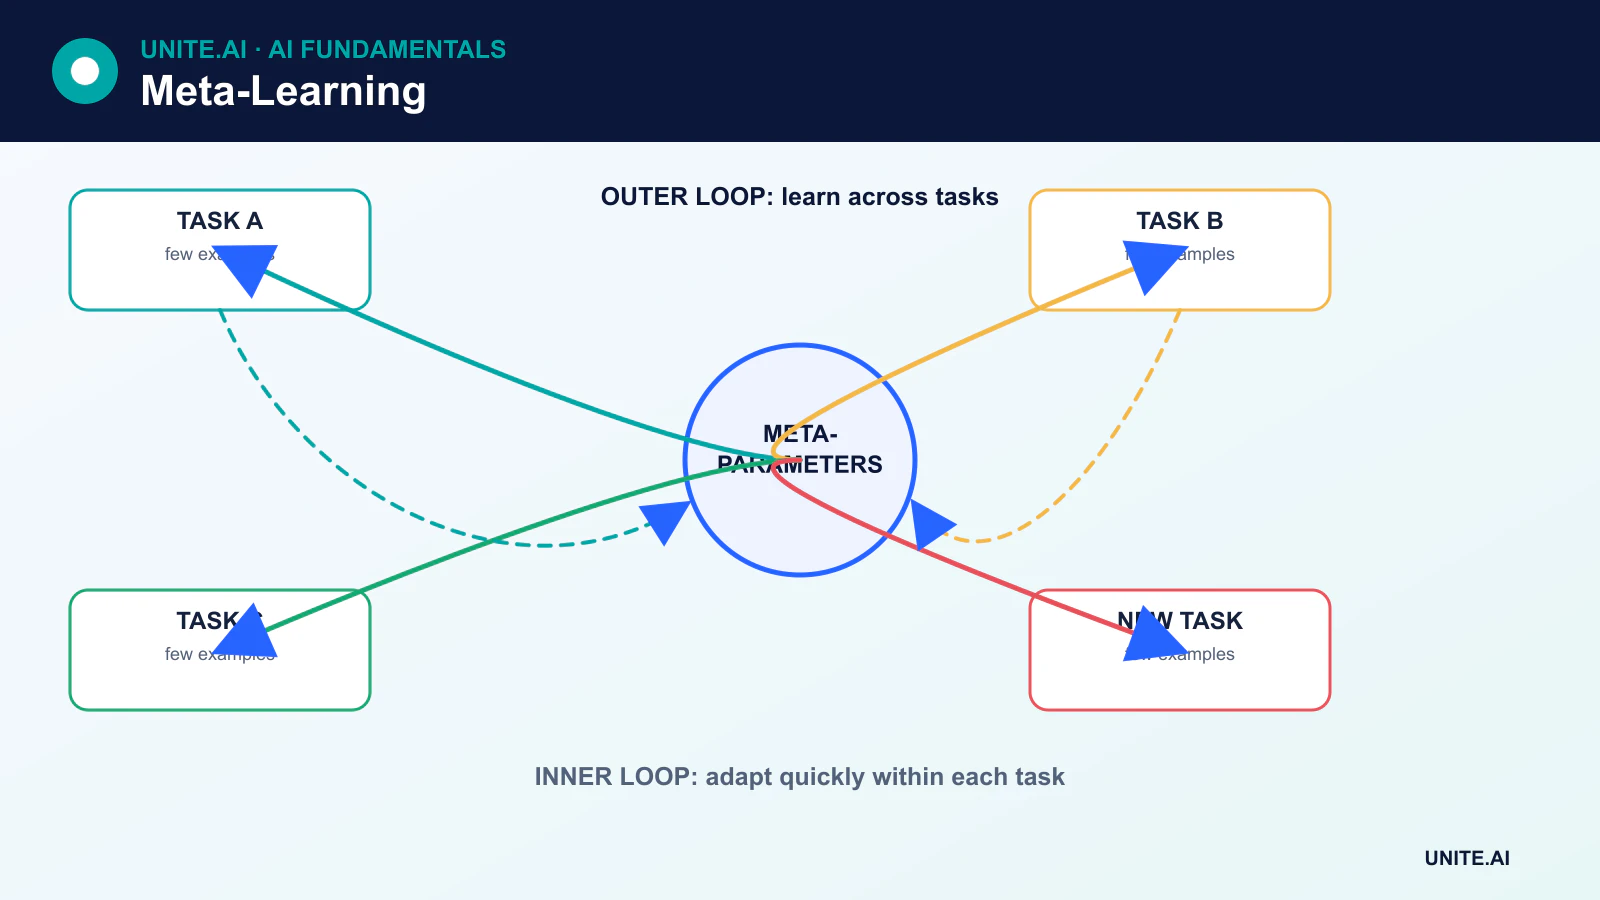
Набор данных для мета-обучения организован в виде задач. В few-shot классификации эпизод может быть 5-way 1-shot: пять классов, один помеченный поддерживающий пример на каждый класс и дополнительные запросные примеры, используемые для оценки адаптации. Задача 5-way 5-shot имеет пять поддерживающих примеров для каждого из пяти классов — а не пять примеров в сумме.
Во время мета-обучения обучающийся многократно адаптируется на наборе поддержки и оценивается на наборе запросов. Внешняя цель улучшает будущую производительность запросов по задачам. Метавалидация настраивает выборы на отдельных задачах, а метатестирование оценивает действительно невидимые задачи или классы.
Градиентное мета-обучение
Model-Agnostic Meta-Learning (MAML) изучает инициализацию, из которой небольшое количество шагов gradient приводит к хорошей производительности на новой задаче. Внутренний цикл адаптирует параметры модели, используя данные поддержки. Внешний цикл обновляет общую инициализацию, используя потери запросов по выбранным задачам.
MAML не ограничивается классификацией; его можно применять к регрессии и reinforcement learning, когда модель и задача дифференцируемы. Reptile предлагает более простой подход первого порядка, который перемещает параметры к решениям, адаптированным под задачу, без вычисления полного мета‑градиента MAML.
Метрика-ориентированное мета-обучение
Методы, основанные на метрике, обучают вложение, в котором примеры одного класса находятся близко, а разные классы отделены. Прототипическая сеть усредняет вложения поддержки, формируя один прототип на класс, а затем классифицирует запросы по расстоянию до этих прототипов.
Matching и Siamese‑подобные сети используют связанные механизмы сходства. Эти методы не просто проверяют, «попадает ли модель в целевую метрику»; изученное расстояние или представление сами являются частью процедуры предсказания.
Методы, основанные на памяти, и обучаемые оптимизаторы
Системы, основанные на памяти, используют рекуррентное или attention‑основанное состояние для хранения информации о текущей задаче. Обучаемые оптимизаторы принимают градиенты или сигналы обучения как вход и учатся обновлять другую модель. Такие методы могут обнаруживать правила адаптации, но они добавляют параметры, вычислительные затраты и ещё один уровень потенциального переобучения.
Мета-обучение и обучение в контексте
Большие transformers могут адаптировать свой вывод, используя примеры, представленные в подсказке, без обновления весов. Это называется обучением в контексте. Оно напоминает поведение мета-обучения, и данные обучения могут способствовать выводу задачи, но обучающийся в контексте не автоматически обучается классической эпизодической мета‑обучающей целью.
Где полезно мета-обучение
Возможные применения включают персонализацию, робототехнику, распознавание при ограниченных ресурсах, научные задачи с небольшим количеством измерений и быструю адаптацию к новым условиям. Мета-обучение наиболее привлекательно, когда доступно множество связанных исходных задач, но данные целевой задачи скудны.
Ограничения
Мета-обучение может быть вычислительно дорогим, поскольку обучение вкладывает адаптацию внутрь оптимизации. Результаты чувствительны к построению задач, утечке support/query, архитектуре и смещению домена. Модель, обученная на узком, однородном наборе задач, может плохо адаптироваться за пределами этого распределения.
Сравнения должны включать обычные baselines transfer‑learning и multitask. Сильное предварительно обученное представление с последующей стандартной донастройкой может быть проще и эффективнее, чем специализированный алгоритм мета‑обучения.
Задачи, адаптация и структура вложенной–внешней оптимизации
Мета-обучение обучается на распределении задач, чтобы обучающийся мог адаптироваться к новой задаче с ограниченными данными или обновлениями. Каждый эпизод выбирает задачу, делит примеры на набор поддержки для адаптации и набор запросов для оценки, и обновляет общее знание между эпизодами. Методы, основанные на метрике, обучают вложение и правило сравнения; методы, основанные на оптимизации, обучают инициализацию или поведение обновления; методы, основанные на памяти и модели, условно зависят от примеров задачи. Распределение задач является реальными обучающими данными и должно отражать будущие проблемы адаптации.
В модели-агностическом мета‑обучении внутренний цикл адаптирует параметры на примерах поддержки, а внешний цикл оптимизирует производительность на примерах запросов после адаптации. Высокопорядковые градиенты могут быть дорогими; приближения первого порядка меняют точность на пользу вычислительной экономии. Прототипические сети представляют каждый класс центроидом набора поддержки и классифицируют по расстоянию. Эти методы предполагают, что геометрия классов, шаги адаптации и построение эпизодов соответствуют условиям эксплуатации. Метод может казаться быстро обучающимся, используя фиксированные метки, артефакты сбора или перекрытие между исходными наборами данных.
Оценка, базовые модели и ограничения в реальном мире
Отдельные задачи для обучения, валидации и тестирования — а не просто примеры — нужны для измерения адаптации к действительно невидимым задачам. Сообщайте точность или потерю как функцию количества shot‑ов и шагов адаптации, доверительные интервалы по задачам, вычислительные ресурсы, память и чувствительность к составу набора поддержки. Сравнивайте с transfer learning, донастройкой предварительно обученной модели, ближайшими соседями и моделью, обученной совместно на всех исходных данных. Многие кажущиеся выгоды мета‑обучения уменьшаются, когда базовые модели получают одинаковые ядра, аугментацию и настройку.
Реальные развертывания требуют способа распознавать, когда новая задача выходит за пределы распределения мета‑обучения. Плохие или ошибочно помеченные примеры поддержки могут вызвать быстрый уверенный сбой. Ограничьте величину обновления, валидируйте адаптированные модели, сохраняйте резервный вариант и защищайте данные адаптации от отравления. Отслеживайте базовую модель, генератор задач, семена эпизодов и код адаптации. Мета‑обучение полезно для повторяющихся семейств задач с небольшим объёмом данных, но оно не создаёт общую способность обучения из произвольных примеров и не устраняет необходимость в доменно‑специфичной оценке.
Практический пример: few-shot адаптация между машинами
Производитель рассматривает каждый тип машины как отдельную задачу и мета‑обучает представление аномалий на множестве машин с проверенными результатами обслуживания. Тестовые машины полностью исключены из обучения задач. Для новой машины небольшой набор поддержки покрывает нормальные режимы работы, а не произвольные минуты данных. Мета‑обучение сравнивается с предварительно обученным замороженным энкодером, ближайшими соседями и обычной донастройкой, используя те же примеры поддержки и вычислительные ресурсы.
Оценка повторяет множество выборок поддержки и сообщает о полноте событий, ложных тревогах, времени адаптации и дисперсии. Система отказывается от работы, когда набор датчиков новой машины или её динамика выходят за пределы распределения задач. Обновления адаптации ограничены и проверяются перед тем, как влиять на обслуживание. Метки поддержки и идентификация машины защищены от отравления, и каждая адаптированная модель сохраняет свою базовую версию и примеры. Быстрая адаптация принимается только если она последовательно превосходит более простые методы transfer в условиях реального смещения задач.
Доказательства реализации и готовность к эксплуатации
Производственное решение требует больше, чем успешную демонстрацию. Определите целевых пользователей, рабочую среду, входы, выходы, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимый базовый уровень и версионированный набор оценок до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входы, смещение распределения, отказ зависимостей, неправильное использование и группы или среды, которые, скорее всего, будут недостаточно обслужены. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и различить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный выпуск, сохраняйте безопасный резерв и проверяйте мониторинг с преднамеренно введёнными сбоями. Оперативная телеметрия должна показывать качество входов, поведение выходов, версию модели или правила, состояние зависимостей, человеческие вмешательства и подтверждённые результаты без сбора избыточных конфиденциальных данных. Определите пороги оповещений и ответственного за реакцию, затем после развертывания проверяйте реальные доказательства, а не полагайтесь на офлайн‑производительность. Переоценивайте при изменении источников данных, пользователей, моделей, поставщиков, политик, аппаратного обеспечения или целей. Поддерживаемая система также нуждается в документированных процедурах восстановления, обучения на инцидентах, удалении и хранении, а также в чётком моменте, когда её следует отключить или заменить.
Часто задаваемые вопросы
Является ли few-shot prompting мета-обучением?
Few-shot prompting — это техника адаптации в контексте. Она может демонстрировать поведение, характерное для обучения по задачам, но не автоматически обучается с эпизодами support/query или явным мета‑оптимизационным циклом.
Каков наибольший риск мета-обучения?
Несоответствие между задачами мета‑обучения и целевой задачей может заставить быструю адаптацию выглядеть сильной в бенчмарке, но провалиться в реальном развертывании. Разделения задач и происхождение исходных данных должны проверяться так же тщательно, как обычные train/test‑разделения.
Основные ссылки











