Основы ИИ
Что такое перенос обучения?

 Добавьте Unite.AI в избранные источники в Google
Перенос обучения повторно использует знания, полученные при решении одной задачи, для улучшения обучения на смежной задаче. Вместо того чтобы случайным образом инициализировать каждый параметр, специалист начинает с предобученной модели или представления и адаптирует его под целевую задачу.
Этот подход особенно полезен, когда целевой набор данных небольшой, маркировка дорогая, или предобучение требует больше вычислительных ресурсов, чем команда может себе позволить. Обучение модели с нуля является альтернативой переносу обучения — это не тип переноса обучения.
Ключевые выводы
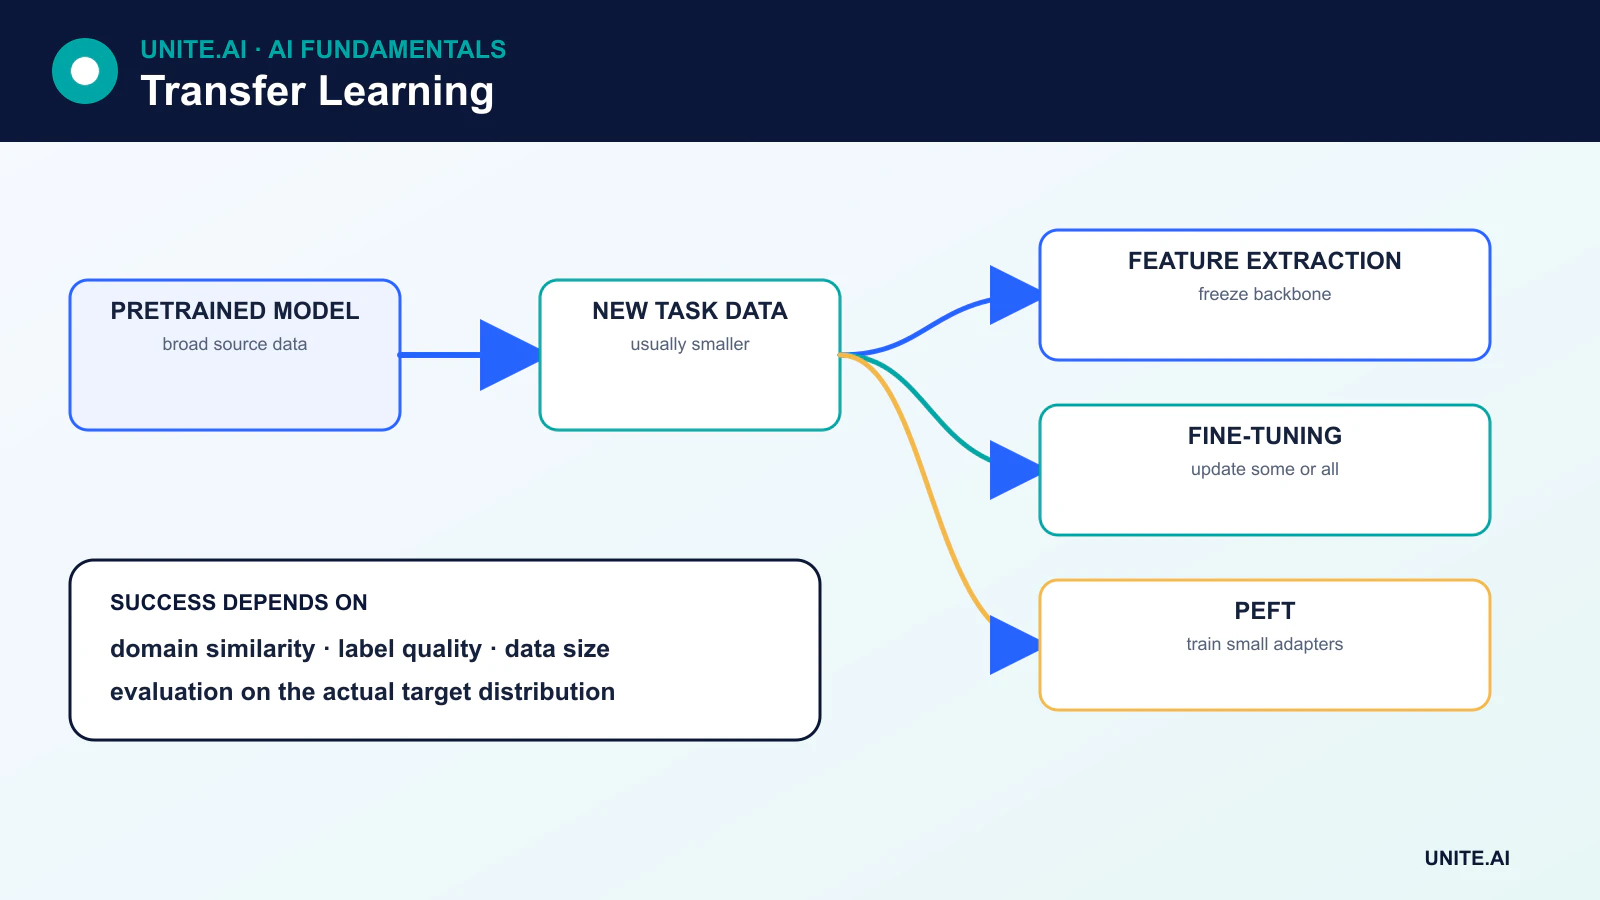
- Извлечение признаков оставляет предобученную основу замороженной и обучает новую задачно‑специфическую головку.
- Тонкая настройка обновляет некоторые или все предобученные параметры с использованием данных целевого домена.
- Эффективные по параметрам методы, такие как адаптеры и LoRA, обновляют лишь небольшую часть модели.
- Перенос может провалиться, если источники и целевые домены различаются, лицензии конфликтуют или исходная модель несёт неподходящие предвзятости.
Почему перенос обучения работает
Модели часто изучают представления, полезные за пределами точных данных, на которых они обучались. Ранние слои модели изображений могут фиксировать переиспользуемые локальные паттерны; языковая модель может выучить синтаксис, семантику и широкие ассоциации через самосупервизионное предсказание. Целевая задача может опираться на эти представления, а не переучивать всё с нуля на ограниченных примерах.
Эффективность зависит от сходства между исходной и целевой задачами, масштаба и качества предобучения, а также способа адаптации модели. Повторное использование не гарантировано: перенесённые признаки могут быть нерелевантными или даже вредными.
Извлечение признаков
При извлечении признаков предобученная основа замораживается, её параметры не меняются. Выход модели становится входом нового классификатора, регрессора или другой задачи‑специфической головки. Обучается только новая головка.
Это быстро и экономит данные, а также снижает риск разрушения полезных предобученных представлений. Однако может привести к недообучению, если целевой домен существенно отличается от предобучения. Слои, такие как пакетная нормализация, требуют особого внимания, поскольку их сохранённые статистики и поведение при обучении могут влиять на адаптацию даже при замороженных весах.
Тонкая настройка
Тонкая настройка обновляет предобученные параметры на целевых данных. Распространённый рабочий процесс выглядит так:
- Загрузить предобученную модель и заменить или добавить выходную головку.
- Заморозить основу и обучить новую головку.
- Разморозить выбранные слои — или всю модель — и продолжить обучение с меньшей скоростью обучения.
- Проверить переобучение, забывание и производительность на целевом домене.
Нет универсального правила, согласно которому следует настраивать только конечные слои. Лучший выбор зависит от архитектуры, объёма целевых данных, сходства доменов, нормализующих слоёв, памяти и вычислительных ресурсов. Полная тонкая настройка может предоставить большую ёмкость, но требует больше ресурсов и может вызвать катастрофическое забывание.
Эффективная по параметрам тонкая настройка
Большие трансформеры делают полную тонкую настройку дорогой. Эффективная по параметрам тонкая настройка (PEFT) изменяет или добавляет небольшой набор параметров, оставляя большую часть базовой модели замороженной.
- Адаптеры вставляют небольшие обучаемые модули в сеть.
- LoRA представляет обновления весов низкоранговыми матрицами, уменьшая количество обучаемых параметров и память оптимизатора.
- Тюнинг подсказок и префиксов обучает непрерывные задачеспецифические входы или внутренние префиксы.
PEFT позволяет хранить множество адаптаций задач вокруг одной базовой модели, хотя обслуживание инференса, совместимость адаптеров и управление объединёнными весами всё ещё требуют тщательной инженерии.
Перенос обучения между типами данных
Классификаторы изображений обычно начинаются с моделей, предобученных на больших наборах изображений. Языковые системы стартуют с базовой модели и адаптируют её через контролируемую тонкую настройку, оптимизацию предпочтений, поиск или использование инструментов. Модели речи, аудио, белков и мультимодальные модели следуют аналогичным паттернам.
Перенос может происходить и без изменения исходной модели. Замороженная модель может генерировать эмбеддинги для downstream‑классификатора, системы поиска векторного сходства или конвейера извлечения.
Смещение домена и отрицательный перенос
Смещение домена происходит, когда целевые входы отличаются от исходных данных. Например, модель медицинских изображений может столкнуться с оборудованием, популяциями или протоколами съёмки, отсутствующими в предобучении. Отрицательный перенос означает, что повторное использование ухудшает производительность по сравнению с адекватным базовым обучением с нуля.
Командам следует сравнивать стратегии адаптации, оценивать значимые подгруппы и держать тестовый набор для целевого домена. Если исходная задача плохо совпадает, более мелкая модель, специфичная для домена, может превзойти большую общую модель.
Лицензирование, происхождение и безопасность
Скачиваемая модель не автоматически безопасна для развёртывания. Проверьте лицензию, разрешённые использования, раскрытие данных обучения, ограничения карточки модели и цепочку зависимостей. Модели могут воспроизводить предвзятость, запоминать конфиденциальные данные или содержать вредоносный сериализованный код. Используйте проверенные форматы, сканируйте артефакты и загружайте недоверенные веса в изолированной среде.
Когда использовать перенос обучения
Перенос обучения является надёжным выбором, когда существует релевантная предобученная модель и целевые данные ограничены. Обучение с нуля может быть предпочтительным, когда домен сильно специализирован, лицензия несовместима, размер модели превышает ограничения развёртывания или простая задача не выигрывает от большой предобученной представления. Решение следует проверять эмпирически, а не предполагать исходя из масштаба модели.
Что переносится и как это адаптировать
Перенос обучения повторно использует представления, изученные на исходной задаче или наборе данных, для целевой задачи. В компьютерном зрении ранние признаки часто фиксируют края и текстуры; в языковых моделях предобученные модели кодируют статистические паттерны токенов и контекстов. Перенос работает, когда исходные представления содержат информацию, релевантную целевой задаче, однако различия в домене, метках, модальностях и способах получения данных могут вызвать отрицательный перенос. Начните с предобученного базового решения, проверьте лицензию и документацию, и сравните с обучением небольшого целевого специфичного решения с нуля.
Извлечение признаков замораживает основу и обучает новую головку; частичная тонкая настройка размораживает выбранные слои; полная тонкая настройка обновляет всю модель. Эффективные по параметрам методы добавляют адаптеры или низкоранговые обновления, уменьшая количество обучаемых параметров, но не обязательно объём памяти при инференсе. Используйте более низкую скорость обучения для предобученных весов, сохраняйте поведение нормализации и избегайте катастрофического забывания с помощью расписаний, регуляризации, репетиции или ограниченных обновлений при необходимости. Выбирайте контрольные точки по валидации на целевых данных и тестируйте несколько случайных инициализаций, поскольку небольшие целевые наборы данных дают высокую дисперсию.
Данные, оценка и компромиссы развёртывания
Целевые данные должны отражать условия эксплуатации и важные подгруппы, а не быть лишь удобным размеченным образцом. Делите данные по субъекту, источнику, времени или месту, чтобы связанные примеры не пересекали разделы. Тестируйте как в‑доменных, так и в смещённых условиях. Сравнивайте замороженные, частично настроенные и полностью настроенные варианты по качеству, калибровке, стоимости обучения, задержке и надёжности. Улучшение среднего балла может скрывать падение по редким классам, унаследованным от предвзятости источника. Анализируйте примеры с ошибками на предмет специфических для источника «кратчайших путей», пробелов в словарном запасе или различий в сенсорах.
Отслеживайте базовую модель, веса, токенизатор или предобработку, адаптер, данные и лицензию как единый граф зависимостей. Хостинг базовых моделей может менять поведение; открытые веса могут вводить риски цепочки поставок и необходимость патчей. Проверяйте объединённый или экспортированный артефакт и сканируйте файлы модели из недоверенных источников. В продакшене мониторьте дрейф целевых данных и производительность, сохраняйте возможность отката как адаптации, так и базовой версии. Перенос уменьшает требуемый объём целевых данных; он не устраняет необходимость маркировки, оценки, конфиденциальности или экспертизы домена.
Практический пример: адаптация модели зрения к новой клинике
Клиника адаптирует предобученный кодировщик изображений для классификации качества изображений перед диагностическим обзором. Она проверяет лицензию исходной модели и целевую модальность, собирает локальные устройства и условия съёмки, а также делит данные по пациентам. Сравниваются варианты замороженных признаков, адаптеров, частичной и полной тонкой настройки с небольшим локальным базовым решением. Метрики включают полноту классов, калибровку, поведение подгрупп, вычислительные затраты и чувствительность к устройству, месту и редким артефактам.
Адаптированная модель не делает диагноз и перенаправляет изображения с низкой уверенностью или неподдерживаемые изображения к технологам. Валидация экспорта подтверждает локальную предобработку и числовую эквивалентность. Версии модели, адаптера, устройства и набора данных связываются в записи. Мониторинг обнаруживает новые сканеры, изменения протоколов и дрейф вывода, а периодически проверяемые образцы оценивают реальную производительность. Обновление исходной модели рассматривается как новая зависимость, требующая валидации; перенос обучения не оправдывает автоматическое повторное использование старых доказательств.
Доказательства реализации и готовность к эксплуатации
Производственное решение требует больше, чем успешную демонстрацию. Определите целевых пользователей, рабочую среду, входы, выходы, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимый базовый уровень и версионированный набор оценок до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входы, смещение распределения, сбой зависимостей, неправильное использование и группы или среды, наиболее подверженные недостаточному обслуживанию. Измеряйте качество задачи совместно с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за релиз, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развёртывание, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно введёнными сбоями. Операционная телеметрия должна показывать качество входов, поведение выходов, версию модели или правила, состояние зависимостей, человеческие вмешательства и подтверждённые результаты без сбора лишних конфиденциальных данных. Определите пороги тревоги и ответственного, затем после развёртывания проверяйте реальные доказательства, а не полагайтесь на офлайн‑производительность. Переоценивайте при изменении источников данных, пользователей, моделей, поставщиков, политик, аппаратуры или целей. Поддерживаемая система также нуждается в документированных процедурах восстановления, обучения на инцидентах, удаления и хранения, а также в чётком моменте, когда её следует отключить или заменить.
Основные ссылки