Основы ИИ
Что такое большие языковые модели (LLM)?

 Добавьте Unite.AI в избранные источники в Google
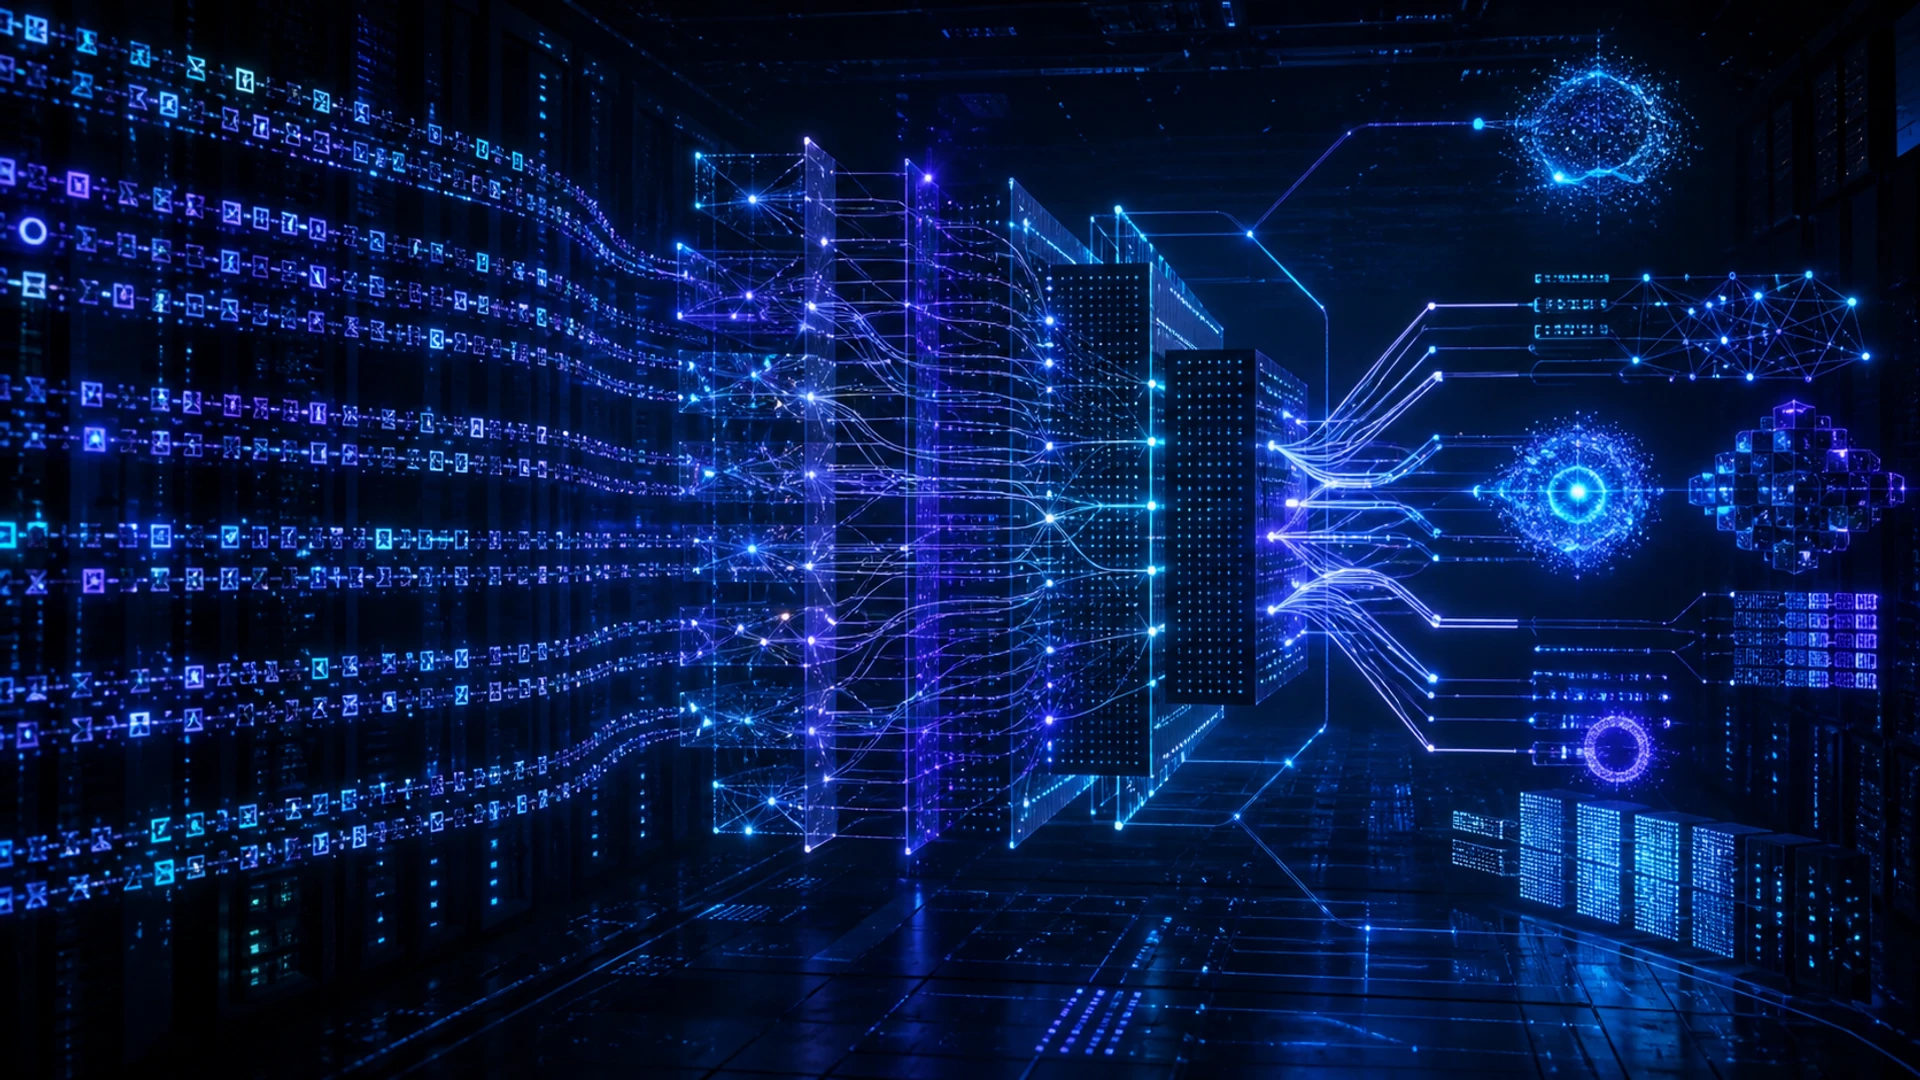
Большая языковая модель (LLM) — это нейронная сеть, обученная на больших коллекциях последовательностей для предсказания токенов или связанных языковых задач. Большинство современных LLM используют архитектуру трансформеров и могут генерировать, классифицировать, суммировать, переводить, извлекать и преобразовывать язык через единый интерфейс.
LLM не является базой данных или гарантированным рассуждателем. Его вывод — условное предсказание, формируемое данными обучения, постобучением, контекстом, инструментами и декодированием. Свободное владение языком может сосуществовать с фактическими ошибками, неопределённостью, предвзятостью или небезопасным поведением.
Ключевые выводы
- Токенизация преобразует текст в отдельные единицы; эмбеддинги и механизм внимания формируют контекстные представления.
- Предобучение изучает общие закономерности, а дообучение и методы предпочтений формируют поведение для конкретных задач.
- Поиск и инструменты могут добавлять актуальные доказательства или действия, но требуют отдельного разрешения и проверки.
- Оценивайте развернутую систему по качеству, обоснованности, безопасности, задержке, стоимости и дрейфу.
Токены, трансформеры и предобучение
Текст делится на токены. Трансформер преобразует их в векторы, смешивает информацию с помощью механизмов внимания и слоёв прямого распространения, и генерирует распределение вероятностей для следующего или отсутствующего токена.
Самостоятельно контролируемые задачи создают обучающие сигналы из необработанных последовательностей. Масштабирование параметров, данных и вычислительных ресурсов может предсказуемо уменьшать ошибку, однако качество набора данных, архитектура, оптимизация и оценка определяют, какие возможности проявятся на практике.
Постобучение и вывод
Тонкая настройка по инструкциям использует демонстрации; оптимизация предпочтений может делать выводы более соответствующими человеческим оценкам или политике. При выводе запрос и история диалога определяют контекст, а параметры температуры и стратегии сэмплинга влияют на вариативность.
RLHF и аналогичные методы формируют поведение, а не внедряют полноценный факт‑чекер. Модель всё равно может сгенерировать правдоподобный, но необоснованный ответ.
Поиск, инструменты и агенты
Генерация с поддержкой поиска предоставляет отрывки, выбранные из внешней коллекции. Вызов инструментов позволяет прикладному коду выполнять запросы к базам данных, вычислять, искать или действовать. Такие схемы отделяют часть знаний и выполнения от весов модели.
Приложение должно проверять аргументы инструментов, обеспечивать разрешения, сохранять ссылки и рассматривать полученный контент как недоверенный ввод. Поиск по векторному сходству облегчает поиск, но не доказывает, что отрывок поддерживает ответ.
Ограничения и оценка
LLM могут галлюцинировать, раскрывать запомненный контент, выполнять злонамеренные инструкции, воспроизводить предвзятость и проваливаться в задачах, которые кажутся похожими на обучающие примеры. Длинный контекст не гарантирует, что каждый факт будет использован или правильно согласован.
Оценивайте на репрезентативных закрытых задачах с документированными запросами и версиями. Измеряйте поддержку источниками, отказы, калибровку, безопасность, результаты для подгрупп, нагрузку на человека, задержку и стоимость. Следите после выпуска, поскольку модели, данные и поведение пользователей меняются.
Данные для обучения и разработка модели
Корпусы для предобучения объединяют веб‑страницы, книги, код, академический материал, диалоги и лицензированные или отобранные источники. Конвейеры определяют язык, удаляют дубликаты, фильтруют качество и небезопасный контент, обрабатывают персональные данные и выбирают веса смеси. Эти решения формируют знания, охват языков, стиль, предвзятость и запоминание.
Оптимизационные процессы группируют последовательности токенов и минимизируют ошибку предсказания с помощью градиентного спуска. Распределённое обучение делит данные, тензоры модели, этапы конвейера или экспертов между ускорителями. Сохранение контрольных точек, численная стабильность, сетевое взаимодействие и восстановление после сбоев становятся ключевыми инженерными задачами при масштабировании.
Оценка в процессе обучения отслеживает ошибку и наборы возможностей, однако загрязнение бенчмарков может завысить результаты. Выделяйте отдельные временные периоды и проприетарные задачи, ищите пересечения и публикуйте точные запросы, методы декодирования, инструменты и оценивание. Модель может улучшать среднюю ошибку, в то время как регрессии проявляются в безопасности или для малообеспеченных языков.
Контекстные окна, декодирование и вывод
При выводе кэш ключ‑значение хранит проекции внимания для предыдущих токенов, чтобы их не пересчитывать на каждом шаге. Память кэша растёт с количеством слоёв, длиной последовательности, размером пакета и представлением. Квантование и подкачка снижают нагрузку, но могут менять качество или задержку.
Жадное декодирование выбирает токен с наивысшей вероятностью; температура пересчитывает вероятности; top‑k и top‑p ограничивают набор кандидатов; лучевой поиск отслеживает несколько последовательностей. Наилучшая стратегия зависит от того, ценит ли задача детерминизм, разнообразие, структурированный вывод или вероятность последовательности. Всегда проверяйте схему после генерации.
Длинный контекст увеличивает объём доступной информации, но не гарантирует воспоминание или рассуждение. Позиция, отвлекающие элементы, противоречия и структура запроса влияют на использование. Поиск может выбрать более компактный набор доказательств, тогда как суммирование сжимает историю с риском потери деталей. Оценивайте производительность в зависимости от длины и положения контекста.
Адаптация, развертывание и экономика
Полное дообучение обновляет все параметры; параметр‑эффективные методы обновляют адаптеры или низко‑ранговые матрицы; продолжительное предобучение адаптирует распределение по домену; настройка по инструкциям и предпочтениям формирует ответы. Поиск часто лучше подходит для часто меняющихся фактов, тогда как дообучение лучше для поведения и формата задач. Методы можно комбинировать.
Варианты развертывания включают хостинговые API, управляемые конечные точки, самостоятельный хостинг открытых весов, модели на устройстве и гибридные решения. Сравнивайте обработку данных, контроль версий, задержку, пропускную способность, регионы, доступность, переносимость модели, поддержку и общую стоимость. Самостоятельный хостинг переносит ответственность за безопасность, масштабирование, обновления и мониторинг злоупотреблений.
Стоимость за токен — неполный показатель. Слабая модель может требовать повторных запросов, более длинных подсказок, большего количества проверок или дорогостоящих ошибок. Измеряйте стоимость за успешно выполненную задачу при требуемом качестве и уровне риска. Применяйте кэширование, пакетную обработку, более мелкие модели и детерминированный код, где они улучшают весь рабочий процесс.
Практический пример: привязка LLM к корпоративным документам
Документальный помощник должен начинаться с корпуса, учитывающего разрешения, стабильных идентификаторов документов, версий и дат вступления в силу, парсируемой структуры и набора вопросов для оценки, включающего отвечаемые, неотвечаемые, неоднозначные и конфликтующие вопросы. Поисковые индексы разбивают на фрагменты и метаданные, однако размер фрагмента и перекрытие должны соответствовать структуре документа. Качество поиска измеряется независимо от генерации, чтобы свободно говорящая модель не могла скрыть отсутствие доказательств.
Во время выполнения аутентифицируйте пользователя, фильтруйте поиск по доступу, извлекайте и переупорядочивайте доказательства, формируйте ограниченный запрос, генерируйте ответ с цитатами и проверяйте требуемый вывод. Модель должна указывать, когда источники конфликтуют или не поддерживают ответ. Использование инструментов и внешних действий требует отдельного разрешения. Защищайтесь от инструкций, встроенных в найденные документы, рассматривая их как данные, а не как приоритетную системную политику.
Оценивайте полноту поиска, точность цитирования, правильность ответа, обоснованность, отказы, задержку и стоимость для разных ролей и типов документов. Отслеживайте версии модели, запроса, индекса, парсера и корпуса для каждого теста. В продакшене фиксируйте идентификаторы доказательств и обратную связь без раскрытия конфиденциального текста, контролируйте появление новых неотвечаемых вопросов после изменений контента и поддерживайте безопасный резерв. Интерфейс LLM не заменяет управление записями, контроль доступа или ответственный экспертный обзор.
Планирование мощности должно моделировать распределения длины запросов и ответов, количество одновременных пользователей, поведение кэша, задержку инструментов и частоту повторных попыток. Потоковая передача уменьшает воспринимаемую задержку, но усложняет модерацию и отмену, поскольку небезопасный или неверный контент может достичь пользователя до полной проверки ответа. Устанавливайте бюджеты токенов и инструментов, изолируйте арендаторов, защищайте учётные данные провайдера и репетируйте переключение между версиями модели без скрытого изменения поведения, от которого зависят пользователи.
Практический чеклист реализации
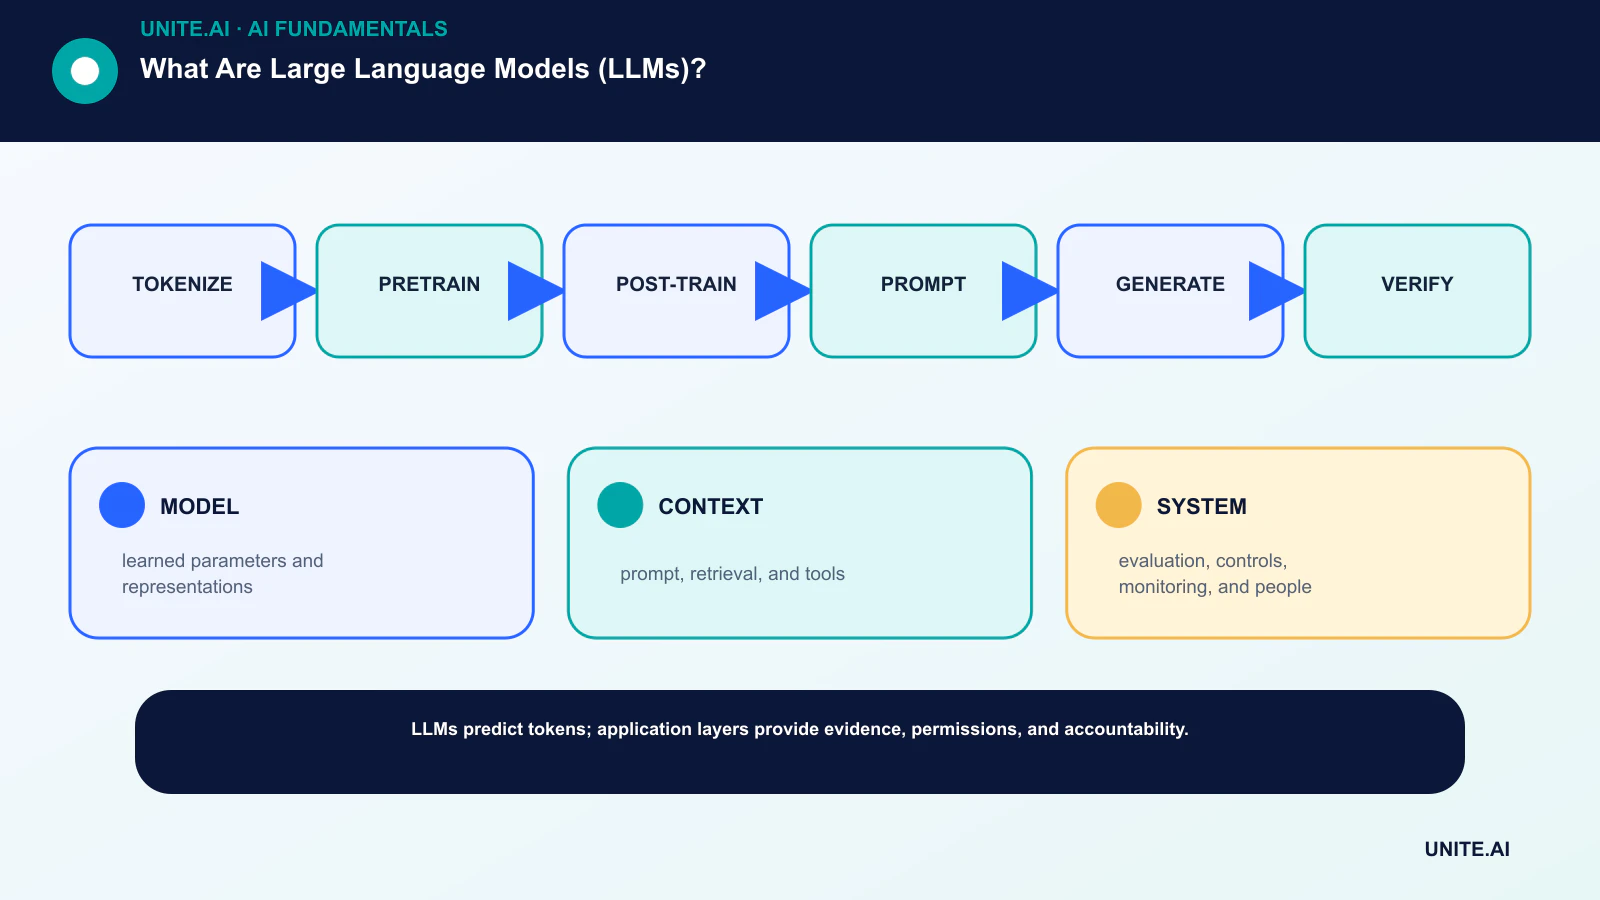
Преобразуйте концепцию в ограниченный, проверяемый рабочий процесс: токенизировать → предобучать → постобучать → задавать запрос → генерировать → проверять. Назначьте ответственного владельца, задокументируйте данные и зависимости, установите простую базовую линию, задайте критерии принятия и остановки, протестируйте типичные сбои и определите мониторинг, откат и ревизию перед расширением области. Записывайте версии и предположения, чтобы другая команда могла воспроизвести результат и понять, что изменилось.
Перед запуском проведите документированный обзор готовности с людьми, которые разрабатывают, эксплуатируют, защищают и затронуты системой. Тестируйте обычные случаи, граничные условия, отказы зависимостей и неправильное использование; сохраняйте доказательства и нерешённые риски. Определите, кто может одобрять выпуск, менять порог, переопределять вывод или останавливать работу. Пересмотрите решение после поступления реальных данных, поскольку технически успешный пилот не гарантирует надёжную работу в более широком масштабе.
- МОДЕЛЬ: выученные параметры и представления.
- КОНТЕКСТ: запрос, поиск и инструменты.
- СИСТЕМА: оценка, контроль, мониторинг и люди.
Часто задаваемые вопросы
Почему LLM называют большими?
Нет универсального порога по количеству параметров. «Большой» относится к масштабу относительно более ранних языковых моделей, включая количество параметров, объём обучающих данных, вычислительные ресурсы и широту применения.
Понимают ли LLM язык?
Они формируют полезные внутренние представления и демонстрируют сложное поведение, но слово «понимать» имеет несколько значений. Производительность следует демонстрировать по отдельным задачам, а не делать выводы из беглости речи.
Основные ссылки