Основы ИИ
Что такое обучение с подкреплением?

 Добавьте Unite.AI в избранные источники в Google
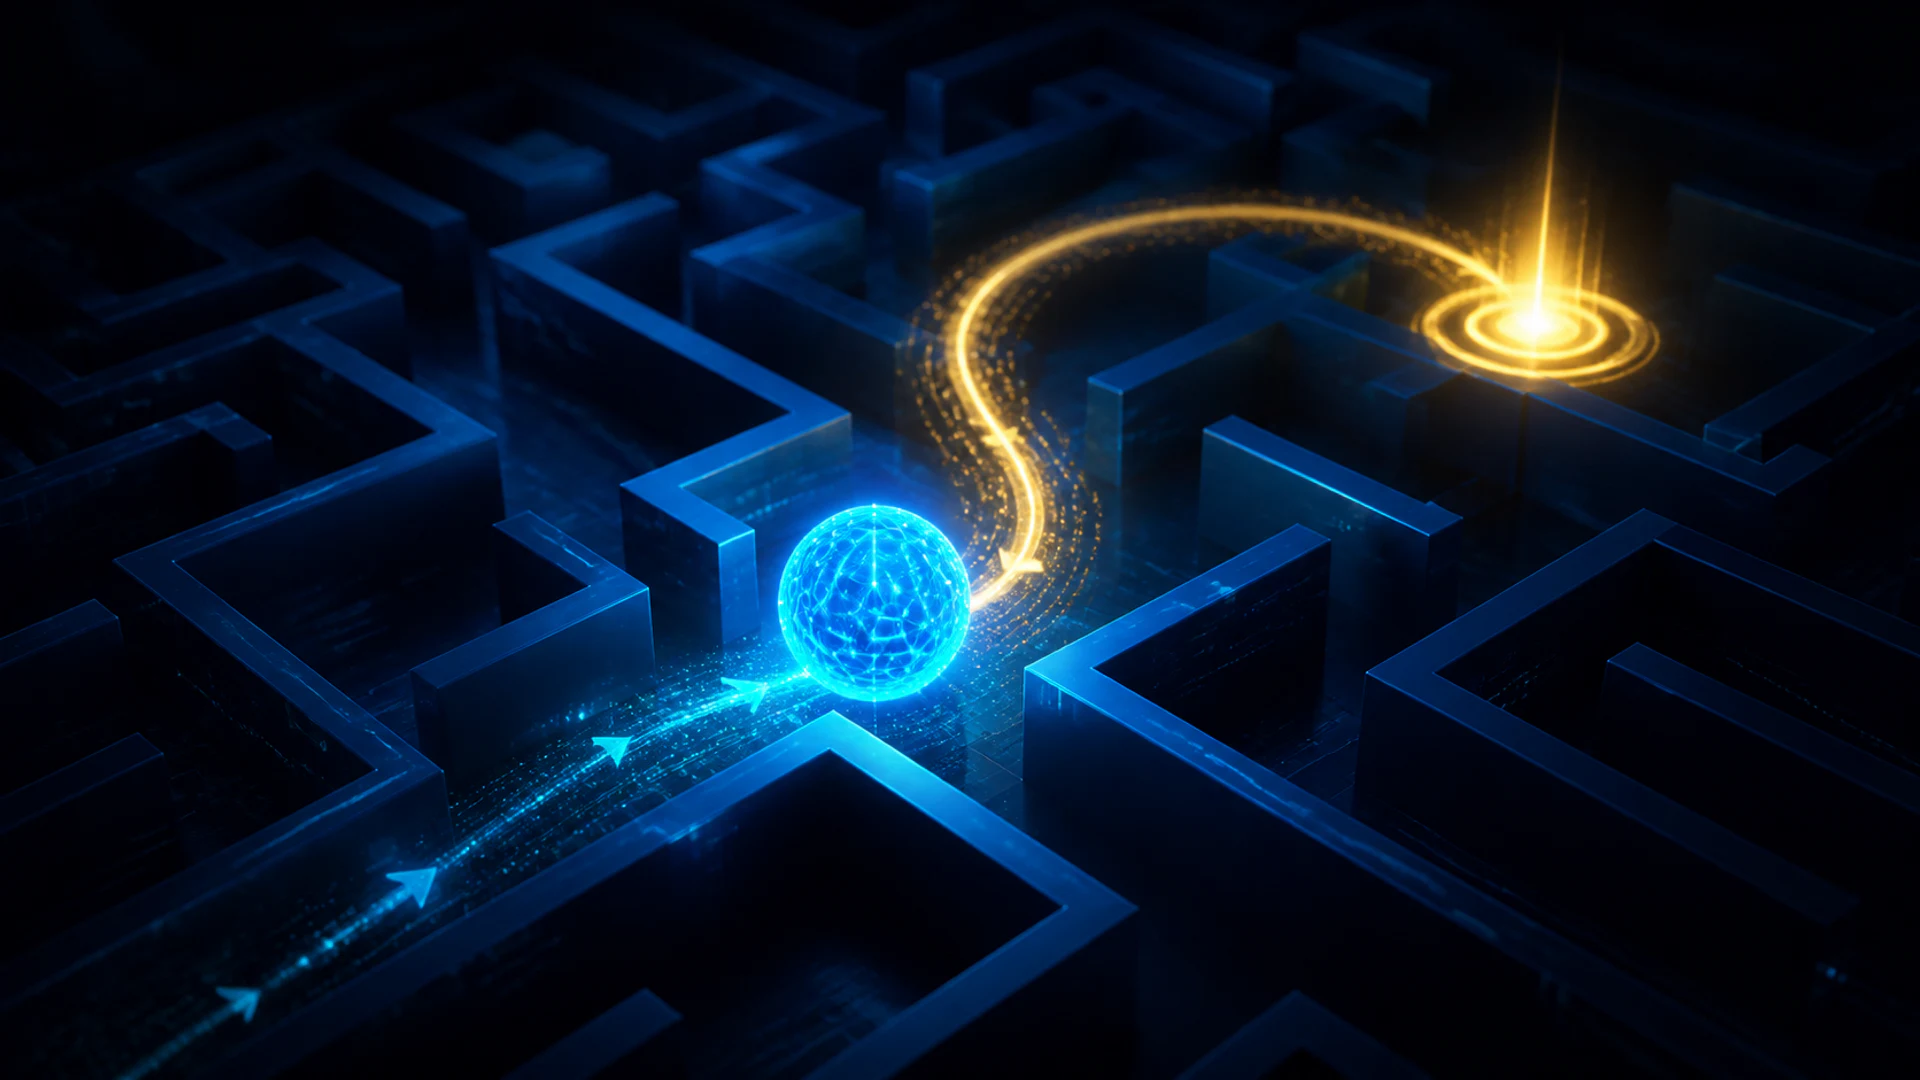
Обучение с подкреплением (RL) — это рамочная система машинного обучения, в которой агент учится действовать, взаимодействуя со средой. После каждого действия среда меняется и может вернуть награду. Цель агента — выучить политику, максимизирующую ожидаемую совокупную награду, а не только награду за следующий ход.
RL применяется, когда решения принимаются последовательно во времени, и одно действие влияет на последующее событие. Это концептуально отличается от обучения с учителем, где набор данных предоставляет целевой ответ для каждого обучающего примера.
Ключевые выводы
- Задача RL включает агента, среду, состояния, действия, награды и политику.
- Положительное и отрицательное подкрепление оба усиливают поведение; наказание уменьшает его.
- Агент должен балансировать между исследованием неизвестных действий и использованием уже известных эффективных действий.
- Методы, основанные на ценностях, политике, актёр‑критик, моделируемые и офлайн‑подходы решают разные сценарии RL.
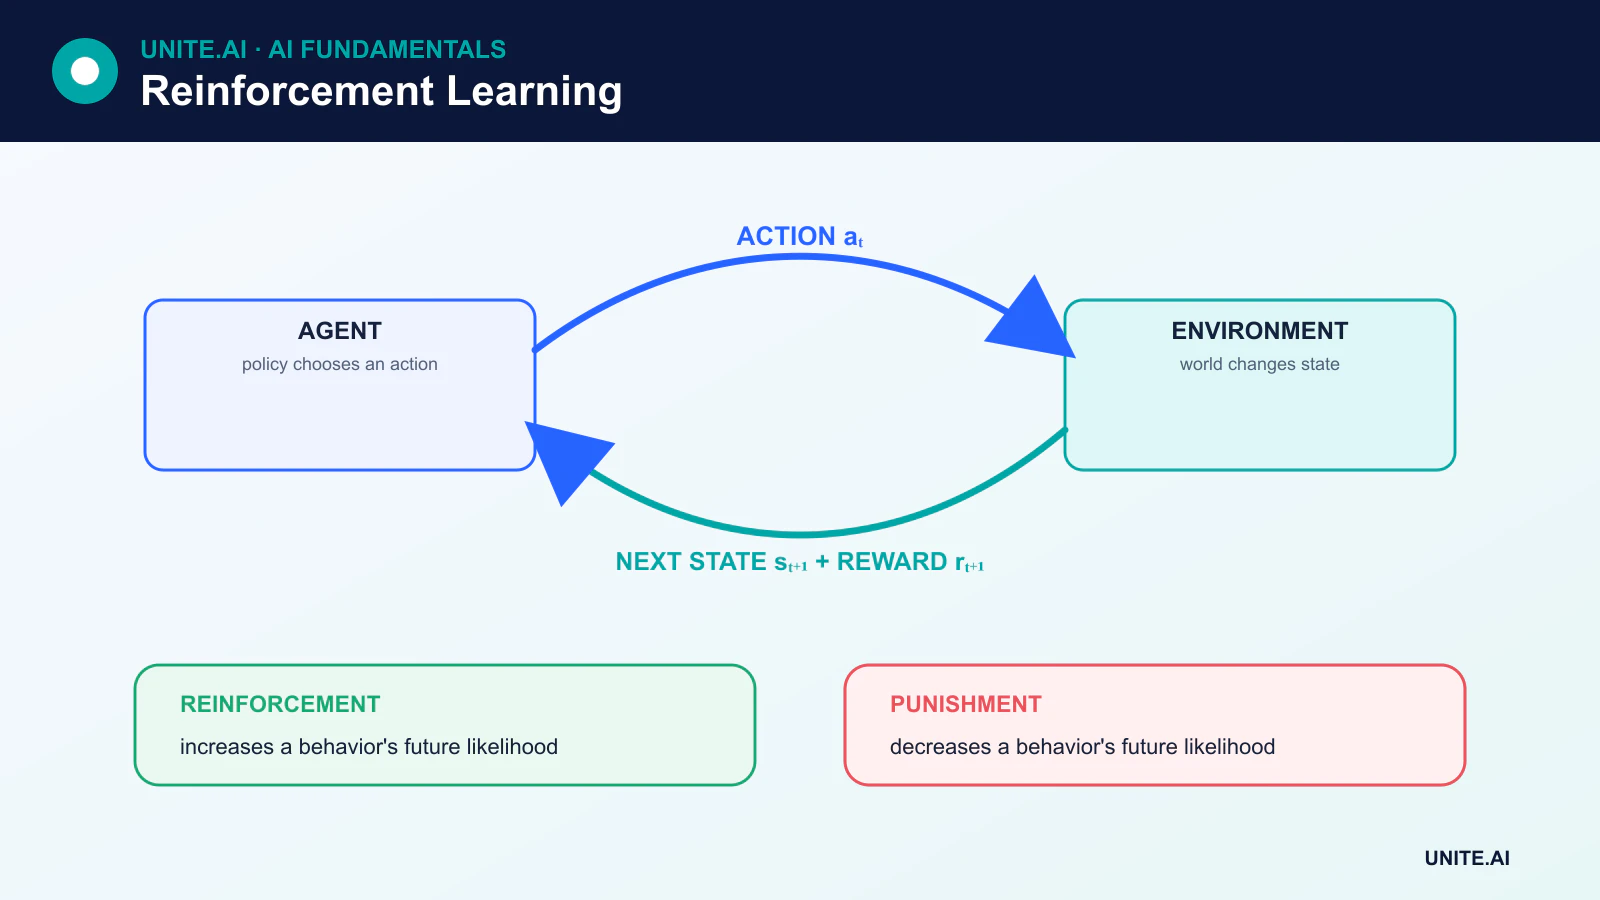
Компоненты обучения с подкреплением
Во многих задачах RL используется модель марковского процесса принятия решений (MDP). MDP включает:
- Состояние: информация, описывающая текущую ситуацию.
- Действие: вариант, доступный агенту.
- Переход: как состояние меняется после действия.
- Награда: мгновенная обратная связь, получаемая после перехода.
- Политика: стратегия агента по выбору действий.
- Коэффициент дисконтирования: насколько сильно будущие награды учитываются по сравнению с мгновенными.
Состояние не обязано раскрывать всю информацию о мире. Когда важные данные скрыты, задача может стать частично наблюдаемой, и агенту может потребоваться память или состояние убеждений.
Подкрепление не то же самое, что наказание
Терминология происходит из бихевиористской психологии. Положительное подкрепление добавляет последствие, повышающее вероятность поведения. Отрицательное подкрепление устраняет неприятное условие, также повышая вероятность поведения. Штраф, направленный на снижение вероятности действия, является наказанием, а не отрицательным подкреплением.
В машинном обучении практики чаще говорят непосредственно о положительных наградах, отрицательных наградах, издержках и штрафах. Главное — как эти сигналы формируют возврат, который агент стремится максимизировать.
Возврат, ценность и распределение заслуг
Награда описывает один переход. Возврат объединяет награды во времени, обычно дисконтируя те, которые приходят дальше в будущем. Функция ценности состояния оценивает ожидаемый возврат из состояния, тогда как функция ценности действия оценивает ожидаемый возврат после выполнения конкретного действия в этом состоянии.
Это порождает проблему распределения заслуг: если полезный результат появляется значительно позже, какие ранние действия заслуживают признания? Алгоритмы RL различаются тем, как они оценивают эту связь.
Обучение методом Монте‑Карло и методом временных различий
Методы Монте‑Карло обучаются на полных выборочных возвратах, обычно после завершения эпизода. Методы временных различий (TD) обновляют оценку до окончательного результата, комбинируя наблюдаемую награду с оценкой того, что будет дальше. Таким образом, обучение TD опирается на текущие оценки ценности.
Ни одна из семей не является универсально лучшей. Цели Монте‑Карло являются несмещёнными при выбранной политике, но могут обладать высокой дисперсией и требуют завершения эпизода. Методы TD могут обучаться онлайн и на непрерывных задачах, однако их бутстрэп‑цели вводят смещение.
Исследование против эксплуатации
Исследование собирает информацию, пробуя действия с неопределённой ценностью. Эксплуатация выбирает действие, которое, по текущим оценкам, даёт наилучший возврат. Агент, который никогда не исследует, может застрять в плохой стратегии; агент, который никогда не эксплуатирует, не использует полученные знания.
Простые стратегии включают ε-жадный выбор действий, исследование, основанное на уверенности, бонусы энтропии и методы внутренней награды. В критически важных для безопасности условиях неограниченное исследование может быть неприемлемо, поэтому важны моделирование, ограничения, офлайн‑данные или человеческий контроль.
Основные подходы к обучению с подкреплением
Методы, основанные на ценностях
Q‑обучение и связанные алгоритмы изучают ценности действий и формируют политику, выбирая действия с высокой ценностью. Глубокое обучение с подкреплением использует нейронные сети для аппроксимации функций ценности или политик, когда пространство состояний слишком велико для таблицы.
Методы градиентного обучения политики
Методы градиентного обучения политики напрямую корректируют параметризованную политику для улучшения ожидаемого возврата. Они полезны для непрерывных действий и стохастических политик, но могут иметь оценки градиента с высокой дисперсией.
Методы актёр‑критик
Актёр выбирает действия, а критик оценивает ценность и предоставляет обучающий сигнал. Это сочетает прямую оптимизацию политики с оценкой ценности.
Моделируемое и немоделируемое обучение с подкреплением
Системы, основанные на модели, изучают или используют модель переходов и наград, чтобы планировать. Системы без модели обучают ценности или политики без явного моделирования среды. Методы, основанные на модели, могут эффективно использовать опыт, однако ошибки в изученной модели могут вводить в заблуждение планирование.
Офлайн‑обучение с подкреплением
Офлайн‑RL обучается на фиксированном наборе данных, а не собирает новые взаимодействия во время обучения. Это может снизить стоимость или риск исследования, однако агент должен избегать переоценки действий, слабо представленных в данных.
RLHF и человеческие предпочтения
Обучение с подкреплением по обратной связи от человека (RLHF) использует данные предпочтений для обучения сигнала награды или прямой оптимизации политики. Оно применялось для согласования поведения языковых моделей с человеческими оценками. Оптимизация предпочтений не гарантирует правдивости или безопасности: результаты зависят от того, кто предоставил обратную связь, что именно оценивалось и как была сформулирована цель.
Ограничения
RL может требовать огромного количества взаимодействий, вести себя нестабильно во время обучения и использовать непреднамеренные обходные пути в функции награды. Оценка затруднена, поскольку результаты могут различаться из‑за случайных инициализаций и особенностей среды. Лучшие практики включают множественные запуски, прозрачные базовые линии, ограниченные цели, тестирование вне распределения и мониторинг попыток «взлома» награды.
Проектирование задачи RL: состояние, действие, награда и горизонт
Обучение с подкреплением моделирует последовательные решения. Среда генерирует наблюдение, агент выбирает действие согласно политике, а переход приводит к награде и следующему наблюдению. Марковский процесс принятия решений предполагает, что состояние содержит информацию, необходимую для предсказания будущих переходов и наград; частичная наблюдаемость требует памяти, состояния убеждений или рекуррентных представлений. Дисконтирование регулирует вес отложенных результатов, тогда как эпизодные и непрерывные задачи требуют разных определений возврата. Плохой дизайн состояний или действий может сделать решаемую цель необучаемой.
Проектирование награды задаёт поведение косвенно и является основным источником неудач. Прокси может быть использован в корыстных целях: агент, получающий награду за скорость, может игнорировать безопасность, тогда как агент, награждаемый только по завершении задачи, может получать слишком слабый сигнал обучения. Добавляйте ограничения и правила завершения, основанные на реальных требованиях, проверяйте чувствительность награды и анализируйте траектории на предмет непреднамеренных стратегий. Методы исследования балансируют сбор информации с эксплуатацией текущих знаний. Данные вне политики могут повысить эффективность выборки, однако несоответствие между поведением и целевой политикой требует соответствующих алгоритмов.
Оценка, моделирование и безопасный ввод в эксплуатацию
Методы, основанные на ценностях, оценивают ожидаемый возврат для состояний или действий; методы градиентного обучения политики оптимизируют параметризованную политику; методы актёр‑критик обучают и то, и другое. Моделируемое RL изучает или использует динамику переходов для планирования. Выбор подходящей семьи зависит от типа действий, данных, точности симулятора, горизонта и требований к стабильности. Сравнивайте с эвристическими, обученными с учителем и контроллерными базовыми линиями. Оценивайте средний и худший возврат, нарушения ограничений, эффективность выборки, устойчивость к изменениям среды и дисперсию по разным инициализациям, а не выбирайте запуск с лучшей кривой обучения.
Онлайн‑исследование может быть неприемлемо в здравоохранении, финансах, робототехнике и инфраструктуре. По возможности обучайте в симуляции или на записанных данных, оцените разрыв между симулятором и реальностью и тщательно используйте оценку вне политики, поскольку невидимые действия не поддерживаются. При вводе в эксплуатацию следует ограничить действия, частоту, ресурсы и рабочий диапазон; включить человеческое одобрение для критически важных решений; обеспечить безопасный контроллер или отключение. Следите за наградой вместе с реальными результатами, поскольку агент может улучшать свой показатель, нанося вред поставленной цели. Проводите повторную проверку после изменений среды, политики или награды.
Пример: управление энергией с помощью обучения с подкреплением
Оператор здания моделирует температуру, занятость, погоду, состояние оборудования и цену электроэнергии, при этом действия ограничены безопасными корректировками уставок. Награда объединяет комфорт, энергопотребление, плату за спрос и ограничения оборудования, однако реальные нарушения комфорта оцениваются отдельно, чтобы оптимизация награды не могла скрывать вред. Историческое управление и модельно‑прогнозирующее управление служат базовыми линиями. Обучение проводится в откалиброванном симуляторе с рандомизацией погоды, шумом датчиков и эффективностью оборудования.
Прежде чем влиять на здание, политика тестируется на живых наблюдениях без выполнения действий. Инженеры проверяют траектории, запасы ограничений и поведение в праздничные дни, периоды жары, отключения и при отсутствии датчиков. При вводе в эксплуатацию ограничивается частота и диапазон действий, сохраняется существующий контроллер безопасности. Человек может вмешаться в любой момент. Мониторинг сравнивает энергопотребление и комфорт с сопоставимыми периодами, фиксирует вмешательства и откатывается, если нарушения, неожиданные циклы или несоответствие модели превышают заданные пороги.
Доказательства реализации и готовность к эксплуатации
Производственное решение требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочую среду, входы, выходы, зависимости, владельца и последствия каждой важной ошибки. Установите воспроизводимую базовую линию и версионированный набор для оценки до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входные данные, сдвиги распределения, сбои зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный ввод, сохраняйте безопасный резерв и проверяйте мониторинг с преднамеренно внедрёнными сбоями. Оперативная телеметрия должна показывать качество входов, поведение выходов, версию модели или правила, состояние зависимостей, человеческие вмешательства и подтверждённые результаты без сбора ненужных конфиденциальных данных. Определите пороги оповещений и ответственного за реакцию, затем проверяйте реальные доказательства после внедрения, а не полагайтесь на сохранение офлайн‑производительности. Проводите переоценку при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также требует документированного восстановления, обучения на инцидентах, процедур удаления и хранения, а также чёткой точки, в которой её следует отключить или заменить.
Основные ссылки