
Основы ИИ
Что такое генеративная состязательная сеть (GAN)?

 Добавьте Unite.AI в избранные источники в Google
Генеративная состязательная сеть (GAN) обучает две нейронные сети в конкуренции. Генератор преобразует случайный или условный ввод в синтетические образцы. Дискриминатор пытается отличить сгенерированные образцы от реальных обучающих примеров. Обратная связь каждой сети меняет задачу обучения другой.
GAN могут создавать чёткие изображения и управляемые синтетические данные, но обучение в состязательной схеме трудно стабилизировать. Визуальная реалистичность не является доказательством разнообразия, фактической достоверности или разрешения на использование обучающих данных.
Ключевые выводы
- Генератор создает образцы; дискриминатор обучается сигналу решения «реальное‑против‑сгенерированного».
- Обучение стремится к равновесию, но изменение соперников может вызывать нестабильность, осцилляции или коллапс режимов.
- Условные GAN управляют генерацией с помощью меток, текста или другого контекста.
- Оценка должна проверять достоверность, охват, запоминание и риски downstream — а не только качество изображения.
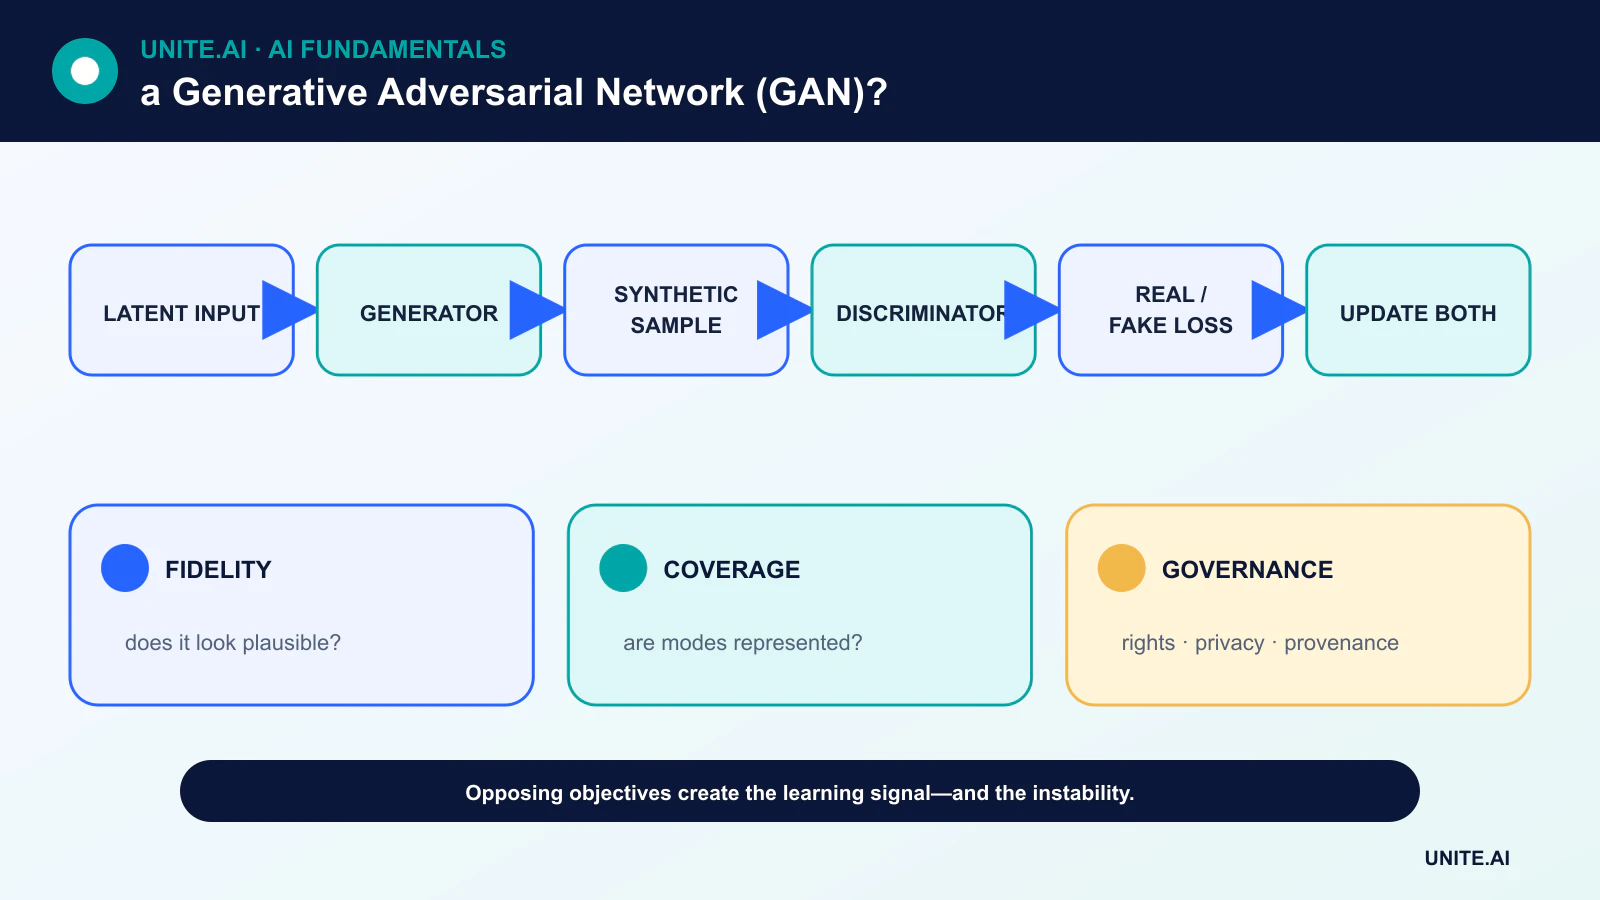
Состязательная игра
Исходная формулировка представляет собой двухигроковую игру с минимаксом. Дискриминатор улучшает способность отделять реальные данные от сгенерированных, в то время как генератор улучшает создание образцов, которые дискриминатор классифицирует как реальные. Оба обучаются с помощью обратного распространения ошибки.
Если дискриминатор становится слишком точным, его обратная связь генератору может стать бесполезной. Если он слишком слаб, генератор может воспользоваться простыми обходными путями. Поэтому обучение чередует обновления и тщательно балансирует ёмкость, функции потерь и параметры оптимизации.
Коллапс режимов и стабильность обучения
Коллапс режимов происходит, когда множество скрытых входов приводит к похожим выходам, поэтому образцы выглядят правдоподобно, но охватывают лишь часть распределения данных. Другие сбои включают осцилляцию, взрывающиеся градиенты и чувствительность к случайной инициализации.
Цели Вассерштейна, штрафы за градиенты, спектральная нормализация, изменения архитектуры и настроенные коэффициенты обновления могут улучшить стабильность. Однако они не устраняют необходимость проверять разнообразие и повторять эксперименты с несколькими семенами.
Условная генерация и управление латентным пространством
Условный GAN предоставляет генератору и дискриминатору метку или иной контекст, позволяя целенаправленно генерировать классы или атрибуты. Архитектуры на основе стиля разделяют аспекты управления латентным пространством на разных разрешениях и позволяют получать чрезвычайно реалистичные изображения.
Латентные направления могут коррелировать с человеческими понятиями, но изменение одного атрибута может влиять на другие, поскольку обучающие данные содержат коррелированные признаки. Утверждения о контролируемости следует проверять на разнообразных идентичностях и контекстах.
Оценка, конфиденциальность и происхождение
Метрики, такие как Fréchet Inception Distance, сравнивают распределения признаков, но они наследуют допущения модели признаков и могут упускать запоминание или сбои в подгруппах. Анализ ближайших соседей, тесты охвата в стиле precision/recall и человеческая проверка предоставляют дополнительное доказательство.
GAN может запоминать редкие примеры, воспроизводить предвзятость или генерировать вводящие в заблуждение медиа. Команды должны документировать наборы данных, права, фильтрацию, водяные знаки или механизмы происхождения и контроль злоупотреблений. Синтетические данные не являются автоматически анонимными.
GAN, VAE и диффузионные модели
Вариационные автокодировщики оптимизируют вероятностную латентную цель и часто жертвуют резкостью образцов ради структурированного латентного пространства. Диффузионные модели обучаются обратному процессу зашумления и стали распространённой основой для генерации изображений.
GAN остаются полезными, когда важны быстрый однопроходный сэмплинг, специфические отображения «изображение‑в‑изображение» или компактное развертывание. Выбор метода зависит от качества, разнообразия, задержки, стабильности обучения и управления — а не от того, какая архитектура самая новая.
Состязательные цели и динамика обучения
Генеративная состязательная сеть обучает генератор создавать образцы и дискриминатор отличать сгенерированные от реальных данных. В оригинальной игре с минимаксом дискриминатор оценивает сигнал, связанный с отношением плотностей, а генератор пытается его обмануть. Обучение чередует обновления, поэтому каждая сеть учится против движущегося соперника, а не фиксированного лосса. Если дискриминатор становится слишком сильным, градиенты генератора могут стать бесполезными; если слишком слабым — качество генерируемого материала застаивается. Значение лосса само по себе не соответствует качеству образца.
Коллапс режимов возникает, когда генератор выдаёт ограниченное разнообразие, обманывающее дискриминатор. Осцилляция, чувствительность к гиперпараметрам и нестабильная нормализация также распространены. Цели Вассерштейна, штрафы за градиенты, спектральная нормализация, сопоставление признаков, статистика минибатчей и тщательно сбалансированные графики обновлений решают разные механизмы сбоев. Условные GAN используют метки, текст или изображения для управления выводом; архитектуры на основе стиля разделяют латентные влияния. Качество и охват набора данных остаются фундаментальными, поскольку генератор воспроизводит и переупаковывает распределение, которое он видит.
Оценка и ответственное использование
Оценивать достоверность и разнообразие отдельно. Fréchet Inception Distance сравнивает распределения признаков, но зависит от размера выборки, модели признаков, предобработки и домена; Inception Score не сравнивает с реальными данными. Точность и полнота для генеративных моделей, анализ ближайших соседей, проверки запоминания и оценка задач людьми добавляют доказательства. Для научного или медицинского синтеза используйте доменные метрики и последующую валидацию. Храните отложенный реальный набор и сравнивайте с диффузионными или автокорреляционными базовыми моделями при сопоставимых вычислительных ресурсах и разрешении.
GAN могут дополнять данные, переводить домены, повышать разрешение изображений, синтезировать медиа и поддерживать моделирование, но синтетические данные могут усиливать предвзятость или утекать примеры обучения. Проверяйте лицензирование, согласие, идентичность и происхождение. Защищайте от несогласованного подделывания и вводящего в заблуждение использования, помечайте или подписывайте выводы при необходимости и сохраняйте метаданные генерации. Фотореалистичное изображение не является документальным доказательством; неопределённость и синтетическое происхождение должны оставаться видимыми, когда выводы влияют на решения.
Развёртывание и воспроизводимость
Записывайте параметры генератора, дискриминатора, оптимизатора, набора данных, случайного зерна, усечения и настройки сэмплинга. Квантование или экспорт могут изменить нормализацию и вывод, поэтому проверяйте артефакт обслуживания. Отслеживайте распределение запросов или условий, фильтры безопасности, разнообразие вывода, задержку и отчёты. Используйте ограничения скорости и меры защиты личности в публичных системах. Обучение GAN — это связанный эксперимент оптимизации: выбранные демонстрационные изображения не могут гарантировать надёжность, охват или отсутствие запоминания, и модель должна оцениваться на полном распределении предполагаемых задач генерации.
Практический пример: синтетические изображения дефектов с помощью GAN
Производитель обучает условный GAN создавать редкие изображения поверхностных дефектов. Он проверяет, что у обучающих изображений есть права, и разделяет производственные партии до обучения и оценки. Сгенерированные образцы проверяются на запоминание ближайших соседей, геометрию дефекта, артефакты фона, разнообразие и экспертную правдоподобность. Классификатор, обученный с синтетическим дополнением, оценивается только на независимых реальных дефектах, в сравнении с тем же классификатором, обученным традиционным дополнением.
Синтетические данные принимаются только если реальное воспоминание улучшается без увеличения ложных отклонений или ошибок в подгруппах. Настройки генерации и происхождение остаются привязанными к каждому изображению, а синтетические файлы никогда не попадают в тестовый набор или архив доказательств как реальные инспекции. Операторы не могут использовать генератор для подделки аудиторских записей. Команда сравнивает диффузионные альтернативы и стоимость сбора большего количества реальных примеров, признавая, что реалистичный внешний вид не доказывает, что GAN захватил физический процесс отказа.
Доказательства реализации и готовность к эксплуатации
Производственное решение требует больше, чем успешная демонстрация. Определите целевых пользователей, рабочую среду, входы, выходы, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базу и версионированный набор оценки до настройки. Тестируйте обычные случаи, граничные условия, некорректный или отсутствующий ввод, сдвиг распределения, отказ зависимостей, злоупотребления и группы или среды, которые могут быть недостаточно обслужены. Измеряйте качество задачи совместно с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и различить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный разворот, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно введёнными сбоями. Оперативная телеметрия должна раскрывать качество входов, поведение вывода, версию модели или правила, состояние зависимостей, вмешательства человека и подтверждённые результаты без сбора ненужных конфиденциальных данных. Определите пороги тревоги и ответственного, затем после развертывания проверяйте реальные доказательства вместо предположения, что офлайн‑производительность сохранится. Переоценивайте при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также требует документированных процедур восстановления, обучения на инцидентах, удаления и хранения, а также чёткой точки, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Понимает ли GAN изображения, которые он создает?
GAN изучает статистическую структуру, полезную для генерации. Это само по себе не подтверждает наличие человеческого семантического или причинно‑следственного понимания.
Безопасно ли использовать сгенерированные GAN образцы в качестве обучающих данных?
Только после проверки охвата, корректности меток, запоминания, предвзятости и того, помогает ли синтетическое распределение на реальном отложенном тестовом наборе.
Основные ссылки












