
Основы ИИ
Что такое генеративный ИИ?

 Добавьте Unite.AI в избранные источники в Google
Генеративный ИИ — это модели, которые изучают закономерности в данных и создают новый текст, изображения, аудио, видео, код или другие представления, когда им задаются инструкции или примеры. Вывод синтезируется на основе вероятностной модели; он не извлекается целиком из базы данных, хотя инструменты поиска могут предоставлять внешние доказательства.
Разные семейства моделей генерируют по‑разному. Авторегрессионные трансформеры предсказывают последовательность токен за токеном, диффузионные модели итеративно удаляют шум из образца, а генеративные состязательные сети обучаются через конкуренцию генератора и дискриминатора.
Ключевые выводы
- Генерация — это условная выборка из изученного распределения, а не гарантированное воспроизведение фактов.
- Трансформеры, диффузионные модели, GAN и вариационные автокодировщики делают разные компромиссы.
- Поиск и инструменты могут обеспечивать основу системы, но их выводы и разрешения всё равно требуют проверки.
- Управление рисками охватывает данные, модель, интерфейс, развертывание, мониторинг и происхождение контента.
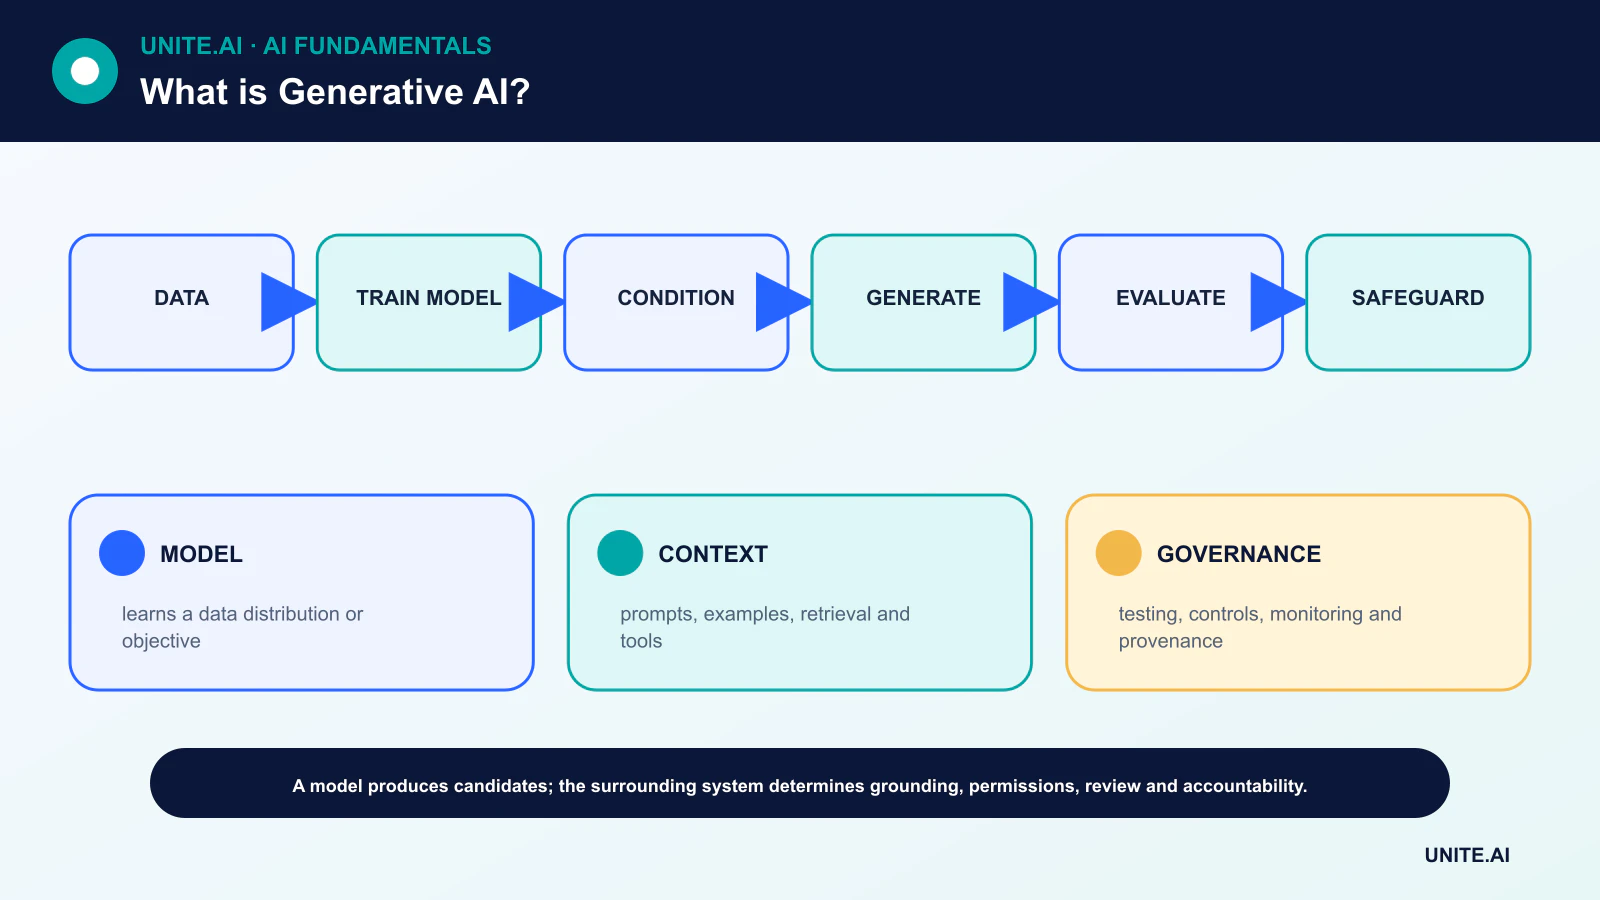
Как обучаются генеративные модели
Цели обучения вознаграждают модель за предсказание или восстановление закономерностей в примерах. Языковая модель оценивает следующий токен; диффузионная модель обучается обратному процессу шумоподавления; вариационный автокодировщик изучает структурированное скрытое распределение и декодер.
Такое обучение обеспечивает статистическую обобщаемость, но также может воспроизводить предвзятости, запоминать редкие последовательности или давать сбои за пределами распределения данных. Поэтому перед развертыванием важны документация набора данных, удаление дубликатов, контроль конфиденциальности и оценка на отложенных данных.
Основные семейства архитектур
Авторегрессионные трансформеры доминируют в тексте и поддерживают мультимодальные последовательности. Диффузионные модели широко применяются для генерации изображений и аудио высокого качества. GAN могут создавать чёткие образцы и управляемые системы изображений, но их обучение может быть сложным.
Вариационные автокодировщики предоставляют моделирование скрытых переменных и эффективные представления, иногда используются внутри более крупных генеративных конвейеров. Реальные продукты часто комбинируют несколько моделей с поиском, фильтрами, инструментами и детерминированным кодом.
Условие, выборка и контроль
Подсказка, метка класса, изображение, аудиоклип или структурированная запись могут задавать условие генерации. Параметры выборки меняют разнообразие и детерминизм. Более низкая температура может сосредоточить вероятности токенов, но она не делает неверный ответ истинным.
Контроль улучшается, когда система использует явные схемы, ограниченное декодирование, справочные материалы и проверку. Промпт-инжиниринг меняет контекст; дообучение меняет параметры; поиск предоставляет внешнюю информацию. Каждый из подходов решает отдельный тип сбоя.
Оценка зависит от применения
Текстовым системам может потребоваться проверка фактичности, завершение задачи, поддержка цитирования, тесты на токсичность и калибровку. Системам изображений или аудио может потребоваться достоверность, семантическое согласование, разнообразие, безопасность идентичности и перцептивный обзор. Сочетайте автоматические метрики с репрезентативной оценкой людьми.
Создайте версионный набор для оценки, включающий обычные, редкие, атакующие и связанные с политикой случаи. Отслеживайте задержку, стоимость и поведение отказов, а также качество вывода. Демонстрация, выбранная её создателем, не является доказательством надёжности на уровне всей популяции.
Риски, меры защиты и происхождение
Важные риски включают галлюцинации, внедрение подсказок, вредоносный контент, выдавание себя за другого, небезопасное использование инструментов, утечки конфиденциальности, споры о копирайте, предвзятость автоматизации и непрозрачные цепочки поставок. Профиль генеративного ИИ от NIST структурирует действия в рамках управления, происхождения контента, тестирования перед развертыванием и раскрытия инцидентов.
Применяйте инструменты с минимальными привилегиями, контроль ввода/вывода, человеческую проверку для значимых решений, журналирование, откат и пользовательскую отчётность. Водяные знаки или метаданные контента могут добавлять сигналы, но ни один детектор или метка не гарантируют истинность. Более широкий процесс synthetic-media должен сохранять контекст и подотчётность.
Семейства моделей и механизмы генерации
Модели генеративного ИИ оценивают или изучают процесс, способный создавать новый текст, изображения, аудио, видео, код или структурированные данные. Авторегрессионные модели предсказывают следующий токен или элемент; диффузионные модели обучаются обратному процессу шумоподавления; вариационные автокодировщики изучают вероятностные скрытые переменные; GAN обучают генератор против дискриминатора. Мультимодальные системы связывают представления между различными типами медиа. Вывод выбирается из изученной статистической структуры, условно от подсказок, контекста, инструментов или других входных данных — он не извлекается как гарантированный факт.
Базовые модели предварительно обучаются на широких данных и адаптируются с помощью подсказок, поиска, дообучения, оптимизации предпочтений, управляющих сетей или специализированных головок. Токенизаторы, энкодеры, декодеры, скрытые пространства и настройки выборки формируют результаты. Температура и фильтрация кандидатов балансируют детерминизм и разнообразие. Длинные подсказки предоставляют контекст, но могут конфликтовать, отвлекать или содержать вредоносные инструкции. Поиск может обеспечивать актуальность знаний, тогда как детерминированный код должен обрабатывать точные вычисления и правила.
Оценка, происхождение и права
Оценка по задачам: фактическая точность и наличие цитат для ответов, исполнение и безопасность для кода, достоверность и разнообразие для медиа, а также человеческий результат для творческой помощи. Включайте тесты отказов, калибровку, задержку, стоимость, языки, доступность и атакующие сценарии. Плавный или фотореалистичный вывод может быть неверным. Сохраняйте модель, подсказку, сид, исходные доказательства, вызовы инструментов и постобработку для воспроизводимости. Разделяйте качество поиска и генерацию, чтобы отшлифованный ответ не скрывал отсутствие доказательств.
Обучение и результаты поднимают вопросы авторского права, лицензий, согласия, конфиденциальности, публичности и секретности. Установите происхождение и разрешённое использование входных данных; не допускайте, чтобы пользователи раскрывали секреты; проверяйте запоминание; предоставляйте процессы отчётности и удаления. Синтетические медиа должны иметь надёжное происхождение или раскрытие, где это возможно, особенно если их могут принять за доказательства. Не используйте образ, голос или стиль способами, нарушающими права или вводящими в заблуждение.
Контроль развертывания
Считайте вывод модели недоверенным вводом. Проверяйте схемы, очищайте код и файлы, изолируйте исполнение, внешне авторизуйте каждый инструмент, ограничивайте стоимость и частоту, и требуйте подтверждения для значимых действий. Мониторьте сбои, злоупотребления, дрейф и пользовательские исправления, используя откат и резервный негенеративный вариант. Документируйте предполагаемое и запрещённое использование. Генеративный ИИ расширяет интерфейс для создания и трансформации информации, но надёжность и подотчётность зависят от окружающих данных, оценки, безопасности, происхождения и человеческого процесса принятия решений.
Практический пример: генеративный помощник по описанию продуктов
Ритейлер позволяет редакторам генерировать черновики описаний только на основе утверждённых атрибутов продукта и рекомендаций бренда. Подсказка содержит структурированные факты, а поиск предоставляет актуальную политику. Вывод должен соответствовать схеме и проверяется по исходным значениям; неподдерживаемые параметры, заявления о безопасности или сертификаты вызывают отклонение. Оценка охватывает фактическую точность, стиль, дублирование, многоязычное качество, доступность, задержку и исправления редактора, сравнивая с шаблонами и ручным написанием.
Редакторы одобряют каждую публикацию и могут видеть исходные поля. Модель не может изменять цену, запасы или публиковать напрямую. Подсказки и данные о продукте защищены от внедрения, а конфиденциальные заметки поставщиков исключены. Мониторинг отслеживает неподдерживаемые утверждения, правки, жалобы, стоимость и версии поставщика. Сгенерированный текст сохраняется с указанием происхождения. Система экономит время подготовки только если исправления и проверка не устраняют выгоду, а правдивость продукта остаётся управляемой авторитетными данными.
Доказательства внедрения и готовность к эксплуатации
Решение о внедрении требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочую среду, входные и выходные данные, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базовую линию и версионный набор для оценки перед настройкой. Тестируйте обычные случаи, граничные условия, некорректный или отсутствующий ввод, сдвиг распределения, отключения зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный выпуск, сохраняйте безопасный резерв и проверяйте мониторинг с преднамеренно внедрёнными сбоями. Оперативная телеметрия должна показывать качество ввода, поведение вывода, версию модели или правила, состояние зависимостей, человеческие переопределения и подтверждённые результаты без сбора лишних конфиденциальных данных. Определите пороги оповещений и ответственного за реакцию, затем после развертывания проверяйте реальные доказательства, а не полагайтесь на предположение, что офлайн‑производительность сохранится. Переоценивайте при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также требует документированных процедур восстановления, обучения на инцидентах, удаления и хранения, а также чёткой точки, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Является ли генеративный ИИ тем же, что и крупная языковая модель?
Нет. Крупные языковые модели (LLM) — один из классов генеративных моделей. Генеративный ИИ также включает системы для изображений, аудио, видео и структурированных данных, построенные на различных архитектурах.
Копирует ли модель свои обучающие данные?
Обычно модель синтезирует на основе изученных закономерностей, но возможны запоминание и почти точное дублирование. Риски конфиденциальности и происхождения необходимо оценивать, а не полагать, что они отсутствуют.
Основные ссылки












