
Основы ИИ
Что такое Data Science?

 Добавьте Unite.AI в избранные источники в Google
Data science — это практика преобразования данных в обоснованные знания, прогнозы или решения. Она сочетает предметную экспертизу, статистику, вычисления, инженерию данных, визуализацию и коммуникацию. Модель может быть частью работы, но дисциплина начинается до моделирования и продолжается после внедрения.
Самый важный вопрос — не «Какой алгоритм нам следует использовать?», а «Какое решение мы поддерживаем, какие доказательства отвечают на него, и как мы будем знать, что результат остаётся полезным?»
Ключевые выводы
- Data science — это сквозной процесс работы с доказательствами, а не синоним машинного обучения.
- Определение задачи, измерения и управление данными часто определяют успех больше, чем сложность модели.
- Прогностические и причинные вопросы требуют разных предположений и схем оценки.
- Развернутый анализ требует мониторинга, документирования и коммуникации, соответствующей его пользователям.
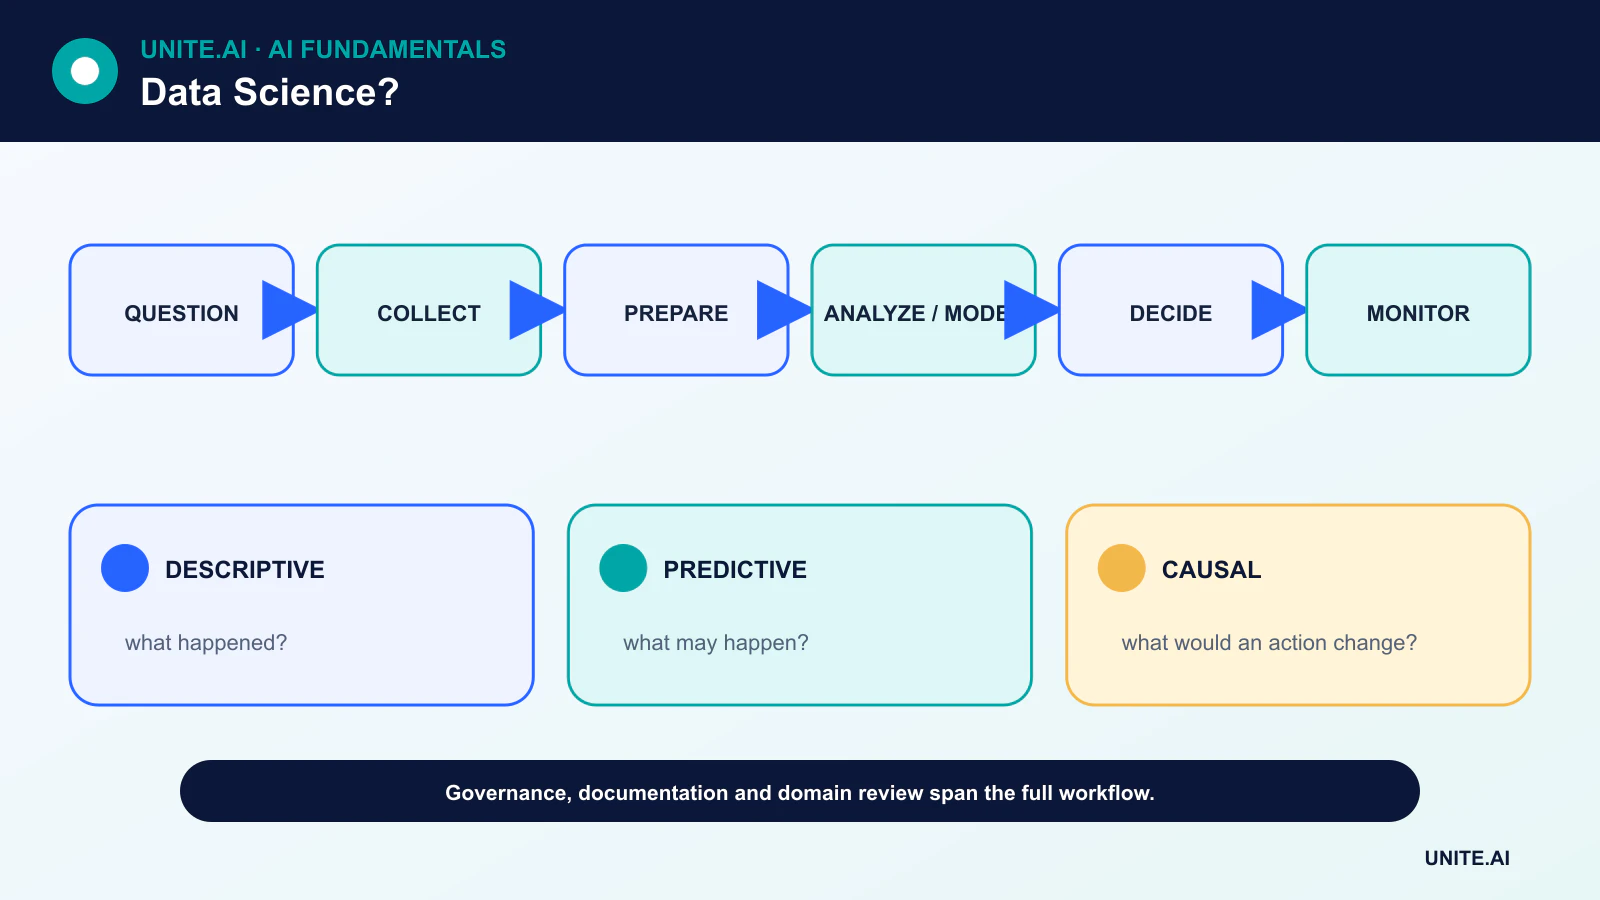
Начните с решения и оценочного параметра
Проект должен определить пользователя, решение, вмешательство и стоимость ошибки. Для описательного вопроса цель может быть показателем или тенденцией. Для прогноза — будущий спрос или риск. Для причинного вопроса оценочный параметр описывает эффект заданного вмешательства при указанных предположениях.
Неясные цели, такие как «найти инсайты», делают оценку невозможной. Измеримая цель создает границу для сбора данных и препятствует расширению анализа на все доступные поля.
Сбор, управление и понимание данных
Команды составляют инвентарь источников, прав собственности, согласий, сроков хранения, происхождения и доступа. Они различают структурированные и неструктурированные данные, определяют единицы измерения и метки времени, а также проверяют, представляют ли записи интересующую популяцию и период.
Очистка — это не только удаление строк с пропусками. Она включает устранение дубликатов, невозможных значений, неоднозначности меток, дрейфа схемы, цензурирования и соединений, меняющих единицу анализа. Каждое преобразование должно быть воспроизводимым и документированным.
Исследуйте перед моделированием
Исследовательский анализ изучает распределения, пропуски, взаимосвязи и потенциальные артефакты измерений. Визуализация может выявлять выбросы и различия в подгруппах, которые скрыты в среднем значении. Исследование должно формировать гипотезы, не будучи принятым за подтверждающие доказательства.
Инженерия признаков, снижение размерности и обучение представлениям могут улучшить моделирование, но преобразования должны подгоняться только на обучающих данных, чтобы предотвратить утечку.
Выберите методы в соответствии с вопросом
Статистическая оценка количественно определяет неопределённость вокруг интересующих величин. Машинное обучение полезно, когда основной целью является прогностическая эффективность на новых данных. Эксперименты и методы причинного вывода требуются, когда цель — оценить эффект вмешательства.
Базовая модель должна быть достаточно простой для понимания. Более сложные модели должны оправдывать дополнительную стоимость за счёт лучшей производительности на отложенных данных, откалиброванной неопределённости, операционной ценности или необходимой возможности, такой как обработка изображений или языка.
Оценка, коммуникация и мониторинг
Оценка должна соответствовать решению. Классификатор может требовать точность, полноту, калибровку и анализ подгрупп, а не только точность; система прогнозирования нуждается во временно‑ориентированном тестировании. Переобучение и утечка — это сбои процесса, а не только свойства модели.
Коммуникация включает предположения, неопределённость, ограничения и рекомендуемые действия. Как только модель или панель используется, команды мониторят качество входных данных, дрейф результатов, поведение пользователей и последующее влияние. Выведенный из эксплуатации процесс принятия решений требует архива и чёткой ответственности, так же как развернутый нуждается в операторе.
Жизненный цикл Data Science и аналитические вопросы
Data science сочетает предметные знания, статистику, вычисления и коммуникацию, чтобы преобразовать данные в доказательства для принятия решений. Начните с различения описания, диагностики, прогноза и причинного вывода. Панель, отображающая произошедшее, модель, предсказывающая отток клиентов, и эксперимент, оценивающий, меняет ли вмешательство отток, отвечают на разные вопросы. Определите единицу, популяцию, временное окно, результат, действие и стоимость ошибок до извлечения данных. Многие неудачные проекты решают измеримый прокси, который не может поддержать задуманное решение.
Сбор требует происхождения, разрешений, дизайна выборки и договора о данных. Исследование проверяет распределения, пропуски, дубли, выбросы, взаимосвязи, изменения измерений и потенциальную утечку. Выборы при очистке являются аналитическими предположениями: удаление строк с пропусками, имputation значений или ограничение выбросов могут изменить популяцию и выводы. Фиксируйте необработанные данные неизменяемо и преобразования как код, создайте словарь данных с единицами и смыслом. Разделите данные для оценки до обучения преобразований или многократного тестирования гипотез.
Моделирование, вывод и воспроизводимость
Статистический вывод количественно определяет неопределённость при заданных предположениях; прогностическое моделирование оценивает производительность на новых данных; причинный анализ требует идентификации через дизайн или обоснованные предположения. Выбирайте методы, соответствующие вопросу и процессу генерации данных. Сравнивайте с простыми базовыми моделями, используйте группированную или временно‑ориентированную валидацию и сообщайте об неопределённости и чувствительности. Высокая корреляция или важность признаков не устанавливают причинность. Множественное тестирование, свобода исследователя и селективная публикация могут создавать убедительные паттерны, поэтому предрегистрация или чётко отделённый подтверждающий этап могут помочь.
Воспроизводимость включает код, окружение, снимок данных, случайные зерна, определения запросов и запись ручных решений. Автоматические тесты должны покрывать схемы, бизнес‑инварианты, преобразования и метрики. Блокноты полезны для исследования, но производственная работа требует модульных, проверяемых конвейеров. Пир-ревью должно ставить под вопрос предположения, утечки, валидность цели и обобщаемость результатов. Коммуницируйте размеры эффектов, неопределённость, ограничения и контрдоказательства, а не только статистическую значимость или оценку модели.
Развёртывание и влияние на решение
Если анализ управляет повторяющимся процессом, назначьте ответственных, контролируйте актуальность данных и качество результатов, а также определите откат или вывод из эксплуатации. Защищайте персональную и конфиденциальную информацию посредством минимизации, контроля доступа, сроков хранения и безопасных выводов. Оценивайте эффекты на подгруппы и реакцию пользователей на модель; обратные связи могут менять будущие данные. Измеряйте, улучшило ли решение реальную цель, а не только то, что модель была развернута. Data science считается успешной, когда доказательства надёжно и прозрачно меняют действия — а не когда организация накапливает панели, функции или эксперименты без ответственности.
Практический пример: измерение вмешательства по удержанию
Команда продукта замечает снижение удержания и определяет активного пользователя, когорту, окно, исключения и решение. Аналитики проверяют инструментарий, пропущенные события и состав привлечения перед моделированием. Описательные когорты выявляют, где происходит спад, прогностическая модель приоритизирует участников исследования, а рандомизированный эксперимент при онбординге оценивает, улучшит ли предложенное изменение удержание. Это три отдельные аналитики с разными предположениями и результатами.
Блокнот, запросы, снимок данных, определение метрики и план эксперимента находятся в версиях и проходят пир‑ревью. Результаты сообщают размер эффекта и неопределённость с ограничениями по спросу на поддержку и доступности. Панель мониторит эксперимент, но не заменяет заранее объявленный анализ. Если вмешательство успешно, развертывание остаётся поэтапным и проверяет долгосрочное поведение. Работа считается ценной только если она поддерживает воспроизводимое решение, а не потому, что был создан сложный модель или визуально привлекательный график.
Доказательства внедрения и готовность к эксплуатации
Производственное решение требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочее окружение, входы, выходы, зависимости, владельца и последствия каждой важной ошибки. Установите воспроизводимую базовую линию и версионированный набор данных для оценки до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входные данные, сдвиг распределения, отказ зависимостей, неправильное использование и группы или окружения, наиболее подверженные недостаточному обслуживанию. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развёртывание, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно введёнными сбоями. Операционная телеметрия должна показывать качество входных данных, поведение вывода, версию модели или правила, состояние зависимостей, человеческие вмешательства и подтверждённые результаты без сбора ненужных конфиденциальных данных. Определите пороги оповещений и ответственного за реакцию, затем проверяйте реальные доказательства после внедрения, а не полагайтесь на сохранение офлайн‑производительности. Переоценивайте при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также требует документированных процедур восстановления, обучения на инцидентах, удаления и хранения, а также чёткой точки, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Является ли Data Science тем же, что и Data Analytics?
Термины перекрываются. Data science часто включает создание дата‑продуктов и предиктивных систем, тогда как аналитика может больше сосредотачиваться на описательной и диагностической поддержке решений. Применение в организациях различается.
Нужен ли ИИ в каждом проекте Data Science?
Нет. Хорошо спроектированный запрос, диаграмма, эксперимент или статистическая оценка могут быть более полезными и надёжными, чем сложная модель.
Основные ссылки











