
Основы ИИ
Что такое автокодировщик?

 Добавьте Unite.AI в избранные источники в Google
Автокодировщик — это нейронная сеть, обученная восстанавливать свой вход. Энкодер преобразует вход в скрытое представление; декодер преобразует это представление обратно в восстановление. Обучение минимизирует ошибку восстановления, иногда с дополнительными ограничениями.
Точное копирование входных данных не автоматически полезно. Архитектура или цель должны создавать узкое место, добавлять шум, накладывать разреженность или иным образом препятствовать тривиальному отображению тождественности, чтобы скрытый код захватывал полезную структуру.
Ключевые выводы
- Энкодер сжимает или преобразует вход; декодер восстанавливает его из скрытого кода.
- Недостаточно полное узкое место, шум или регуляризация заставляют модель изучать структуру, а не просто копировать.
- Ошибка восстановления может использоваться для обнаружения аномалий, но аномалии не обязательно будут иметь большую ошибку.
- Вариационные автокодировщики обучают вероятностную скрытую модель и отличаются от детерминированных автокодировщиков.
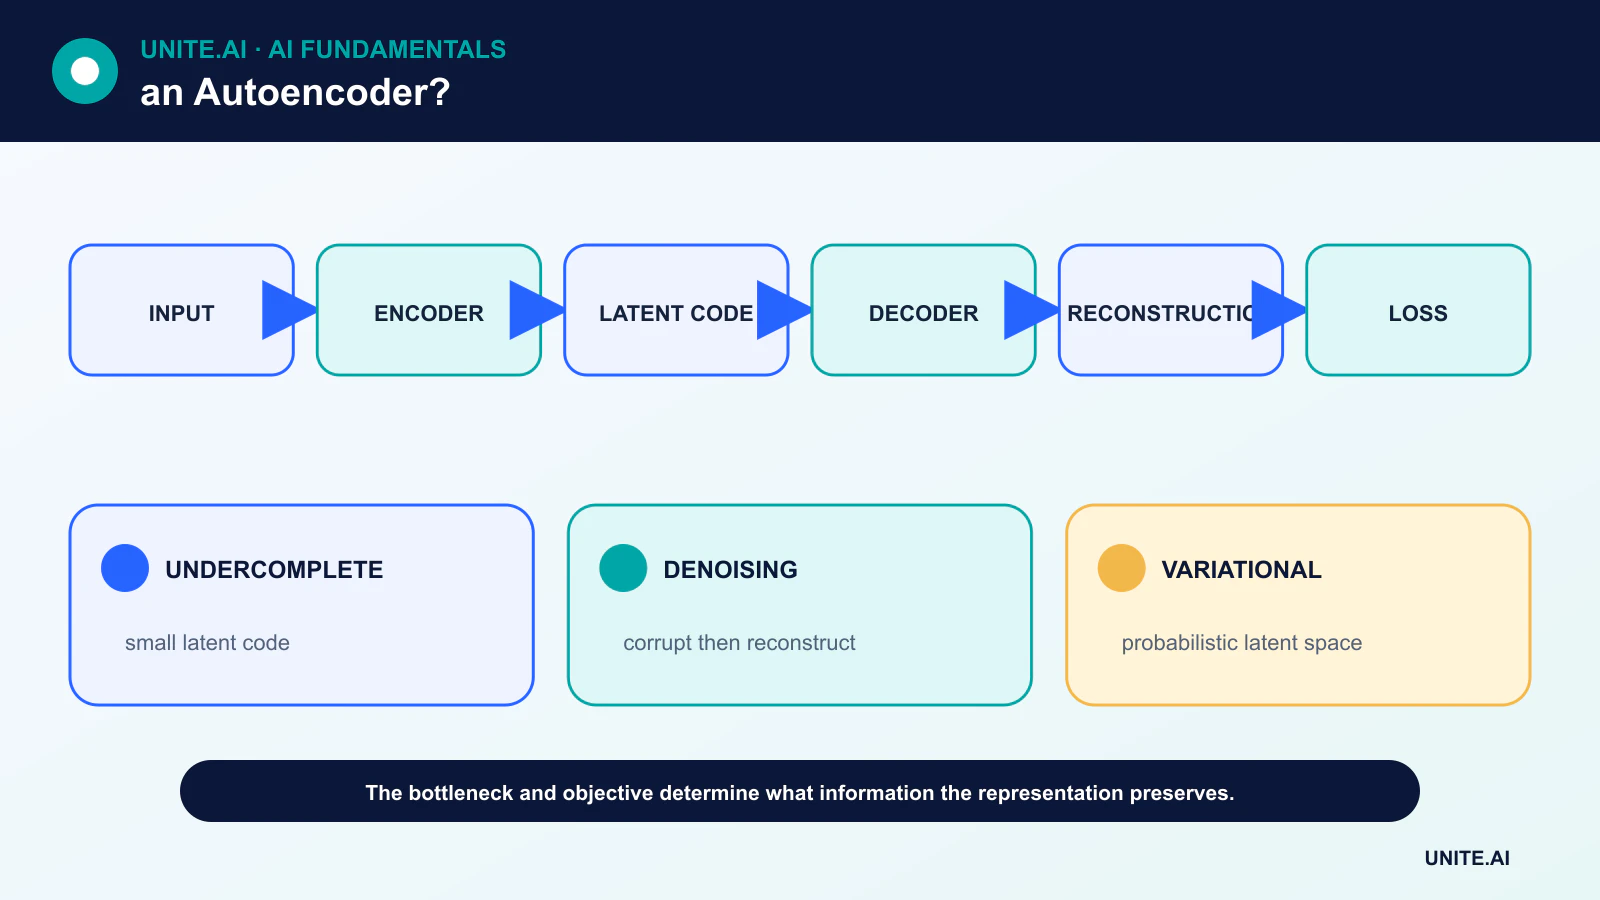
Энкодер, скрытое пространство и декодер
Для входа x энкодер генерирует скрытый код z = f(x), а декодер восстанавливает x̂ = g(z). Потеря сравнивает x и x̂, например, с помощью среднеквадратичной ошибки для непрерывных значений или правдоподобия, подходящего для данных.
Размерность скрытого пространства может быть меньше, чем у входа, создавая недокомплектный автокодировщик. Глубокая сеть также может изучать нелинейные представления, расширяя идею сокращения размерности.
Распространённые варианты автокодировщиков
Разреженный автокодировщик штрафует широкую активацию. Шумозащитный автокодировщик получает искажённый вход и восстанавливает чистую версию. Сократительный автокодировщик штрафует чувствительность кода к небольшим изменениям входа.
Вариационный автокодировщик (VAE) кодирует параметры вероятностного распределения, выбирает скрытое значение и балансирует восстановление с регуляризационным членом, формирующим скрытое пространство. Это поддерживает генерацию выборок, но меняет цель и интерпретацию.
Обучение и предотвращение тривиальных решений
Автокодировщики используют обратное распространение ошибки, как и другие нейронные сети. Сеть с чрезмерной ёмкостью может запоминать обучающие примеры или изучать почти тождественную функцию. Размер узкого места, искажение, штрафы и проверка на невидимых данных ограничивают её.
Выбор функции потерь имеет значение. Пиксельная потеря может давать размытые восстановления изображений, тогда как перцептивные потери наследуют предположения от другой сети. Лучший показатель восстановления не обязательно является лучшей мерой семантической схожести.
Применения и ограничения
Автокодировщики могут извлекать признаки, удалять шум из сигналов, сжимать данные, инициализировать модели и генерировать скрытые переменные для визуализации. Для обнаружения аномалий модель, обученная на нормальных данных, может присваивать более высокую ошибку восстановления необычным входам.
Этот подход может не сработать, когда автокодировщик также хорошо восстанавливает аномалии или когда безвредные вариации труднее восстановить, чем целевая аномалия. Пороги требуют размеченных или тщательно проверенных данных валидации, а ошибку следует отслеживать по подгруппам и условиям эксплуатации.
Автокодировщики против других генеративных моделей
Детерминированный автокодировщик не автоматически является вероятностной генеративной моделью. VAE определяют структурированное скрытое распределение; GAN обучают генератор в сопоставлении с дискриминатором; диффузионные модели изучают процесс удаления шума.
Выбор зависит от того, является ли цель восстановление, представление, правдоподобие, качество образцов, управляемость или оценка аномалий. Небольшая специализированная модель часто практичнее крупного генератора изображений.
Цели энкодера‑декодера и скрытые представления
Автокодировщик обучает энкодер, который отображает вход x в скрытый код z, и декодер, который восстанавливает x из z. Если ёмкость не ограничена, он может выучить тождественное отображение без полезной структуры. Узкие места, регуляризация, искажение, разреженность или архитектурные ограничения заставляют представление сохранять выбранную информацию. Функция потерь восстановления определяет, что считается похожим: среднеквадратичная ошибка предпочитает среднюю точность пикселей, тогда как перцептивные или специфичные для модальности потери подчеркивают разные признаки. Низкая ошибка не гарантирует семантического смысла.
Недокомплектные автокодировщики ограничивают размерность скрытого пространства. Шумозащитные автокодировщики восстанавливают чистые данные из искажённого входа. Разреженные варианты штрафуют активацию; сократительные варианты штрафуют чувствительность. Вариационные автокодировщики обучают вероятностное скрытое распределение, комбинируя восстановление с дивергенционным членом, что позволяет генерировать выборки, но меняет цель. Свёрточные, последовательные, графовые и трансформерные автокодировщики кодируют структуру модальности. Выбирайте размер скрытого пространства и регуляризацию через последующую валидацию, а не только по привлекательным двумерным графикам.
Обнаружение аномалий, сжатие и оценка
Для обнаружения аномалий обучайте модель на репрезентативных нормальных данных и оценивайте ошибку восстановления или правдоподобие скрытого кода, однако аномалии иногда могут восстанавливаться хорошо, а редкие нормальные случаи — плохо. Выбирайте пороги на размеченных или проверенных валидационных примерах, сообщайте о полноте на уровне событий и ложных тревог, а также тестируйте изменения в рабочем состоянии. Сравнивайте с простыми статистическими и одно‑классовыми базовыми методами. Для сжатия учитывайте полный кодек — включая размер модели, квантизацию, метаданные и вычисления декодера — и сравнивайте качество при одинаковом битрейте с установленными кодеками.
Качество представления можно оценивать с помощью линейных проб, стабильности кластеризации, поиска, восстановления и downstream‑задач, каждая из которых отвечает на свой вопрос. Избегайте утечки при обучении энкодера и выборе порогов. Проверяйте, какие признаки игнорируются функцией потерь и сохраняются ли чувствительные атрибуты в коде. Сжатый скрытый код не автоматически анонимизируется; обратное преобразование и вывод атрибутов могут восстановить личную информацию. Сгенерированные восстановления могут выглядеть правдоподобно, но изменять критические детали.
Развёртывание и мониторинг
Версионируйте энкодер и декодер совместно, проверяйте численные изменения после экспорта и сохраняйте масштабирование входа. Отслеживайте распределение ошибок восстановления, дрейф скрытого кода, сигналы пороговых тревог и подтверждённые результаты. В промышленном мониторинге адаптируйте модель к режиму работы, чтобы нормальные переходы не воспринимались как неисправности. Для медицинского или научного восстановления никогда не представляйте сгенерированный элемент как измеренное доказательство без валидации и происхождения. Автокодировщики — гибкие обучающие представления, но ограничения и функция потерь, а не название архитектуры, определяют, какая информация сохраняется, отбрасывается или создаётся.
Практический пример: автокодировщик для аномалий насосов
Недокомплектный автокодировщик изучает окна вибраций на основе проверенной работы здоровых насосов при разных нагрузках и температурах. Он сравнивается со статистическими порогами и одно‑классовыми методами, а порог восстановления выбирается на основе проверенных нормальных переходов и известных неисправностей. Оценка использует полноту событий, время предупреждения, количество ложных тревог на час работы и результаты по каждому насосу, а не случайные окна, где соседние образцы попадают в обучающую и тестовую выборки.
Производственная модель учитывает состояние эксплуатации и показывает остаточные паттерны инженерам. Высокая ошибка требует проверки; она не диагностирует деталь и не останавливает насос автоматически. Отключение датчика, обрезка сигнала и неизвестные нагрузки создают явно недопустимые состояния. Мониторинг отслеживает распределение ошибок восстановления, подтверждение тревог и состояние датчиков. Когда обслуживание или изменение оборудования меняет базовый уровень, старая модель остаётся доступной, пока кандидат обучается на проверенных данных и тестируется на исторических инцидентах.
Доказательства реализации и готовность к эксплуатации
Решение о внедрении требует большего, чем успешная демонстрация. Определите целевых пользователей, эксплуатационную среду, входные и выходные данные, зависимости, владельца и последствия каждой важной ошибки. Установите воспроизводимую базовую линию и версионированный набор для оценки до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входные данные, сдвиг распределения, отказ зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Оценивайте качество задачи совместно с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развёрт, сохраняйте безопасный резерв и проверяйте мониторинг с преднамеренно введёнными сбоями. Оперативная телеметрия должна показывать качество входных данных, поведение выхода, версию модели или правила, состояние зависимостей, вмешательства людей и подтверждённые результаты без сбора лишних конфиденциальных данных. Определите пороги тревог и ответственного за реакцию, затем проверяйте реальные доказательства после развёртывания, а не полагайтесь на сохранение офлайн‑производительности. Переоценивайте систему при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также требует документированных процедур восстановления, обучения на инцидентах, удаления и хранения данных, а также чёткой точки, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Являются ли автокодировщики без потерь?
Обычно нет. Они, как правило, обучаются создавать сжатые представления, зависящие от задачи и распределения, и требуют обученного декодера для восстановления данных.
Является ли каждое узкое место интерпретируемым?
Нет. Компактный код может быть полезным, даже если каждая его размерность не соответствует понятному человеку концепту.
Основные ссылки












