
Основы ИИ
Что такое обратное распространение ошибки?

 Добавьте Unite.AI в избранные источники в Google
Обратное распространение ошибки — это алгоритм, используемый для вычисления того, как меняется функция потерь нейронной сети относительно её обучаемых параметров. Он применяет правило цепочки в обратном направлении к операциям, записанным во время прямого прохода.
Обратное распространение вычисляет градиенты; оно само по себе не решает, как обновлять параметры. Оптимизатор, такой как стохастический градиентный спуск или AdamW, использует эти градиенты для изменения весов, смещений и других обучаемых параметров.
Ключевые выводы
- Прямой проход формирует промежуточные значения и генерирует предсказание.
- Функция потерь преобразует предсказание и целевое значение в скалярную цель обучения.
- Обратное распространение использует локальные производные и правило цепочки для эффективного вычисления градиентов параметров.
- Современные фреймворки реализуют обратный режим автоматического дифференцирования над вычислительным графом.
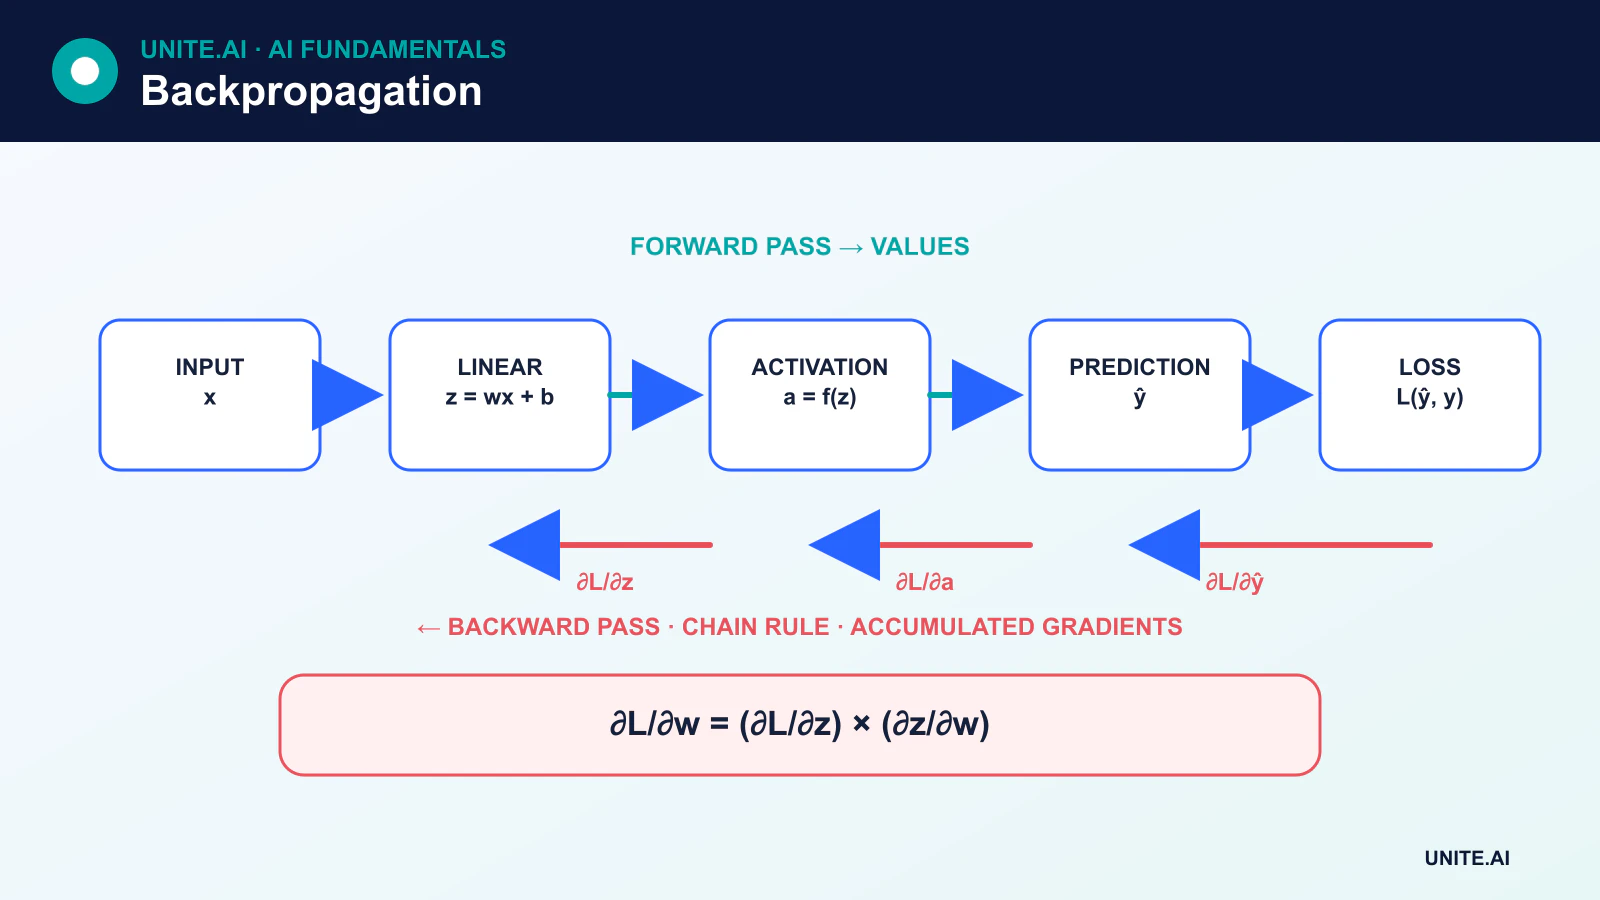
Прямой проход
Рассмотрим простой элемент:
z = wx + bŷ = activation(z)
Входом является x, а w и b — обучаемые параметры веса и смещения. Смещения обычно изменяются во время обучения так же, как и веса. Сеть комбинирует множество подобных операций, а также нормализацию, внимание, свёртки, остаточные соединения и другие дифференцируемые блоки.
Прямой проход вычисляет эти операции и выдаёт предсказание. Функция потерь, например кросс‑энтропия или среднеквадратичная ошибка, измеряет цель. Наилучшая функция потерь зависит от задачи и интерпретации выхода.
Правило цепочки
Если функция потерь L зависит от промежуточного значения z, а z зависит от параметра w, правило цепочки даёт:
∂L/∂w = (∂L/∂z) × (∂z/∂w)
Глубокая сеть содержит множество путей. Обратное распространение проходит по вычислительному графу в обратном порядке, аккумулируя вклады, когда значение влияет на функцию потерь через более чем один путь. В результате получается градиент для каждого обучаемого параметра, участвующего в прямом вычислении.
Небольшой числовой пример
Предположим ŷ = wx + b, при x = 2, w = 3 и b = 1. Предсказание равно 7. Если целевое значение — 5, а функция потерь L = ½(ŷ - y)², тогда:
∂L/∂ŷ = ŷ - y = 2∂ŷ/∂w = x = 2∂L/∂w = 2 × 2 = 4∂L/∂b = 2 × 1 = 2
Оптимизатор может затем сместить w и b в направлении отрицательного градиента. Эта формула специфична для выбранного линейного элемента и функции потерь со среднеквадратичной ошибкой; универсальное правило обратного распространения — это правило цепочки, применяемое к реальному графу, а не фиксированное «ошибочное» уравнение.
Обратное распространение vs градиентный спуск
Градиентный спуск — это метод оптимизации. Обратное распространение предоставляет необходимые градиенты. Один шаг обучения обычно выглядит так:
- Очистить или сбросить накопленные градиенты.
- Выполнить прямой проход.
- Вычислить функцию потерь.
- Выполнить обратный проход.
- Применить обновление оптимизатора.
Разделение этих концепций упрощает понимание импульса, AdamW, аккумуляции градиентов и обучения с переменной точностью.
Автоматическое дифференцирование
Фреймворки, такие как PyTorch, записывают операции и строят граф во время прямого прохода. Затем обратный режим автоматического дифференцирования эффективно вычисляет произведения вектор‑Якоби от выходов к параметрам. Это более общее решение, чем ручное кодирование производных для фиксированной сети, и лежит в основе современных фреймворков глубокого обучения.
Некоторые операции недифференцируемы или имеют нестабильные производные. Фреймворки определяют субградиенты или документированные соглашения в определённых случаях, но практикующим всё равно необходимо разбираться с отсоединёнными тензорами, операциями «на месте» и числовой точностью.
Исчезающие и взрывающиеся градиенты
Повторное умножение через множество слоёв или временных шагов может сделать градиенты чрезвычайно малыми или большими. Исчезающие градиенты замедляют обучение в ранних слоях; взрывающиеся градиенты дестабилизируют обновления. Активации семейства ReLU, тщательная инициализация, остаточные соединения, нормализация, затворные рекуррентные блоки и обрезка градиентов помогают, но ни один из методов не является универсальным решением.
Проверка градиентов
Проверка градиентов методом конечных разностей сравнивает аналитический или автоматический градиент с численным приближением. Этот метод медленен, но полезен для отладки пользовательских операций. Мониторинг норм градиентов и обнаружение NaN или бесконечных значений может выявить нестабильность во время обучения.
Правило цепочки в вычислительном графе
Обратное распространение эффективно вычисляет градиенты скалярной функции потерь по отношению к каждому дифференцируемому параметру. Прямой проход фиксирует промежуточные значения в вычислительном графе. Начиная с функции потерь, обратный режим автоматического дифференцирования применяет правило цепочки, умножая локальные производные и аккумулируя вклады там, где пути пересекаются. Для слоя y=f(x,w) чувствительность к y комбинируется с частными производными, образуя чувствительности для x и w. Обратное распространение считает градиенты; оптимизатор решает, как изменятся параметры.
Простой аффинный слой выдаёт y=Wx+b. Градиент по W — это внешнее произведение градиента сверху и входа, градиент по b — сумма верхних значений, а градиент по входу умножается на транспонированную матрицу весов. Активации добавляют покомпонентные производные. Свёртка, нормализация, внимание и рекуррентные блоки используют тот же принцип графа, но требуют корректных форм тензоров, трансляции, маскирования и совместного использования параметров. Фреймворки освобождают сохранённые активации после обратного прохода, если они не удерживаются, поэтому память часто растёт с размером батча, глубиной и длиной последовательности.
Сбои градиентов, верификация и инженерная практика
Произведения множества производных могут исчезать или взрываться. Активации типа ReLU, тщательная инициализация, нормализация, остаточные соединения, затворы и обрезка градиентов решают разные механизмы. Перенасыщенные активации и недифференцируемые операции могут блокировать полезные сигналы; усечённое обратное распространение ограничивает историю последовательности; переменная точность может привести к недополнению без масштабирования потерь. Взрывающиеся градиенты — симптом, поэтому обрезка должна сопровождаться исследованием скорости обучения, данных, архитектуры и числовых ошибок, а не скрывать их.
Проверяйте пользовательские операции с помощью проверок градиентов методом конечных разностей на небольших двойных точных входах, избегая недифференцируемых точек. Анализируйте нормы градиентов, NaN, неактивные параметры и то, достигают ли градиенты ожидаемых модулей. Преднамеренно очищайте накопленные градиенты и различайте поведение обучения и оценки для dropout и нормализации. Контрольные точки пере‑вычисляют активации для экономии памяти; распределённое обучение должно согласованно агрегировать градиенты. Уменьшающаяся функция потерь лишь показывает, что существует путь оптимизации, а не то, что градиенты концептуально корректны, данные без утечек или модель обобщается.
Практический пример: проверка пользовательского нейронного слоя
Инженер реализует дифференцируемый спектральный слой для аудиосети. Маленький тест двойной точности сравнивает автоматические градиенты с центральными конечными разностями по входам и параметрам, исключая точки, где операция намеренно недифференцируема. Формы, трансляция, заполнение и преобразование комплекс‑в‑вещественное обрабатываются отдельными случаями. Тест проверяет накопленные градиенты, когда параметр переиспользуется, и подтверждает, что маскированные аудиофреймы не дают градиента.
Во время обучения панели мониторинга отслеживают нормы градиентов и активаций, NaN, неактивные параметры и масштабирование потерь. Специально испорченный батч подтверждает, что валидация ловит нечисловой вывод до обновления оптимизатора. Переменная точность и экспортированные реализации сравниваются с эталоном. Тесты возобновления контрольных точек включают состояние оптимизатора и случайный порядок. Слой не принимается только потому, что общая потеря снижается; единичные градиенты, численная стабильность и последующая обобщаемость должны предоставить согласованные доказательства.
Доказательства реализации и готовность к эксплуатации
Производственное решение требует больше, чем успешную демонстрацию. Определите целевых пользователей, рабочую среду, входы, выходы, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базовую линию и версионированный набор оценок до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входы, сдвиги распределения, отключения зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Измеряйте качество задачи совместно с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развёртывание, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно введёнными сбоями. Операционная телеметрия должна показывать качество входов, поведение выходов, версию модели или правила, состояние зависимостей, человеческие вмешательства и подтверждённые результаты без сбора лишних конфиденциальных данных. Определите пороги оповещений и ответственного, затем после развертывания проверяйте реальные доказательства, а не полагайтесь на офлайн‑показатели. Переоценивайте систему при изменении источников данных, пользователей, моделей, поставщиков, политик, аппаратного обеспечения или целей. Поддерживаемая система также нуждается в документированном восстановлении, обучении на инцидентах, процедурах удаления и хранения, а также в чётком моменте, когда её следует отключить или заменить.
Часто задаваемые вопросы
Обновляет ли обратное распространение веса?
Обратное распространение вычисляет градиенты. Оптимизатор применяет обновление, используя эти градиенты, свою скорость обучения и, возможно, состояние, такое как импульс или адаптивные моменты.
Является ли обратное распространение биологически реалистичным?
Стандартное обратное распространение — инженерный алгоритм и не считается детальной моделью обучения в биологических мозгах. Историческая нейронная аналогия не должна восприниматься как биологический эквивалент.
Основные ссылки












