
Основы ИИ
Что такое компьютерное зрение?

 Добавьте Unite.AI в избранные источники в Google
Computer vision — это область создания систем, извлекающих полезную информацию из изображений и видео. Модель зрения может классифицировать всё изображение, определять объекты, размечать каждый пиксель, распознавать текст, оценивать позу, отслеживать движение или связывать визуальное содержимое с языком.
Современные системы зрения не просто воспроизводят ранний процесс обнаружения контуров, характерный для человеческого восприятия. Они обучают специфичные для задачи представления из данных, часто используя convolutional neural networks, vision transformers или многомодальные фундаментальные модели.
Основные выводы
- Классификация, детекция, сегментация, OCR, отслеживание и генерация — это отдельные задачи компьютерного зрения.
- CNN используют локальность и совместное использование весов; vision transformers применяют внимание к патчам изображения.
- Метки могут поступать от людей, слабого надзора, синтетических данных или самообучающих целей.
- Только точность недостатна: важны надёжность, задержка, конфиденциальность, предвзятость и стоимость отказов.
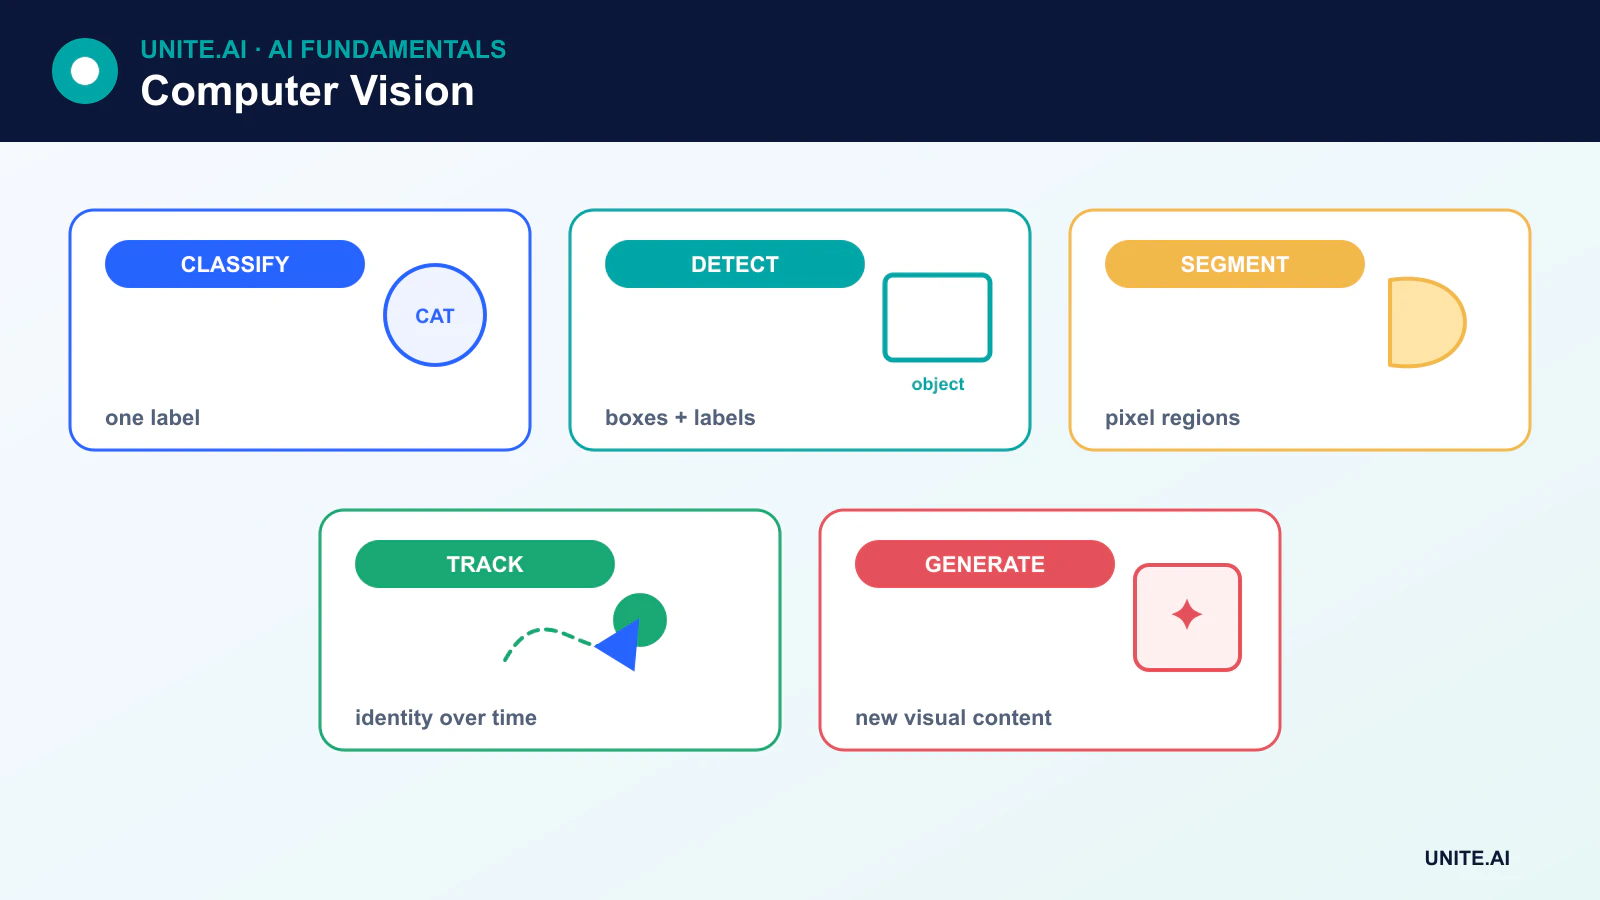
Основные задачи компьютерного зрения
- Image classification присваивает одному или нескольким изображениям метки. Смотрите как работает классификация изображений.
- Object detection предсказывает категории и ограничивающие рамки для нескольких объектов.
- Semantic segmentation размечает каждый пиксель по классу, а instance segmentation отделяет отдельные объекты.
- Optical character recognition (OCR) обнаруживает и транскрибирует текст.
- Pose estimation предсказывает ключевые точки тела или объекта.
- Tracking связывает обнаружения между кадрами видео.
- Image generation and editing создают или преобразуют визуальное содержимое, часто используя модели диффузии.
Как изображения становятся входными данными модели
Цифровое изображение уже является числовыми данными: тензором, содержащим значения пикселей по пространственным измерениям и каналам. Предобработка может изменять размер, нормализовать, обрезать или аугментировать изображение. Видео добавляет временное измерение, а медицинская и научная визуализация могут добавлять глубину, длину волны или другие модальности.
Классическое компьютерное зрение использовало вручную разработанные признаки краёв, углов и текстур. Современные глубокие модели обычно обучают признаки совместно с задачей, хотя классические методы остаются полезными, когда данных мало, правила хорошо понятны или вычислительные ресурсы ограничены.
CNN и обученные локальные признаки
CNN применяет обученные ядра к локальным окрестностям. Поначалу слои реагируют на локальные паттерны, а более поздние блоки объединяют их в представления, релевантные задаче. Операции pooling или с шагом уменьшают пространственное разрешение, а остаточные соединения упрощают оптимизацию глубоких сетей.
Современный классификатор на основе CNN часто использует глобальный pooling вместо большой последовательности полностью связанных слоёв. Детекторы и сети сегментации добавляют специализированные головы или декодирующие пути, сохраняющие пространственную информацию.
Vision transformers и фундаментальные модели
Vision transformer разбивает изображение на патчи, встраивает их и использует механизм внимания для моделирования их взаимосвязей. Transformers эффективно масштабируются при больших наборах данных и предобучении, тогда как CNN часто предоставляют более сильные встроенные предположения и эффективность на небольших масштабах.
Многомодальные модели выравнивают изображения с текстом, позволяя пользователям искать, создавать подписи, отвечать на вопросы или управлять сегментацией с помощью языка. Эти модели расширяют возможности, но также наследуют недостатки широких веб-данных, включая стереотипы, защищённый авторским правом материал и неравномерное покрытие популяций и окружений.
Метки, самосупервизия и синтетические данные
Создание ограничивающих рамок, масок, ключевых точек и подписей может быть дорогостоящим. Самосупервизионное обучение выводит цели из самих изображений, тогда как слабый надзор использует шумные или косвенные метки. Синтетические данные могут добавить редкие сценарии, но разрыв между симуляцией и реальностью может препятствовать переносу производительности синтетики в реальный мир.
Качество аннотаций необходимо измерять. Неоднозначные метки, несогласованные границы и отсутствие объектов ограничивают производительность и могут скрывать сбои в подгруппах.
Оценка систем зрения
Для классификации используют метрики такие как точность, полнота, F1 и калибровка. Для детекции обычно применяют Intersection over Union и среднюю точность (mean average precision). Сегментация использует IoU или метрики в стиле Dice. Отслеживание добавляет метрики идентичности и траекторий.
Метрика должна соответствовать условиям эксплуатации. Модель может показывать хорошие результаты на отобранных тестах, но терпеть неудачу в дождь, при плохом освещении, необычных углах камеры, новых устройствах или с незнакомыми популяциями. Оценка должна включать сдвиги распределения, атакующие условия и эксплуатационную задержку.
Конфиденциальность, предвзятость и развертывание
Лица, номера автомобилей, дома, медицинские сканы и видеозаписи с рабочего места могут раскрывать конфиденциальную информацию. Сбор и хранение должны соответствовать установленным правовым и этическим принципам, включать контроль доступа и минимизацию данных. Анализ лиц и биометрическая идентификация требуют особого внимания, поскольку ошибки и наблюдение могут наносить неравные вреды.
Развёртывание на периферии может снизить задержку и объём передаваемых данных. Edge AI, квантизация, обрезка и специализированные ускорители позволяют делать системы зрения практичными на камерах, транспортных средствах, роботах и мобильных устройствах, однако сжатие необходимо переоценивать с точки зрения точности и предвзятости.
От пикселей к визуальным задачам
Компьютерное зрение преобразует изображения или видео в выходы задач, такие как классификация, детекция, сегментация, отслеживание, поза, глубина, оптический поток или распознавание текста. Определение задачи определяет аннотацию: метка изображения не может обучать точную локализацию, а ограничивающая рамка не может полностью описать маску сегментации. Геометрия камеры, объективы, экспозиция, освещение, движение, сжатие и точка обзора формируют распределение данных. Необходимо определить рабочую среду и последствия ошибок перед выбором модели, поскольку набор изображений для бенчмарка может не представлять развернутый сенсор или сцену.
Конвейер декодирует и ориентирует медиа, изменяет их размер или разбивает на плитки, нормализует значения, применяет аугментацию, сохраняющую метки, запускает модель и постобрабатывает логиты, рамки, маски или траектории. Детекторы объектов используют пороги уверенности и подавление; трекеры связывают обнаружения во времени; сегментация может требовать морфологической очистки. Сохраняйте преобразования координат, чтобы выводы совпадали с оригинальным изображением. Делите данные по человеку, камере, местоположению или сеансу захвата, чтобы избежать почти идентичных кадров в обучающем и тестовом наборах.
Оценка, предвзятость, конфиденциальность и операции
Метрики должны соответствовать задаче и использованию. Для классификации нужны точность и полнота по классам; для детекции — intersection-over-union и средняя точность по порогам; для сегментации — IoU или Dice; для отслеживания — переключения идентичности; задержка и длительность пропущенных событий важны для видео. Отчитывайтесь о результатах по освещению, расстоянию, устройству, окклюзии, тону кожи, возрасту и другим релевантным условиям. Проверяйте калибровку и ошибки при высокой уверенности. Синтетические или аугментированные данные могут заполнять пробелы, но требуют сравнения с реальными данными развертывания и не должны раскрывать тестовые сцены.
Системы зрения могут собирать изображения прохожих, мест, биометрических данных и конфиденциального поведения. Минимизируйте захват и хранение, защищайте потоки, ограничивайте вторичное использование и предоставляйте уведомления или согласие, где это требуется. Тестируйте атакующие патчи, повторное воспроизведение, окклюзию, отказ камеры и сдвиг домена. Следите за состоянием сенсоров, статистикой входов, скоростью вывода и подтверждёнными результатами; сохраняйте человеческую проверку для важных решений. Размытие или обрезка могут уменьшить раскрытие, но также могут удалить доказательства. Высокий лабораторный балл не оправдывает утверждения о личности, эмоциях или намерениях за пределами проверенной задачи.
Практический пример: обнаружение пешеходов на перекрёстке склада
Камеры контролируют ограниченный проезд транспортных средств, и модель обнаруживает людей, а не идентифицирует их. Данные охватывают день и ночь, погоду, одежду, окклюзию, пользователей инвалидных колясок, позиции камер и пустые сцены, разделённые по сеансу записи. Детектор оценивается по полноте событий, ложным срабатываниям, локализации, времени предупреждения и производительности на расстоянии. Инженерия безопасности определяет максимальную допустимую задержку и независимые физические средства управления.
Оповещение системы зрения может замедлить транспортное средство, но аварийные остановки и барьеры не зависят от обученной модели. Обструкции камеры, зависшие кадры, потеря сети и тайм‑аут модели вызывают явные сбои. Хранение исходного видео минимизируется, а доступ регистрируется. Мониторинг отслеживает состояние сенсоров, частоту оповещений, проверенные инциденты и почти‑проигрыши по условиям. Любое перемещение камеры или изменение планировки вызывает повторную валидацию, поскольку внешняя схожесть изображений не гарантирует одинаковую геометрию или риск.
Доказательства внедрения и готовность к эксплуатации
Решение о внедрении в продакшн требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочую среду, входы, выходы, зависимости, владельца и последствия каждого важного отказа. Установите воспроизводимую базовую линию и версионированный набор оценок до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входы, сдвиги распределения, сбои зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Измеряйте качество задачи совместно с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развёртывание, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно введёнными сбоями. Оперативная телеметрия должна раскрывать качество входов, поведение выходов, версию модели или правила, состояние зависимостей, вмешательства человека и подтверждённые результаты без сбора ненужных конфиденциальных данных. Определите пороги оповещений и ответственного за реакцию, затем проверяйте реальные доказательства после развертывания, а не полагайтесь на сохранение офлайн‑показателей. Переоценивайте при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также требует документированных процедур восстановления, обучения на инцидентах, удаления и хранения, а также чёткой точки, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Является ли компьютерное зрение тем же, что распознавание изображений?
Нет. Распознавание изображений обычно относится к классификации или идентификации. Компьютерное зрение также включает локализацию, сегментацию, измерения, отслеживание, реконструкцию, генерацию и рассуждения над визуальной информацией.
Система зрения видит так же, как человек?
Нет. Модель обрабатывает числовые входы в соответствии со своей архитектурой и целью обучения. Она может превзойти людей в узком бенчмарке, но проваливаться при небольших изменениях, которые человек легко обрабатывает.
Основные ссылки












