
Основы ИИ
Что такое механистическая интерпретируемость? Как исследователи анализируют модели ИИ

 Добавьте Unite.AI в избранные источники в Google
Механистическая интерпретируемость изучает, как обученные компоненты внутри нейронной сети причинно вызывают поведение. Вместо того чтобы лишь сопоставлять входы и выходы, исследователи формируют гипотезы о признаках, головах внимания, нейронах и схемах, а затем вмешиваются, чтобы проверить эти гипотезы.
Область создала детальные объяснения для отдельных поведений в небольших и средних моделях, но полное, достоверное описание передовой модели пока недостижимо. Автоматические объяснения и привлекательные визуализации могут служить полезными отправными точками, но не являются доказательством.
Ключевые выводы
- Признаки — это представленные шаблоны; схемы — взаимодействующие компоненты, предлагаемые для реализации вычисления.
- Патчинг активаций, абляция и причинное трассирование проверяют, изменяет ли компонент поведение.
- Суперпозиция означает, что один нейрон может участвовать во множестве признаков; разреженные автокодировщики пытаются построить альтернативную базу признаков.
- Методы интерпретируемости нуждаются в истинных данных, фальсифицируемых тестах, охвате и оценке в сравнении с альтернативными объяснениями.
От представления к механизму
Проба (probing) задаёт вопрос, можно ли декодировать информацию из активации. Атрибуция оценивает, какие входы или компоненты важны. Механистическая работа идёт дальше, предлагая внутреннее вычисление и проверяя, изменяют ли вмешательства ожидаемое промежуточное и конечное поведение.
Это делает её связанной, но более узкой, чем объяснимый ИИ. Постхок объяснение одного решения не обязательно является обратным инженерным алгоритмом внутри модели.
Схемы и причинные вмешательства
Исследователи могут выявить голову внимания или признак, связанный с задачей, аблатировать её, патчить активации из другого прогона или проследить, как информация перемещается по слоям. Хорошая гипотеза предсказывает поведение на новых примерах и выдерживает контрольные проверки.
Вмешательства могут создавать состояния вне распределения, поэтому изменение поведения не автоматически раскрывает естественное вычисление. Используйте несколько методов, сопоставленные контролы и количественные эффекты, а не один иллюстративный запрос.
Суперпозиция и разреженные признаки
Нейронные сети могут представлять больше признаков, чем отдельных измерений, за счёт их наложения. Поэтому нейрон может активироваться для нескольких несвязанных шаблонов, делая метки на уровне нейронов вводящими в заблуждение.
Разреженные автокодировщики обучаются на более большом словаре признаков из активаций модели. Они могут делать шаблоны более различимыми, но выбранная разреженность, обучающие данные, ошибка восстановления и автоматические метки влияют на то, что восстанавливается. Признаки нейронных сетей всё ещё требуют причинной валидации.
Безопасность, отладка и ограничения
Механистические инструменты могут помочь обнаружить запомненные факты, предвзятость, вводящие в заблуждение стратегии или ошибочные схемы и могут поддерживать их редактирование или мониторинг. Те же инструменты могут упускать распределённые, редкие или контекстно‑зависимые вычисления.
Рассматривайте выводы как ограниченные доказательства: версия модели, задача, набор данных, слой, вмешательство, эффект и степень неопределённости. Связывайте интерпретацию с оценками поведения, ред‑тимингом и управлением ответственного ИИ, а не используйте её как универсальный сертификат безопасности.
Представления, схемы и причинные доказательства
Механистическая интерпретируемость изучает, как внутренние вычисления порождают поведение модели. Исследователи исследуют активации, веса, внимание и промежуточные признаки, затем формируют гипотезы о представлениях и схемах. Представление не обязательно хранится в одном нейроне; оно может быть распределено по направлениям, слоям, токенам и контекстно‑зависимым комбинациям.
Разреженные автокодировщики пытаются разложить плотные активации на более широкий набор признаков, которые активируются избирательно. Метки признаков — это человеческие интерпретации наблюдаемых примеров, а не истинные данные. Ошибка восстановления, разреженность, разделение признаков, поглощение и «мертвые» признаки влияют на то, что раскрывает разложение и что остаётся незамеченным.
Корреляция недостаточна для механистического утверждения. Патчинг активаций, абляция, причинное трассирование, управление и целенаправленные вмешательства в веса проверяют, изменяет ли компонент поведение в соответствии с предсказанием. Вмешательства также могут создавать состояния вне распределения, поэтому результаты требуют контролей, анализа доз‑ответа, альтернативных объяснений и репликации на разных запросах и моделях.
Строгий рабочий процесс интерпретируемости
Начните с точно измеренного поведения и набора данных, который отделяет конкурирующие гипотезы. Локализуйте релевантные слои, позиции, компоненты или признаки; изучите кандидатные механизмы; вмешайтесь и проверьте, предсказывает ли предложенная схема новые случаи. Держите исследовательские примеры отдельно от подтверждающей оценки, чтобы снизить смещение отбора.
Автоматизированные инструменты могут ранжировать нейроны, признаки, головы или пути, а языковые модели могут предлагать описания. Автоматизация увеличивает охват, но может создавать правдоподобные истории. Оценивайте объяснения по примерам активаций, отложенным от обучения, и причинным предсказаниям, фиксируйте степень неопределённости и делайте артефакты воспроизводимыми с указанием версии модели, токенизатора, запросов и кода.
Механизмы могут быть полисемантичными, избыточными, нелинейными и распределёнными. Удаление одного компонента может быть компенсировано другими, в то время как признак может участвовать в нескольких поведениях. Отрицательные результаты информативны: очевидная схема, не работающая вне отобранных примеров, должна быть уточнена или отвергнута, а не спасаться всё более расплывчатыми объяснениями.
Применения, ограничения и заявления о безопасности
Интерпретируемость может помочь отладить галлюцинации, предвзятость, запоминание, обходные поведения или неожиданную генерализацию; сравнивать модели; генерировать научные гипотезы. Она также может выявлять признаки для мониторинга или вмешательства. Такие применения требуют валидации под конкретную задачу, поскольку полезная исследовательская визуализация не автоматически является надёжным контролем в продакшене.
Отсутствие обнаруженного признака не доказывает отсутствие способности или намерения, а читаемый признак не доказывает, что модель использует его в конкретном ответе. Инструменты наблюдают проекцию вычислений с ограниченным охватом. Заявления о безопасности должны указывать чувствительность обнаружения, ложноположительные результаты, распределение, противника и известные слепые зоны.
Используйте интерпретируемость вместе с оценками поведения, ред‑тимингом, управлением данными, контролем доступа, мониторингом и реагированием на инциденты. Публикуйте методы и контрпримеры, когда это возможно. Область быстро развивается, но текущие техники не дают полного, достоверного объяснения рассуждений передовых моделей или общего гарантированного соответствия.
Практический пример: тестирование предложенной схемы модели
Предположим, модель использует набор голов внимания и признаков для разрешения косвенного дополнения в предложении. Исследователи определяют контролируемый набор данных с разнообразными именами, позициями, отвлекающими элементами и контрпримерами, затем измеряют поведение. Инспекция активаций выявляет кандидатные компоненты, но гипотеза формулируется до вмешательства: какую информацию несёт каждый компонент, куда она перемещается и как её изменение должно изменить вывод.
Патчинг активаций и абляция проверяют необходимость и достаточность на отложенных примерах. Целенаправленное изменение, которое меняет предсказанный токен в ожидаемом направлении, поддерживает механизм; широкие ухудшения производительности — нет. Контролы патчат несвязанные позиции и компоненты, варьируют величину вмешательства и сравнивают альтернативные схемы. Команда публикует отрицательные случаи, где объяснение не выдерживает, и избегает присваивать человеческо‑читаемую цель лишь на основе корреляции.
Чтобы заявить о применении в безопасности, метод должен обнаруживать соответствующее поведение с известной чувствительностью при реалистичных запросах и атакующей адаптации. Мониторы признаков оцениваются по ложноположительным срабатываниям, обходу, обновлениям модели и причинной релевантности. Доказательства интерпретируемости могут направлять отладку и дальнейшие тесты, но принудительное обеспечение остаётся во внешних контролях и мониторинге поведения. Убедительная схема схемы — это научная гипотеза с доказательствами, а не полное объяснение модели или гарантия поведения в неизвестных ситуациях.
Практический чек‑лист реализации
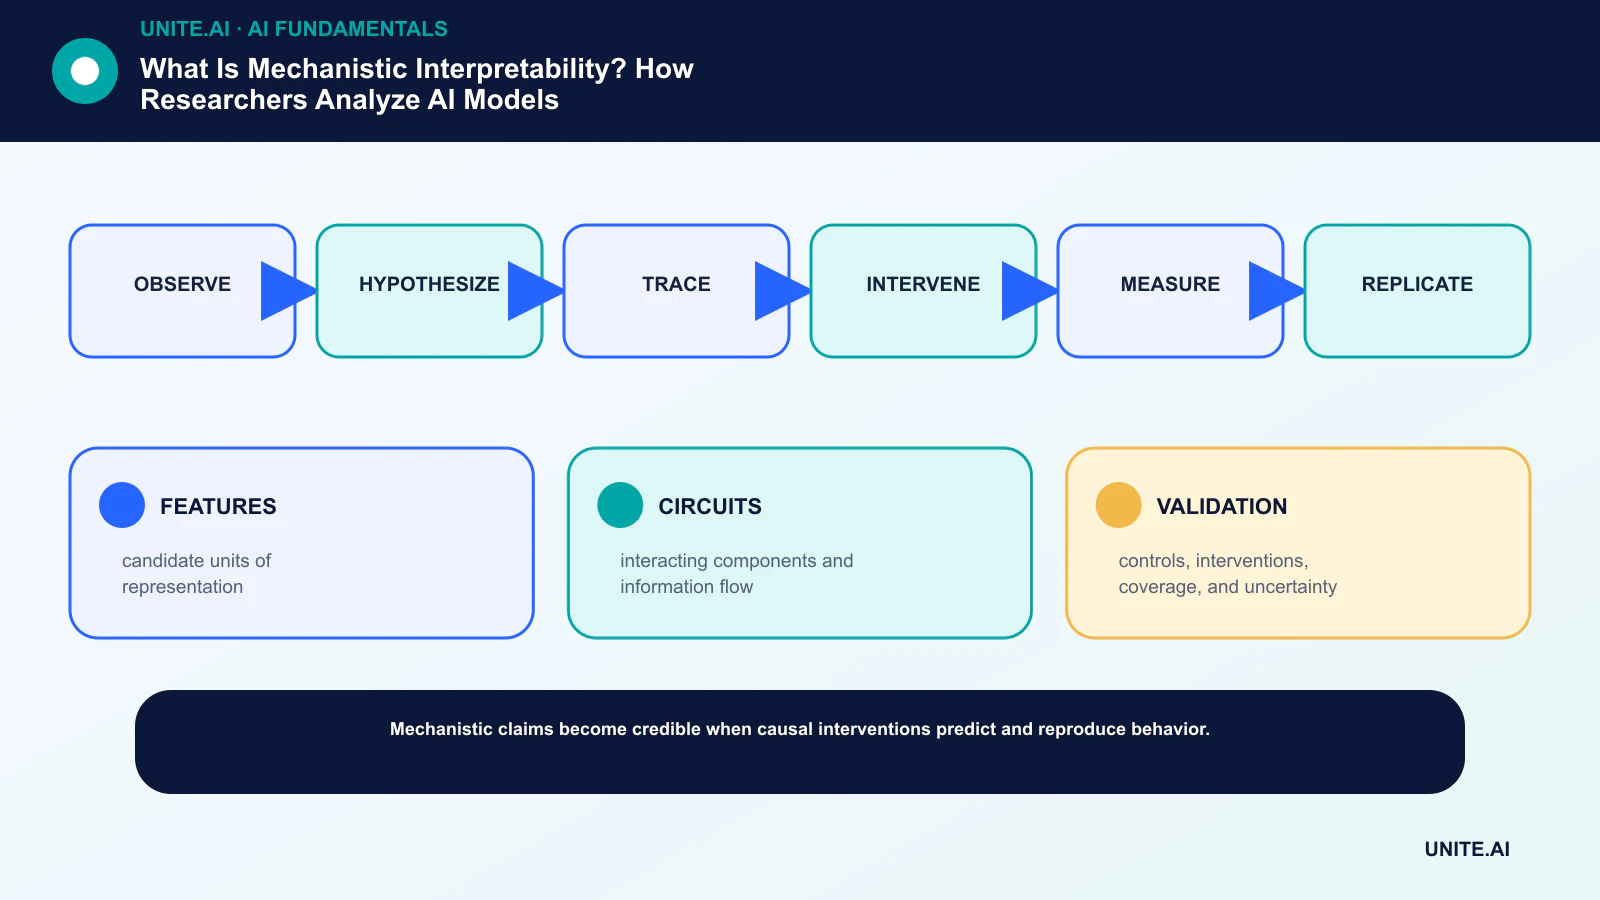
Превратите концепцию в ограниченный, проверяемый рабочий процесс: наблюдать → гипотезировать → трассировать → вмешиваться → измерять → реплицировать. Назначьте ответственного владельца, задокументируйте данные и зависимости, установите простой базовый уровень, задайте критерии принятия и остановки, протестируйте типичные сбои и определите мониторинг, откат и обзор перед расширением охвата. Записывайте версии и допущения, чтобы другая команда могла воспроизвести результат и понять, что изменилось.
Перед запуском проведите документированный обзор готовности с людьми, которые разрабатывают, эксплуатируют, защищают систему и затронуты ею. Тестируйте обычные случаи, граничные условия, сбои зависимостей и неправильное использование; сохраняйте доказательства и нерешённые риски. Определите, кто может одобрять выпуск, менять порог, переопределять вывод или останавливать работу. Пересмотрите решение после поступления реальных данных, поскольку технически успешный пилот не гарантирует надёжную работу в более широком масштабе.
- ОСОБЕННОСТИ: кандидатные единицы представления.
- СХЕМЫ: взаимодействующие компоненты и поток информации.
- ПРОВЕРКА: контролы, вмешательства, охват и неопределённость.
Часто задаваемые вопросы
Является ли механистическая интерпретируемость тем же, что чтение весов модели?
Нет. Сырые веса не объясняют себя сами. Исследователи анализируют активации, признаки, компоненты и вмешательства, чтобы строить и проверять причинные гипотезы.
Могут ли разреженные автокодировщики полностью объяснить большую языковую модель (LLM)?
Нет. Они предоставляют кандидатную базу признаков и могут поддерживать анализ схем, но охват, достоверность, восстановление, маркировка и масштабируемость остаются открытыми проблемами.
Основные ссылки












