
Основы ИИ
Что такое переобучение?

 Добавьте Unite.AI в избранные источники в Google
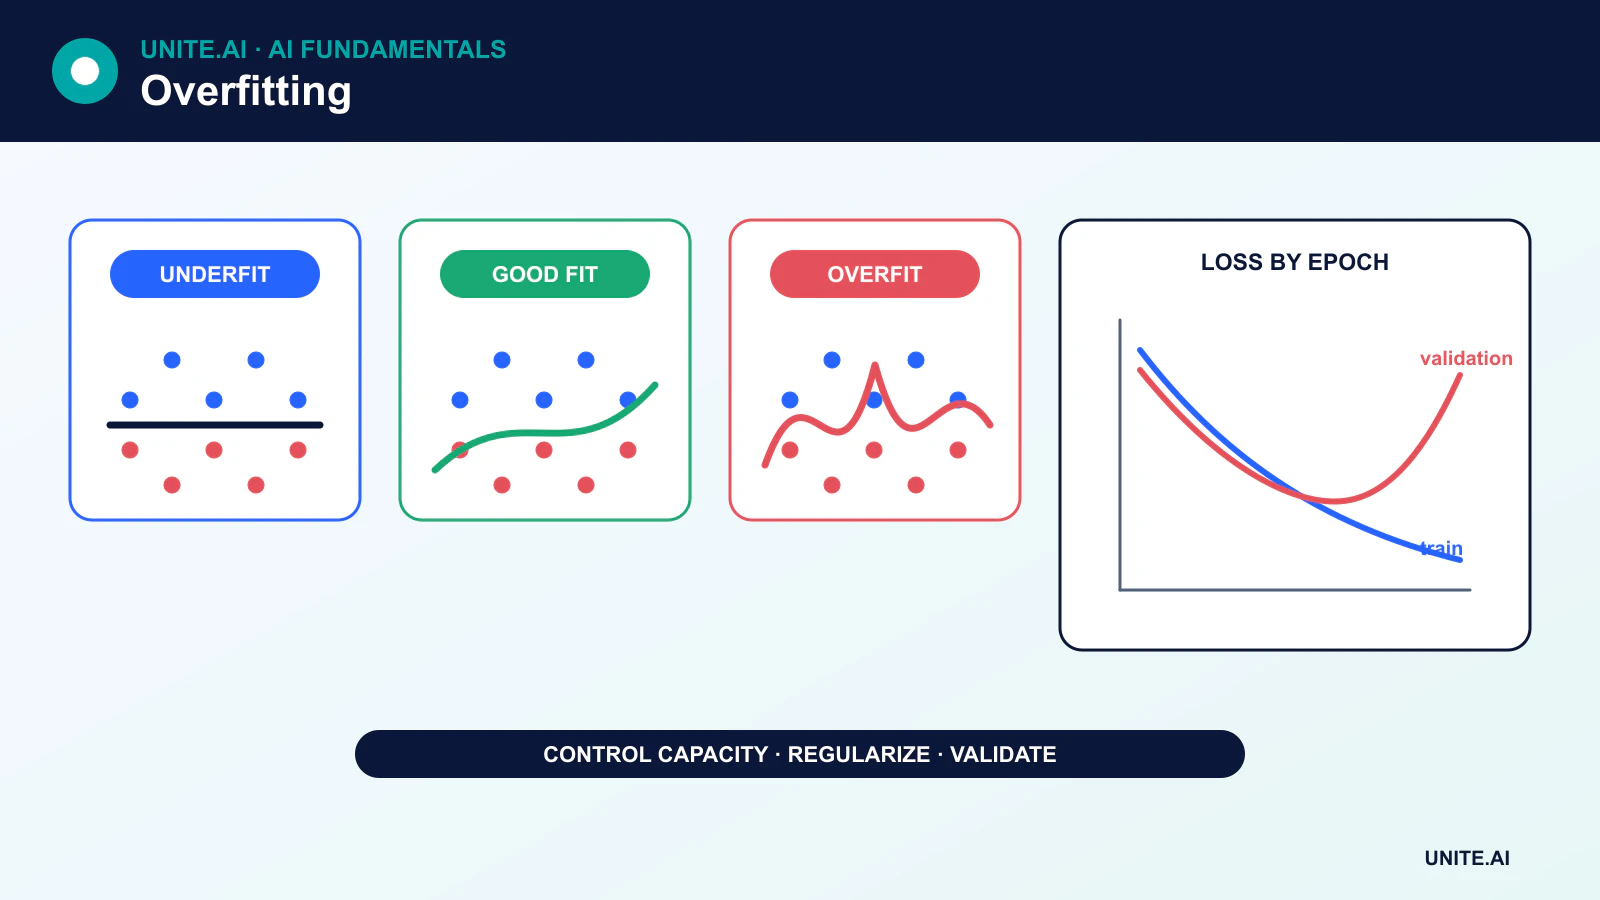
Переобучение происходит, когда модель улавливает паттерны или шум, которые работают исключительно хорошо на обучающих данных, но не способны обобщаться на новые примеры. Переобученная модель может иметь очень низкую ошибку на обучении, тогда как её результаты на валидации или в реальном мире значительно хуже.
Противоположная проблема — недообучение: модель или процесс обучения не способны захватить достаточный сигнал даже на обучающем наборе. Хорошее моделирование балансирует подгонку и обобщение, а не стремится к идеальной производительности на обучении.
Ключевые выводы
- Только показатели обучения не позволяют диагностировать обобщаемость.
- Раннюю остановку следует основывать на поведении валидации, а не принимать повторные решения на финальном тестовом наборе.
- Больше данных может помочь, но увеличение количества признаков или ёмкости также может усилить переобучение.
- Регуляризация, аугментация, кросс‑валидация, предотвращение утечек и корректная оценка решают разные причины.
Подгонка, недообучение и переобучение
Модель недообучается, когда её предположения слишком ограничены, признаки упускают важный сигнал, оптимизация недостаточна или обучение недостаточно длительно. Добавление релевантных признаков или увеличение ёмкости может помочь, но простое добавление произвольных признаков может увеличить шум и привести к переобучению.
Модель переобучается, когда её эффективная ёмкость слишком велика относительно информации в обучающих данных. Примеры включают глубокое дерево решений, создающее крошечные листы, полиномиальную функцию, подгоняющуюся под случайные колебания, или нейронную сеть, запоминающую примеры.
Роль обучающих, валидационных и тестовых данных
- Обучающие данные подгоняют параметры модели.
- Валидационные данные выбирают архитектуру, гиперпараметры, пороги и момент остановки.
- Тестовые данные дают окончательную оценку после завершения всех выборов.
Если тестовый набор неоднократно используется для принятия решений, он становится частью процесса разработки и перестаёт давать несмещённую окончательную оценку. Кросс‑валидация позволяет более эффективно использовать ограниченные данные, однако вся предобработка и отбор признаков должны выполняться внутри каждого обучающего фолда.
Ранняя остановка
Во время обучения ошибка на обучающем наборе обычно продолжает снижаться. Ошибка на валидации может сначала падать, а затем расти, когда модель специализируется на шуме обучающих данных. Ранняя остановка сохраняет контрольную точку с лучшей валидационной метрикой или прекращает обучение, если валидация не улучшалась в течение заданного периода терпения.
Правильная контрольная точка — не та, у которой самая низкая ошибка обучения. Отдельный финальный тестовый набор оценивается после применения ранней остановки и завершения настройки.
Методы регуляризации
Штрафы за веса
L2‑регуляризация или затухание весов подавляет большие значения параметров. L1‑регуляризация может способствовать разреженным коэффициентам. Их влияние зависит от модели и оптимизатора; например, AdamW отделяет затухание весов от адаптивного обновления.
Dropout и стохастическая регуляризация
Dropout случайным образом маскирует активации во время обучения. Другие методы отбрасывают пути, искажают признаки или сглаживают метки. Эти техники меняют цель обучения и должны быть отключены или корректно обработаны при инференсе.
Аугментация данных
Аугментация создает реалистичные вариации — например, обрезки, вращения, шум или перефразирование — которые должны сохранять целевую метку. Некорректные преобразования могут изменить метку и навредить модели. Для компьютерного зрения такие инструменты, как Albumentations, помогают реализовать контролируемые конвейеры.
Контроль ёмкости
Более мелкие деревья, меньшее количество параметров, отбор признаков, обрезка и более простые классы гипотез могут уменьшить дисперсию. Обрезка деревьев управляется критериями, а не случайным удалением изученных деталей.
Утечка данных может выглядеть как исключительная производительность
Утечка происходит, когда информация, недоступная в момент предсказания, попадает в обучение или оценку. Распространённые примеры включают нормализацию, рассчитанную на полном наборе данных, распределение повторяющихся записей по фолдам, использование будущих данных для предсказания прошлого или включение признака, полученного из целевой переменной.
Утечка не является обычным переобучением, но создаёт тот же вводящий в заблуждение разрыв между офлайн‑результатами и развертыванием. Стратегия разбиения должна учитывать время, идентичность, местоположение и процессы генерации данных.
Смещение распределения — отдельная проблема
Модель может успешно обобщаться на тестовое распределение, но всё равно потерпеть неудачу при изменении данных в продакшене. Новые устройства, политики, популяции, сезоны или враждебное поведение могут изменить связь между входом и целевой переменной. Мониторинг и периодическая переоценка необходимы, даже если исходная модель не была переобучена.
Диагностика переобучения
Используйте обучающие кривые, дисперсию кросс‑валидации, метрики подгрупп, калибровку и анализ ошибок. Если результаты как на обучении, так и на валидации плохие, сосредоточьтесь на недообучении, признаках, метках или оптимизации. Если обучение показывает хорошие результаты, а валидация — слабые, исследуйте ёмкость, утечки, регуляризацию и представительность данных, прежде чем просто собирать больше данных.
Почему происходит переобучение и как его обнаружить
Переобучение происходит, когда модель изучает паттерны, снижающие ошибку обучения, но не способные обобщаться на целевую популяцию. Причинами являются избыточная ёмкость относительно доступных данных, шум в метках, повторяющиеся объекты, гибкий отбор признаков, утечки и настройка на одном и том же валидационном наборе. Расширяющийся разрыв между результатами обучения и валидации является типичным свидетельством, однако небольшой разрыв не исключает переобучения, если оба набора загрязнены или отличаются от условий эксплуатации. Обучающие кривые по объёму данных и ёмкости помогают различать дисперсию и смещение.
Утечка особенно вводит в заблуждение: будущая информация, дубли, перекрывающиеся субъекты, предобработка, обученная на всех данных, или метки, закодированные в метаданных, могут дать отличные результаты на отложенном наборе. Разделяйте данные по единице, которая будет новой при развертывании — пациенту, клиенту, машине, месту или времени — до применения преобразований или аугментаций. Оставляйте финальный тестовый набор закрытым при выборе признаков, архитектуры и порогов. Если команды постоянно проверяют результаты теста, тестовый набор превращается в ещё один валидационный набор и требует замены или формального исправления.
Регуляризация, выбор модели и дрейф в продакшене
Снизьте переобучение с помощью более репрезентативных данных, снижения ёмкости, затухания весов, dropout, ранней остановки, аугментации, ансамблирования или ограничений, отражающих структуру домена. Каждый метод имеет компромиссы: аугментация может искажать метки, dropout меняет процесс оптимизации, а ансамбли увеличивают стоимость обслуживания. Кросс‑валидация оценивает вариативность выбора, однако групповые или временно‑ориентированные фолды должны сохранять границу развертывания. Сравнивайте с простой моделью и сообщайте неопределённость по фолдам или случайным инициализациям, а не выбирайте самый благоприятный запуск.
Продакшн может выявить иной тип сбоя обобщения, когда меняются входные данные, пользователи, стимулы или измерения. Следите за распределениями признаков и предсказаний, калибровкой, результатами подгрупп и отложенной истинной меткой. Не переобучайте модель автоматически на непроверенной обратной связи; её собственные решения могут формировать метки, которые она позже увидит. Диагностируйте, связан ли сбой с дрейфом, конвейером данных, изменениями политики или неверной целевой переменной. Переобучение контролируется экспериментальным дизайном и дисциплиной жизненного цикла, а не одной настройкой регуляризации.
Практический пример: устранение утечки в модели обнаружения мошенничества
Начальный классификатор мошенничества показывает чрезвычайно хорошие результаты, потому что повторяющиеся события по картам и торговцам попадают в случайные строки обучающего и тестового наборов, а информация о возврате средств, записанная через недели, включена как признак. Команда восстанавливает время доступности каждого признака, удаляет поля, появляющиеся после принятия решения, группирует данные по аккаунту и использует разбиение по времени вперёд. Производительность резко падает, но теперь оценка соответствует реальному решению. Простая базовая система правил и обучающие кривые помогают определить необходимую сложность модели.
Регуляризация и ранняя остановка настраиваются только внутри исторических фолдов. Окончательная оценка сообщает точность при заданной ёмкости проверки, полноту, калибровку и стоимость по типу мошенничества и сегменту клиентов. В продакшене подтверждённые метки поступают с задержкой и смещены тем, какие транзакции были проверены, поэтому мониторинг отделяет дрейф оценок от оценок исходов. Переобучение использует судебные случаи и повторный запуск по текущей политике. Проект предпочитает более низкую, но честную оценку, чем высокую, полученную за счёт утечки, которая не выдерживает развертывания.
Доказательства внедрения и готовность к эксплуатации
Решение о выводе в продакшн требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочее окружение, входы, выходы, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базовую линию и версионированный набор для оценки до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входные данные, смещение распределения, сбои зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Оценивайте качество задачи совместно с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Зафиксируйте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Применяйте поэтапный релиз, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно введёнными сбоями. Оперативная телеметрия должна показывать качество входных данных, поведение выходов, версию модели или правила, состояние зависимостей, вмешательства человека и подтверждённые результаты без сбора лишних конфиденциальных данных. Определите пороги оповещений и ответственного за реакцию, затем проверяйте реальные доказательства после развертывания, а не полагайтесь на сохранение офлайн‑производительности. Проводите переоценку при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемой системе также требуются документированные процедуры восстановления, обучения на инцидентах, удаления и хранения данных, а также чёткая точка, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Может ли простая модель переобучиться?
Да. Повторный отбор признаков, настройка порогов или оценка на том же отложенном наборе могут привести к переобучению процесса разработки, даже если итоговая модель проста.
Всегда ли больше обучающих данных решает проблему переобучения?
Нет. Больше репрезентативных, правильно размеченных данных может помочь, но дублированные, предвзятые, утекшие или данные из другого домена могут не решить проблему. Цель обучения и дизайн оценки по‑прежнему важны.
Основные ссылки












