Основы ИИ
Что такое дерево решений?

 Добавьте Unite.AI в избранные источники в Google
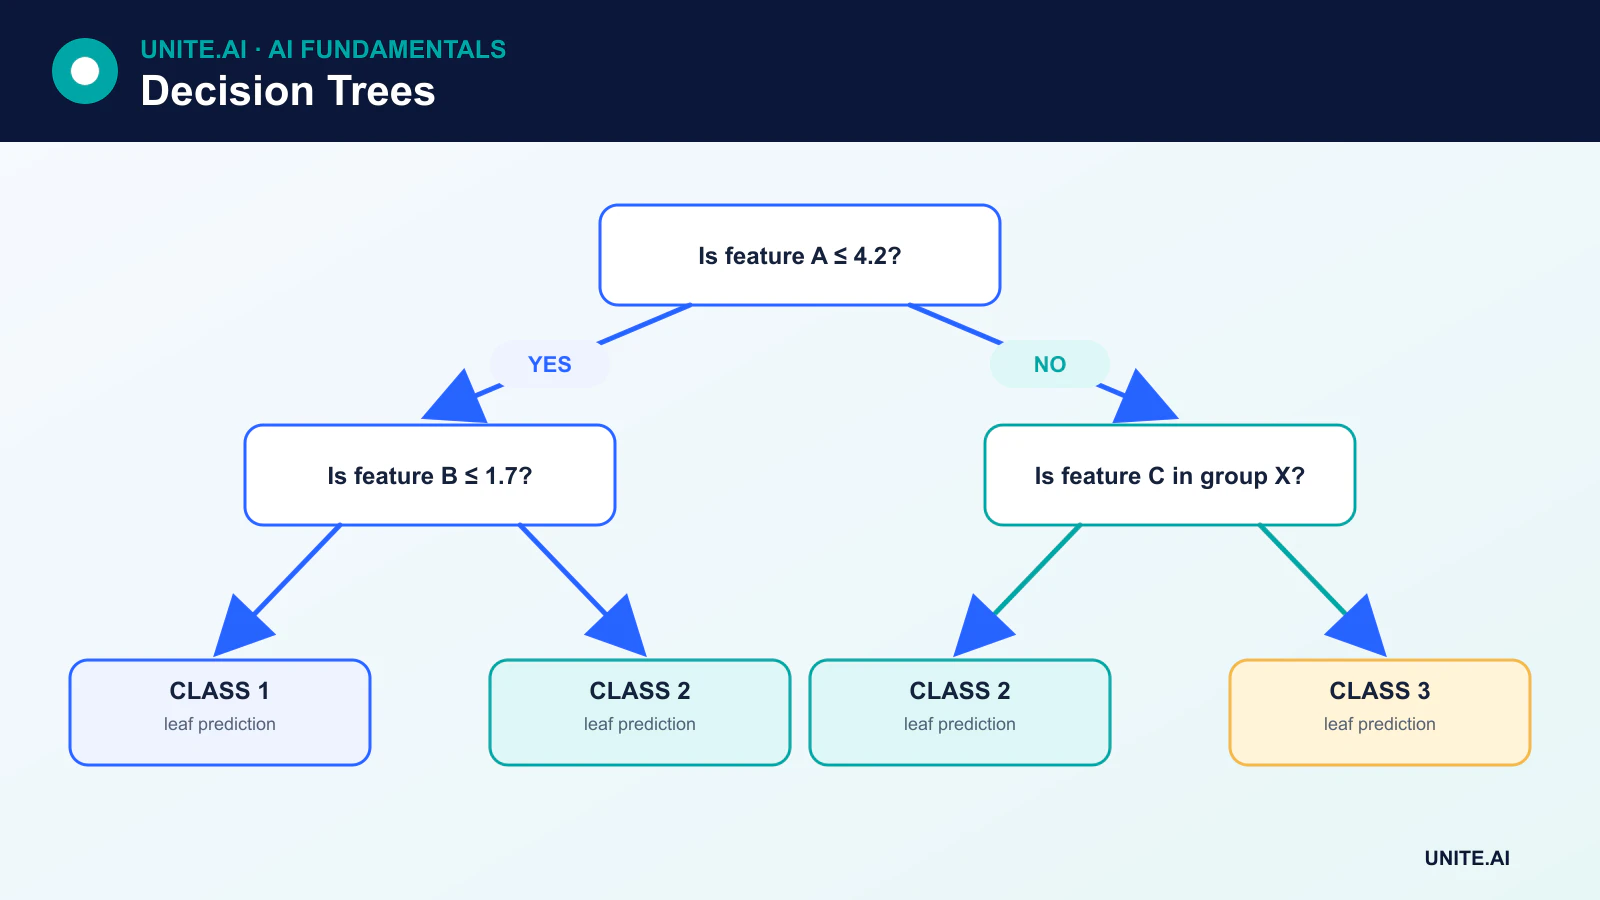
Дерево решений — это модель обучения с учителем, которая делает предсказание, применяя последовательность правил если‑то. Каждый внутренний узел проверяет признак, каждая ветвь представляет результат этой проверки, а каждый лист выдаёт предсказание класса, вероятность или числовое значение.
Деревья решений используются для классификации и регрессии. Их привлекательность практична: они могут представлять нелинейные взаимодействия, требуют относительно небольшого предварительного анализа и создают путь, который человек может просмотреть. Их слабость — нестабильность: небольшие изменения в обучающих данных могут привести к построению другого дерева.
Ключевые выводы
- Дерево рекурсивно разбивает пространство признаков; ему не требуется изолировать каждое обучающее наблюдение.
- Для классификации разбиения обычно используют критерий Джини или энтропию, а для регрессии разбиения уменьшают ошибку предсказания или дисперсию.
- Глубина, минимальный размер листа и обрезка контролируют сложность и переобучение.
- Случайные леса и градиентный бустинг улучшают предсказательную способность, объединяя множество деревьев.
Как дерево решений делает предсказание
Предположим, модель предсказывает, будет ли машина склонна к поломке. Корневой узел может задавать вопрос, превышает ли вибрация установленный порог. Затем ветвь может проверять рабочую температуру. Наблюдение попадает в лист, содержащий оценённую вероятность отказа среди обучающих примеров, прошедших тот же путь.
Для регрессии лист может возвращать среднее значение целевой переменной наблюдений в этом регионе. Для классификации он может возвращать доминирующий класс или распределение частот классов. В листе может быть много наблюдений; полное разделение обучающих данных обычно нежелательно, поскольку может привести к переобученному дереву.
Как дерево выбирает разбиение
Во время обучения рассматриваются кандидатные признаки и пороги, после чего выбирается разбиение, которое наиболее улучшает заданную цель. Улучшение должно быть взвешено по количеству наблюдений, попадающих в каждый дочерний узел.
Неравномерность Джини
Для классификации неравномерность Джини измеряет, насколько смешаны классы в узле:
Gini = 1 - Σ p(k)²
Узел, содержащий только один класс, имеет нулевую неравномерность. Кандидатное разбиение полезно, когда взвешенная неравномерность его дочерних узлов ниже, чем неравномерность родительского узла.
Энтропия и прирост информации
Энтропия — ещё одна мера неопределённости классов:
Entropy = -Σ p(k) log₂ p(k)
Прирост информации — это энтропия родителя минус взвешенная энтропия дочерних узлов. Джини и энтропия часто дают похожие деревья, хотя не всегда идентичные.
Функция потерь регрессии
Деревья регрессии обычно выбирают разбиения, уменьшающие квадратичную ошибку, абсолютную ошибку или иной критерий регрессии. Каждый лист затем предсказывает значение, основанное на целевых переменных обучающих примеров внутри этого региона.
CART и другие алгоритмы деревьев
CART, или Classification and Regression Trees, использует бинарные разбиения и лежит в основе распространённых реализаций, таких как деревья решений scikit-learn. Другие алгоритмы включают ID3, C4.5 и C5.0. Реализации различаются поддерживаемыми типами разбиений, обработкой пропущенных значений, обрезкой и целевыми функциями.
Категориальные переменные могут требовать кодирования, прямых разбиений подмножеств или специфической для реализации обработки. Пропущенные значения можно заполнять или обрабатывать с помощью выученных направлений по умолчанию или суррогатных разбиений. Важно понимать поведение конкретной библиотеки, а не полагать, что все реализации деревьев работают одинаково.
Контроль сложности дерева
Глубокое дерево может запоминать шум. Обычные средства контроля включают:
- Максимальная глубина: ограничивает длину пути предсказания.
- Минимальное количество образцов на разбиение или лист: предотвращает создание крошечных областей.
- Минимальное уменьшение неравномерности: требует, чтобы разбиение давало достаточный выигрыш.
- Максимальное количество листьев: ограничивает общую сложность.
- Обрезка по стоимости‑сложности: удаляет ветви, улучшение от которых не оправдывает добавленную сложность.
Обрезка — это структурированный процесс оптимизации, а не случайное удаление. Гиперпараметры следует выбирать с помощью данных валидации или кросс‑валидации, при этом финальный тестовый набор остаётся нетронутым.
Преимущества и ограничения
Деревья решений могут моделировать взаимодействия и пороговые эффекты без масштабирования признаков. Они принимают числовые и, в зависимости от реализации, категориальные входные данные. Предсказание быстрое, а небольшое дерево легко визуализировать.
Однако отдельное дерево может иметь высокую дисперсию, создавать резкие изменения предсказаний рядом с разбиением и отдавать предпочтение признакам с большим числом возможных точек разбиения. Деревья также плохо экстраполируют в регрессии: за пределами наблюдаемых областей лист всё равно возвращает значение, полученное из обучающих образцов. Большое дерево может быть не более понятным, чем другая сложная модель.
От одного дерева к ансамблям
Обучение ансамблями объединяет несколько моделей. Случайный лес обучает множество деревьев на пересэмплированных наблюдениях и подмножествах признаков, затем усредняет их предсказания. Градиентный бустинг строит деревья последовательно, так что каждое новое дерево исправляет оставшуюся ошибку. Эти подходы обычно превосходят одно дерево, но они жертвуют частью интерпретируемости и увеличивают вычислительные затраты.
Важность признаков, полученная от дерева или ансамбля, следует интерпретировать осторожно. Важность, основанная на неравномерности, может быть смещённой, и важность признака не доказывает причинно‑следственную связь. Перестановочная важность, инструменты частичной зависимости и экспертный обзор предоставляют дополнительный контекст.
Как дерево обучается разбиениям и предсказаниям
Дерево решений рекурсивно разбивает пространство признаков. На каждом узле обучающий алгоритм оценивает кандидатные пороги признаков или разбиения категорий и выбирает разбиение, которое наиболее уменьшает неравномерность, например неравномерность Джини или энтропию для классификации и квадратичную ошибку для регрессии. Листы сохраняют распределение классов или числовое предсказание на основе обучающих наблюдений, попадающих в них. Жадное разбиение практично с вычислительной точки зрения, но не гарантирует глобально оптимального дерева, и разные выборки или правила разрешения ничьих могут приводить к различным структурам.
Непрерывные, порядковые, категориальные и пропущенные признаки требуют явной обработки. One‑hot кодирование может создавать множество кандидатных разбиений; нативные категориальные методы могут использовать упорядоченную статистику, но требуют реализации, защищённой от утечки. Деревья не требуют масштабирования, однако они могут отдавать предпочтение переменным с высоким кардиналом и изолировать небольшие группы. Глубина, минимальный размер листа, минимальное уменьшение неравномерности и обрезка по стоимости‑сложности контролируют дисперсию. Выбирайте их с помощью данных валидации и оценивайте калибровку, поскольку вероятность в листе, основанная на небольшом числе случаев, может быть экстремальной и нестабильной.
Интерпретация, режимы отказов и использование в продакшене
Путь от корня к листу представляет собой точное правило для одного предсказания модели, но это не автоматически причинное объяснение. Коррелированные переменные могут заменять друг друга, небольшие изменения в данных могут менять верхние разбиения, а простой на вид путь может зависеть от смещённых меток. Глобальная важность признаков, основанная на неравномерности, может вводить в заблуждение; перестановочная важность, частичная зависимость и контрфактические проверки добавляют контекст, но также имеют предположения. Сообщайте о неопределённости и проверяйте, сохраняется ли предполагаемое правило на независимых данных и в релевантных подгруппах.
Отдельные деревья полезны, когда важны прозрачность, низкая задержка и умеренная нелинейная структура, но ансамбли обычно обеспечивают более высокую предсказательную эффективность. Проверяйте поведение на границах, редкие категории, пропуски и входные данные за пределами обучающего диапазона. Экспортированные правила должны точно воспроизводить предобработку обучения и числовые сравнения. Следите за заполненностью листов, распределением выходов, ошибками и появляющимися категориями. Дерево, которое направляет множество новых случаев в крошечный или ранее пустой регион, должно вызывать проверку, даже если общий дрейф остаётся небольшим. Сохраняйте резервный вариант для некорректных схем и документируйте каждое решение об обрезке или пороге.
Практический пример: интерпретируемое дерево сортировки заявок на кредит
Кредитор использует дерево исключительно для приоритизации неполных заявок на ручную проверку, а не для одобрения или отклонения кредита. Целевой переменной является документированный показатель полноты, а доступные при приёме признаки не включают последующие решения. Групповая временная валидация сравнивает неглубокое обрезанное дерево с правилами и логистической регрессией. Минимальный размер листа предотвращает правила, основанные на небольшом числе заявителей, при этом калибровка и ошибки по классам сообщаются по каналам и релевантным защищённым группам.
Рецензенты видят точный путь и исходные значения, но могут исправлять ошибочные данные и переопределять маршрутизацию. Организация проверяет коррелированные прокси и контрфактические изменения, следит за заполненностью листов и пропусками, и рассматривает внезапный поток в небольшой лист как инцидент качества данных. Изменения политики создают новую версию модели и валидацию, а не незадокументированное изменение разбиения. Поскольку использование влияет на доступ и нагрузку, заявители получают человеческий канал, и дерево никогда не представляется как причинное объяснение кредитоспособности.
Доказательства реализации и готовность к эксплуатации
Производственное решение требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочую среду, входные и выходные данные, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базовую линию и версионированный набор для оценки до настройки. Тестируйте обычные случаи, граничные условия, некорректный или отсутствующий ввод, сдвиг распределения, отказ зависимостей, неправильное использование и группы или среды, наиболее подверженные недостаточному обслуживанию. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развёртывание, сохраняйте безопасный резерв и проверяйте мониторинг с преднамеренно введёнными сбоями. Оперативная телеметрия должна показывать качество ввода, поведение вывода, версию модели или правила, состояние зависимостей, человеческие переопределения и подтверждённые результаты без сбора ненужных конфиденциальных данных. Определите пороги оповещений и ответственного за реакцию, затем после развертывания проверяйте реальные доказательства, а не полагайтесь на сохранение офлайн‑производительности. Переоценивайте при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемой системе также необходима документированная процедура восстановления, обучения на инцидентах, удаления и хранения, а также чёткая точка, в которой её следует отключить или заменить.
Основные ссылки