
Основы ИИ
Что такое матрица ошибок?

 Добавьте Unite.AI в избранные источники в Google
A матрица ошибок — это таблица, в которой подсчитывается, насколько часто предсказания классификатора совпадают или расходятся с известными метками. Она показывает, какие классы путаются, и предоставляет счётчики, используемые для расчёта метрик, таких как точность, полнота, специфичность и F1. Это один из основных диагностических инструментов для контролируемого обучения классификационных задач.
Само по себе матрица не представляет единой оценки качества. Это структурированный обзор результатов при конкретном пороге принятия решения, наборе данных и определении классов.
Ключевые выводы
- Для бинарной классификации четыре результата — истинно‑положительный, ложно‑положительный, ложно‑отрицательный и истинно‑отрицательный.
- Всегда подписывайте оси: в библиотеках и публикациях не всегда одинаково размещаются реальные и предсказанные классы.
- Точность может скрывать серьёзные ошибки при несбалансированных классах.
- Изменение порога классификации меняет матрицу ошибок и компромисс между точностью и полнотой.
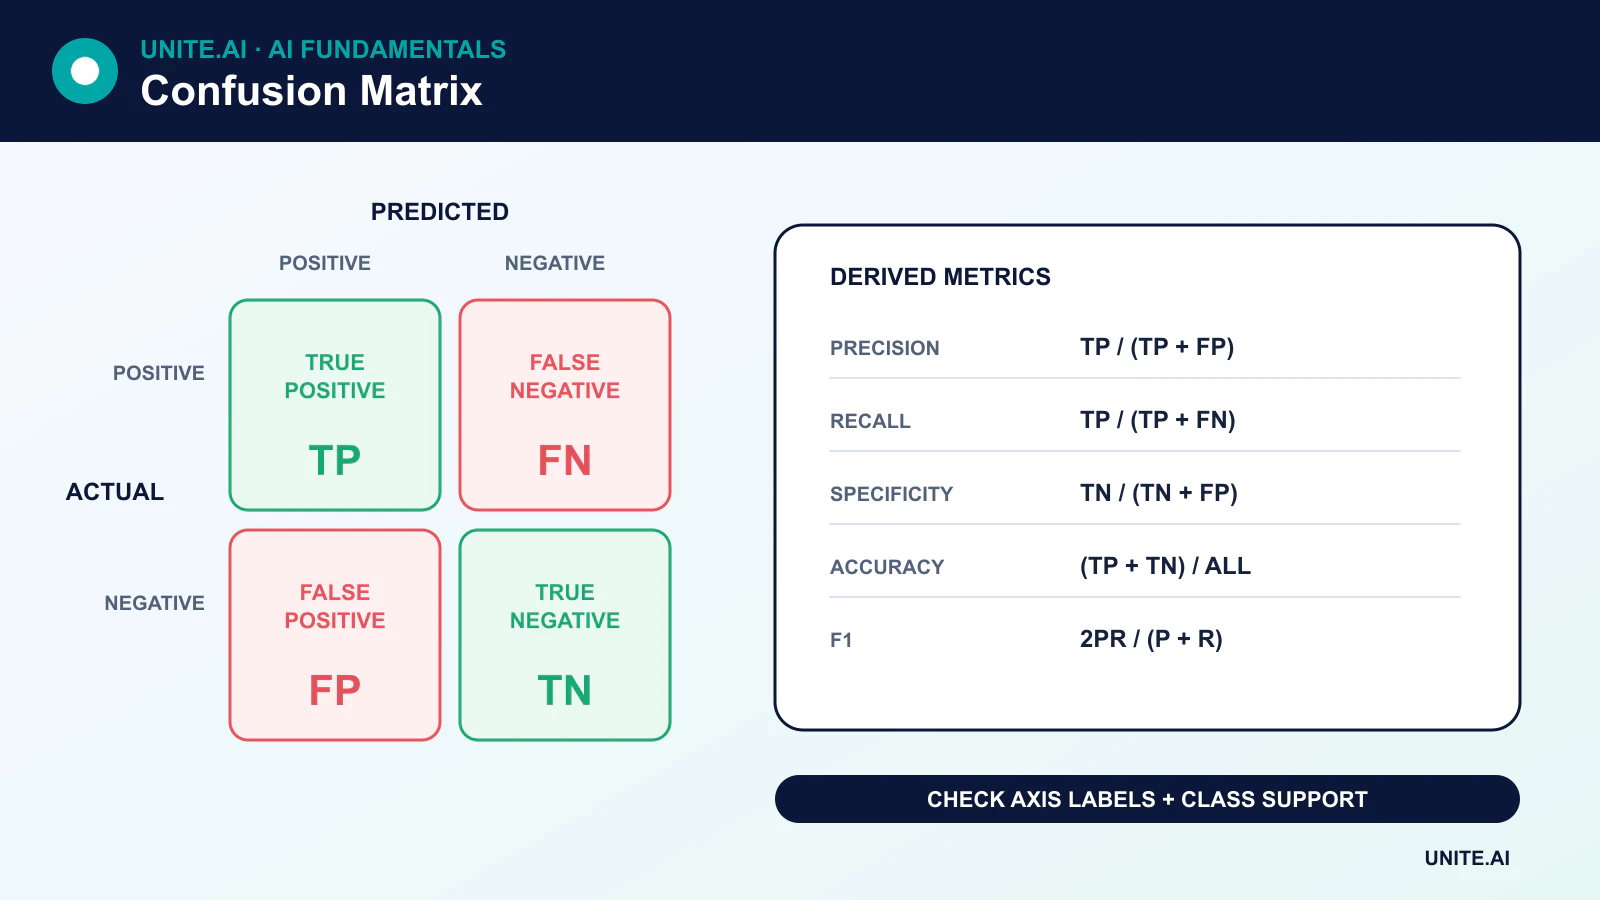
Четыре результата бинарной классификации
- Истинно‑положительный (TP): пример является положительным, и модель предсказывает положительный.
- Ложно‑положительный (FP): пример отрицательный, но модель предсказывает положительный.
- Ложно‑отрицательный (FN): пример положительный, но модель предсказывает отрицательный.
- Истинно‑отрицательный (TN): пример отрицательный, и модель предсказывает отрицательный.
В соответствии с конвенцией scikit-learn строки соответствуют истинным классам, а столбцы — предсказанным. Другие визуализации могут транспонировать эту схему, поэтому следует ориентироваться на подписи, а не на расположение в углах.
Метрики, получаемые из матрицы ошибок
Точность
Precision = TP / (TP + FP)
Точность отвечает: среди примеров, предсказанных как положительные, какая доля действительно положительна?
Полнота или чувствительность
Recall = TP / (TP + FN)
Полнота отвечает: среди всех реально положительных примеров, какая доля была обнаружена моделью? В бинарной классификации полнота положительного класса также называется чувствительностью или уровнем истинно‑положительных.
Специфичность
Specificity = TN / (TN + FP)
Специфичность — это полнота для отрицательного класса: среди реальных отрицательных примеров, какая доля была правильно отклонена моделью.
Точность (accuracy)
Accuracy = (TP + TN) / (TP + TN + FP + FN)
Точность полезна, когда классы и стоимость ошибок примерно сбалансированы. Она может вводить в заблуждение, если один класс преобладает.
F1‑метрика
F1 = 2 × (Precision × Recall) / (Precision + Recall)
F1‑метрика суммирует точность и полноту с помощью гармонического среднего. Она игнорирует истинно‑отрицательные случаи, поэтому не подходит в качестве итоговой метрики для каждой задачи.
Пример расчётов
Предположим, тестовый набор содержит 1 000 транзакций. Пятьдесят из них мошеннические. Модель обнаруживает 40 из этих мошенничеств, но помечает 30 легитимных транзакций как мошеннические:
- TP = 40
- FN = 10
- FP = 30
- TN = 920
Модель демонстрирует точность 96 %, но её точность составляет около 57 %, а полнота — 80 %. Высокая точность объясняется большим количеством легитимных транзакций. Приемлемость модели зависит от стоимости пропущенного мошенничества, возможностей расследования и того, насколько откалиброваны её оценки риска.
Пороги меняют матрицу
Большинство классификаторов выводят оценку вместо однозначного «да/нет». Понижение положительного порога, как правило, повышает полноту и количество ложных срабатываний; повышение порога обычно повышает точность или специфичность, но приводит к пропуску большего числа положительных случаев. Порог следует выбирать на основе валидационных данных и реальных стоимостей ошибок, а не фиксировать автоматически на уровне 0,5.
Кривые точность‑полнота и ROC суммируют эффективность при разных порогах. Кривые точность‑полнота часто более информативны, когда положительный класс редок.
Многоклассовые матрицы ошибок
Для K классов матрица имеет размер K × K. Правильные предсказания находятся на диагонали; ячейки вне диагонали показывают, какие пары классов путаются. Метрики по каждому классу можно усреднять разными способами:
- Macro‑average: каждому классу присваивается одинаковый вес.
- Weighted‑average: каждый класс взвешивается по количеству его примеров.
- Micro‑average: агрегирует счётчики исходов перед вычислением метрики.
Отчёт только по одному среднему может скрывать плохие результаты по небольшим классам. Включайте количество примеров (support) и результаты по каждому классу, где различия имеют значение.
Распространённые ошибки
- Чтение транспонированной матрицы без проверки подписей осей.
- Вычисление метрик на обучающих данных вместо подходящего отложенного набора.
- Игнорирование распространённости классов, стратегии выборки или дублирования объектов между разбиениями.
- Сравнение матриц, построенных при разных порогах, без указания изменения.
- Считать все ложные срабатывания и пропуски одинаково затратными.
Таким образом, матрица ошибок — это диагностический инструмент, а не полная оценка. Калибровка, анализ подгрупп, надёжность и последующие последствия также должны учитываться при оценке классификатора.
Чтение каждой ячейки и вывод полезных метрик
Для бинарной классификации матрица ошибок подсчитывает истинно‑положительные, ложно‑положительные, ложно‑отрицательные и истинно‑отрицательные случаи для выбранного положительного класса и порога. Точность (accuracy) делит количество правильных предсказаний на общее число случаев; точность (precision) спрашивает, какая доля предсказанных положительных оказалась верной; полнота (recall) — какая доля реальных положительных была найдена; специфичность измеряет, насколько правильно отклоняются реальные отрицательные. F1 — гармоническое среднее точности и полноты. Нет единственной «лучшей» метрики: в задачах обнаружения мошенничества, медицинской триаже и фильтрации спама одинаковые ячейки имеют разные последствия.
В многоклассовых задачах строки обычно представляют реальные классы, а столбцы — предсказанные, хотя конвенции различаются, поэтому подписи должны быть явными. Подсчёт «один против остальных» дает точность и полноту по каждому классу. Macro‑averaging взвешивает классы одинаково; micro‑averaging агрегирует решения и отдаёт предпочтение распространённым классам; weighted‑averaging учитывает количество примеров в каждом классе. В задачах многократных меток один объект может иметь несколько меток, требующих определения метрик по меткам или по образцам. Нормализуйте по строкам, чтобы изучать паттерны полноты, или по столбцам, чтобы изучать состав предсказаний, но сохраняйте сырые счётчики, чтобы редкие группы не были визуально преувеличены.
Пороги, неопределённость и операционные решения
Матрица ошибок суммирует жёсткие решения при одном пороге. Для сравнения порогов используйте кривые точность‑полнота или ROC, затем выберите рабочую точку, учитывая ёмкость, распространённость и стоимость ошибок. Калибровка проверяет, соответствуют ли предсказанные вероятности наблюдаемой частоте, и отличается от ранжирования. При изменении распространённости точность может измениться, даже если чувствительность и специфичность остаются стабильными. Публикуйте доверительные интервалы или результаты бутстреп‑оценки и избегайте делать выводы на основе небольшого количества ошибок в малой подгруппе.
Аудитируйте матрицы по времени, месту, устройству, языку и соответствующим затронутым группам, чтобы выявить сконцентрированные ошибки. Сравнивайте модель с существующим процессом принятия решений, включая человеческую проверку. Для каскадов фиксируйте ошибки на каждом этапе: извлечение, классификация, пороговое решение и действие. Отслеживайте живые метки результатов с учётом задержки и процесса исправления. Казалось бы, улучшенный F1 может всё же увеличить количество вредных ложных отрицаний или превысить ёмкость проверки. Матрица ошибок — это реестр решений; связывайте каждую ячейку с тем, кто столкнулся с ошибкой, и с последующим ответом.
Пример: выбор порога для медицинского скрининга
Модель скрининга на основе машинного обучения выдаёт оценку риска для редкого заболевания. Команда формирует матрицы ошибок при разных порогах и сообщает чувствительность, специфичность, точность, количество ложных направлений и пропущенных случаев с доверительными интервалами. Поскольку положительная прогностическая ценность зависит от распространённости, она моделирует целевую популяцию, а не приводит точность одного набора данных. Результаты разбиты по устройствам, площадкам, возрасту, полу и другим клинически обоснованным группам.
Клинические специалисты выбирают рабочую точку, сохраняющую необходимую чувствительность без перегрузки подтверждающих тестов. Матрица переводится в ожидаемые количества на 10 000 обследованных людей, чтобы последствия были понятны. Оценки за пределами проверенных условий не приводят к автоматическому выводу. Мониторинг сравнивает предсказания с отложенными подтверждёнными диагнозами, отслеживает ёмкость и калибровку и инициирует пересмотр при изменении распространённости или методов сбора данных. Матрица ошибок остаётся привязанной к конкретной модели, порогу и популяции.
Доказательства внедрения и готовность к эксплуатации
Решение о внедрении в продакшн требует большего, чем успешная демонстрация. Определите целевых пользователей, эксплуатационную среду, входные и выходные данные, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базовую линию и версионированный набор для оценки до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входные данные, сдвиги распределения, отключения зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Оценивайте качество задачи совместно с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и различить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Применяйте поэтапный развёртывание, сохраняйте безопасный резерв и проверяйте мониторинг с преднамеренно внесёнными сбоями. Оперативная телеметрия должна показывать качество входных данных, поведение вывода, версию модели или правила, состояние зависимостей, вмешательства человека и подтверждённые результаты без сбора лишних конфиденциальных данных. Определите пороги оповещений и ответственного за реакцию, затем после внедрения проверяйте реальные данные, а не полагайтесь на предположения о стабильности офлайн‑результатов. Переоценивайте систему при изменении источников данных, пользователей, моделей, поставщиков, политик, аппаратного обеспечения или целей. Поддерживаемая система также требует документированных процедур восстановления, обучения на инцидентах, удаления и хранения данных, а также чёткой точки, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Что такое нормализованная матрица ошибок?
Нормализация делит счётчики на общее количество примеров истинного класса, предсказанного класса или всех наблюдений. Это упрощает сравнение долей между классами, однако в отчёте следует также сохранять исходные количества (support), чтобы небольшие группы не воспринимались как одинаково крупные.
Можно ли использовать матрицу ошибок для оценки регрессии?
Не напрямую. Матрица ошибок требует дискретных классов. Биннинг непрерывной целевой переменной теряет информацию; для регрессии обычно используют анализ остатков и метрики, предназначенные для непрерывных значений, такие как MAE или RMSE.
Основные источники












