Основы ИИ
Что такое объяснимый ИИ?

 Добавьте Unite.AI в избранные источники в Google
Explainable AI (XAI) включает методы и практики, помогающие людям понять поведение или выводы системы ИИ. Объяснение может описывать влиятельные входные данные, показывать похожий пример, представлять контрфактическое изменение, суммировать глобальное правило или сообщать, когда система не знает.
Нет единственно лучшего объяснения. Разработчик, отлаживающий модель, аудитор, проверяющий соответствие политике, и человек, затронутый решением, нуждаются в разных доказательствах. Поэтому объяснения должны оцениваться по точности, смыслу и предполагаемому использованию — а не только по визуальной привлекательности.
Ключевые выводы
- Прозрачность описывает доступную информацию; интерпретируемость касается смысла; объяснение передаёт доказательства или причины.
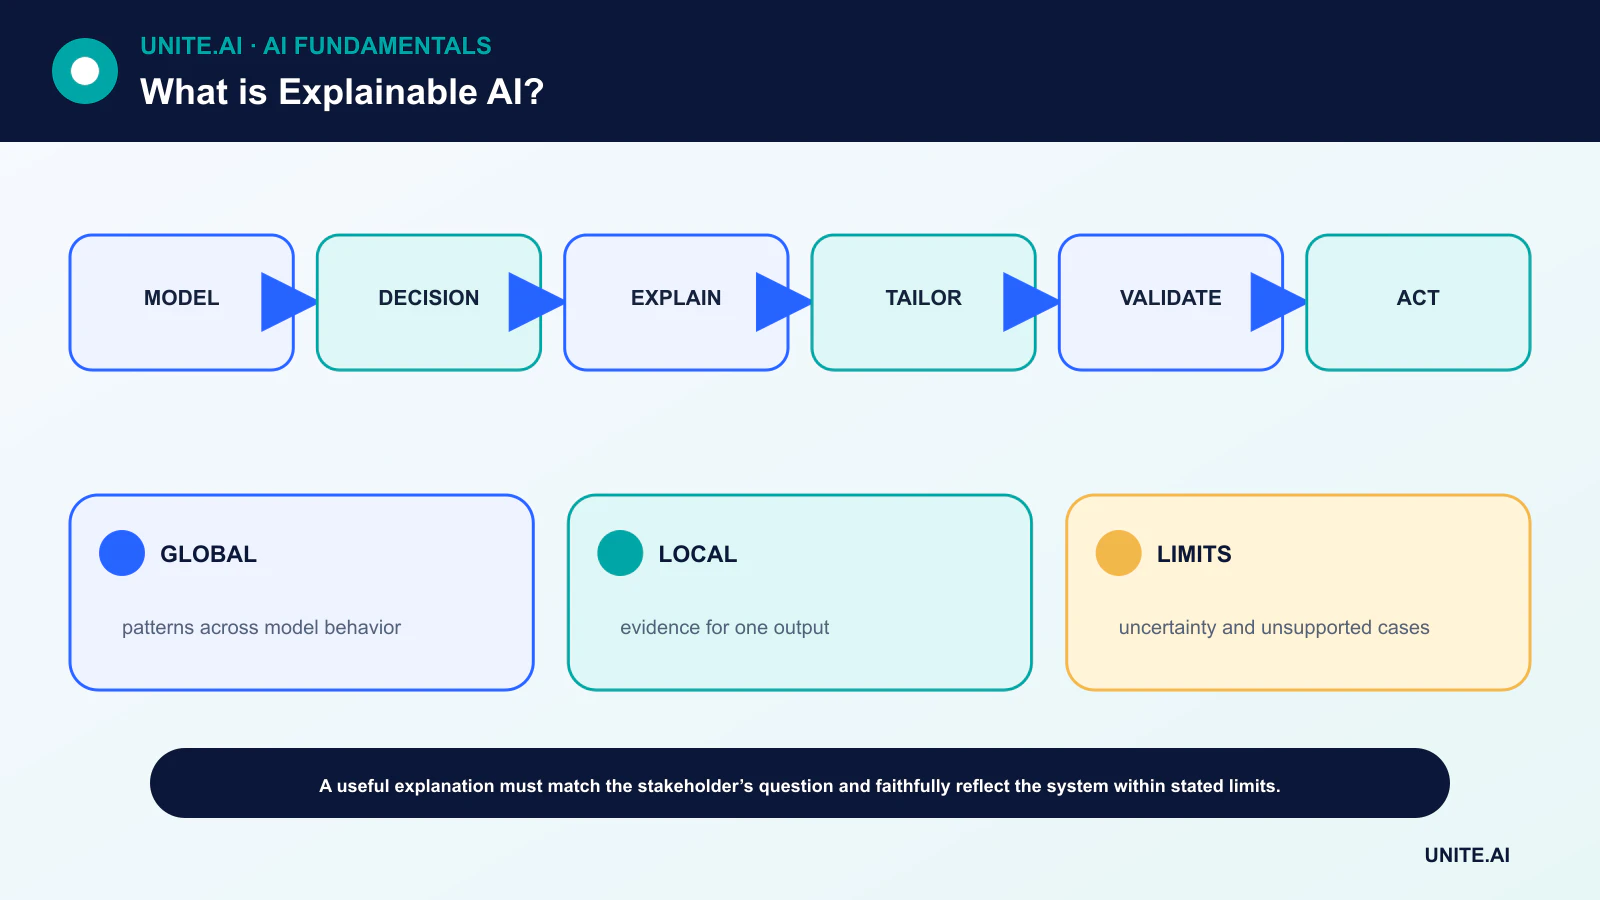
- Глобальные методы суммируют модель, тогда как локальные методы рассматривают отдельное предсказание или небольшую область.
- Постхок‑объяснения могут быть полезными, но могут быть нестабильными или неточными относительно исходной модели.
- Объяснение не доказывает справедливость, причинно‑следственную связь, надёжность или правильность.
Четыре принципа полезных объяснений
NIST предлагает, чтобы система предоставляла объяснение, делала его значимым для целевого пользователя, гарантировала точное отражение процесса системы и сообщала о своих ограничениях в знаниях. Эти принципы отделяют наличие объяснения от его качества.
Смысл зависит от аудитории. Краткий код причины может помочь заявителю, тогда как разработчику модели могут потребоваться распределения, поведение признаков и кластеры ошибок. Оба должны быть связаны с одной и той же задокументированной системой и контекстом решения.
Внутренние и постхок‑методы
Разреженная линейная модель или ограниченное дерево решений могут быть непосредственно интерпретируемыми в пределах их допустимого диапазона. Сложная модель может использовать постхок‑атрибуцию признаков, локальный суррогат, примеры, карты значимости или контрфакты.
Внутренняя простота не гарантирует достоверность, если признаки плохо определены или конвейер скрыт. Сложность постхок‑методов не автоматически вводит в заблуждение. Метод необходимо проверять в контексте вопроса, на который он предназначен отвечать.
Атрибуция признаков и коррелированные входы
Методы атрибуции распределяют части вывода по входным признакам при явных предположениях. LIME подгоняет простой локальный суррогат вокруг предсказания; методы, связанные с SHAP, связывают аддитивные атрибуции с концепциями значений Шепли.
Коррелированные признаки могут делить или обмениваться атрибуцией, и высокая атрибуция не является причинным эффектом. Изменение признака в изоляции может создать невозможный профиль человека, изображение или транзакцию. Объяснения должны указывать базовую линию, метод выборки и предположения о зависимости.
Контрфакты, примеры и глобальное поведение
Контрфакт задаёт вопрос, какое выполнимое изменение изменит результат. Ограничения имеют решающее значение: практическое объяснение не должно рекомендовать неизменяемые, незаконные или нереалистичные изменения. Методы, основанные на примерах, показывают прототипы или влиятельные обучающие случаи, но могут раскрывать личные данные.
Глобальный анализ изучает производительность, частичную зависимость, монотонность, взаимодействия и поведение подгрупп. Для ансамблей, таких как градиентный бустинг, комбинируйте резюме с локальными доказательствами и прямыми тестами ожидаемых ограничений.
Проверка объяснения и системы
Тестируйте достоверность, стабильность при небольших возмущениях, согласованность между эквивалентными входами, понимание пользователем и то, поддерживает ли объяснение соответствующее решение. Адаптивные тесты должны проверять, может ли убедительное объяснение сопровождать неверный или поддельный вывод.
XAI входит в более широкую оценку: отложенное качество, калибровка, справедливость, конфиденциальность, безопасность, мониторинг и механизмы обжалования. Объяснение может поддерживать подотчётность, но не может заменить подотчётное управление.
Цели объяснения и семейства методов
Explainable AI должна начинаться с вопроса и аудитории: почему произошло конкретное решение, как в целом ведёт себя модель, какие доказательства повлияли на неё, что изменит результат, или соблюдалась ли политика. Локальные объяснения рассматривают одно предсказание; глобальные объяснения суммируют более широкое поведение. Внутренне интерпретируемые модели раскрывают коэффициенты, правила или структуры, тогда как постхок‑методы приближают сложные модели. Объяснение поведения модели не автоматически является причинным объяснением мира или оправданием справедливости решения.
Методы атрибуции признаков включают градиенты, интегрированные градиенты, значения в стиле SHAP, перестановку и локальные суррогатные модели. Объяснения, основанные на примерах, извлекают влиятельные или похожие случаи; контрфакты предлагают изменения, связанные с другим выводом; концептуальные методы связывают внутренние представления с человеческими категориями. Каждый из них имеет предположения о базовых линиях, независимости признаков, локальной линейности или доступе к модели. Коррелированные переменные, взаимодействия и предобработка могут делать атрибуции нестабильными или вводящими в заблуждение. Сравнивайте методы и изменяйте входы, чтобы проверить, предсказывает ли объяснение поведение.
Оценка и человеческие факторы
Оценивайте достоверность — насколько объяснение соответствует модели — отдельно от правдоподобия для человека. Тестируйте стабильность, чувствительность, полноту, разреженность и полезность для конкретной задачи, такой как отладка или обжалование. Человеческие исследования требуют репрезентативных участников и должны измерять качество решений, обнаружение ошибок, степень доверия и время, а не то, считают ли пользователи график понятным. Убедительное объяснение может повысить доверие к неверной модели, поэтому интерфейсы должны показывать неопределённость, альтернативы и ограничения.
Контрфакты должны быть выполнимыми, практичными и не рекомендовать изменение защищённых или неизменяемых характеристик. Объяснения могут утекать модельную или личную информацию и помогать злоумышленникам обратным инжинирингом решений. Применяйте контроль доступа и минимизацию вывода. Для регулируемых или высоко‑влияющих применений сохраняйте происхождение данных, версию модели, порог и фактическую логику решения; общая графика важности признаков не может заменить юридически значимую причину или человеческую проверку.
Ответственное использование объяснений
Выбирайте самую простую модель, отвечающую требованиям к производительности и эксплуатации, но не жертвуйте валидностью ради поверхностной интерпретируемости. Сочетайте объяснения с тестированием подгрупп, проверками надёжности, причинным анализом при необходимости и мониторингом результатов. Документируйте целевую аудиторию и недопустимые выводы. Если объяснение меняется после безвредного возмущения, исследуйте это до развёртывания. Объяснимость — это доказательство о системе, полученное с помощью метода; она полезна для отладки, надзора и коммуникации, но не подтверждает истинность, справедливость, безопасность или понимание.
Практический пример: объяснение модели кредитного риска
Кредитор сначала определяет аудиторию и требуемую причину: заявителям нужны точные факторы решения и путь исправления, тогда как разработчикам требуются диагностические данные. Калиброванная интерпретируемая базовая модель сравнивается с бустинговой моделью. Локальная атрибуция, контрфакты и глобальный анализ ошибок тестируются на достоверность, стабильность, поведение коррелированных признаков и полезность. Объяснения не могут рекомендовать изменение возраста, инвалидности или другой неизменяемой характеристики и не представляются как причинные эффекты.
Запись о производственном решении сохраняет исходные данные, трансформацию признаков, модель, порог, политику и действия человека. Заявители могут оспорить некорректные данные и получить значимый пересмотр. Мониторинг проверяет стабильность результатов и объяснений по группам и обновлениям модели. Если правдоподобное объяснение меняется при безвредном возмущении признака или упускает решающее правило политики, развертывание прекращается. Объяснимость дополняет валидацию и процедурные права; она не оправдывает недействительную цель, дискриминационные результаты или отсутствие подотчётного человеческого контроля.
Доказательства внедрения и готовность к эксплуатации
Производственное решение требует большего, чем успешная демонстрация. Определите целевых пользователей, эксплуатационную среду, входы, выходы, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базовую линию и версионированный набор оценок до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входные данные, сдвиг распределения, отказ зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждую трансформацию и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развёртывание, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно внедрёнными сбоями. Оперативная телеметрия должна показывать качество входов, поведение выходов, версию модели или правила, состояние зависимостей, вмешательства человека и подтверждённые результаты без сбора ненужных конфиденциальных данных. Определите пороги тревоги и ответственного за реакцию, затем после развертывания проверяйте реальные доказательства, а не полагайтесь на сохранение офлайн‑производительности. Переоценивайте при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также требует документированного восстановления, обучения на инцидентах, процедур удаления и хранения, а также чёткой точки, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Являются ли карты внимания объяснениями?
Они могут быть диагностическими сигналами, но веса внимания сами по себе не гарантируют точного представления причин вывода модели.
Требует ли объяснимый ИИ простую модель?
Не всегда. Сложные модели можно анализировать с помощью постхок‑методов, но такие объяснения требуют независимой валидации и чётко указанных ограничений.
Основные ссылки