
Основы ИИ
Обучение с учителем vs обучение без учителя

 Добавьте Unite.AI в избранные источники в Google
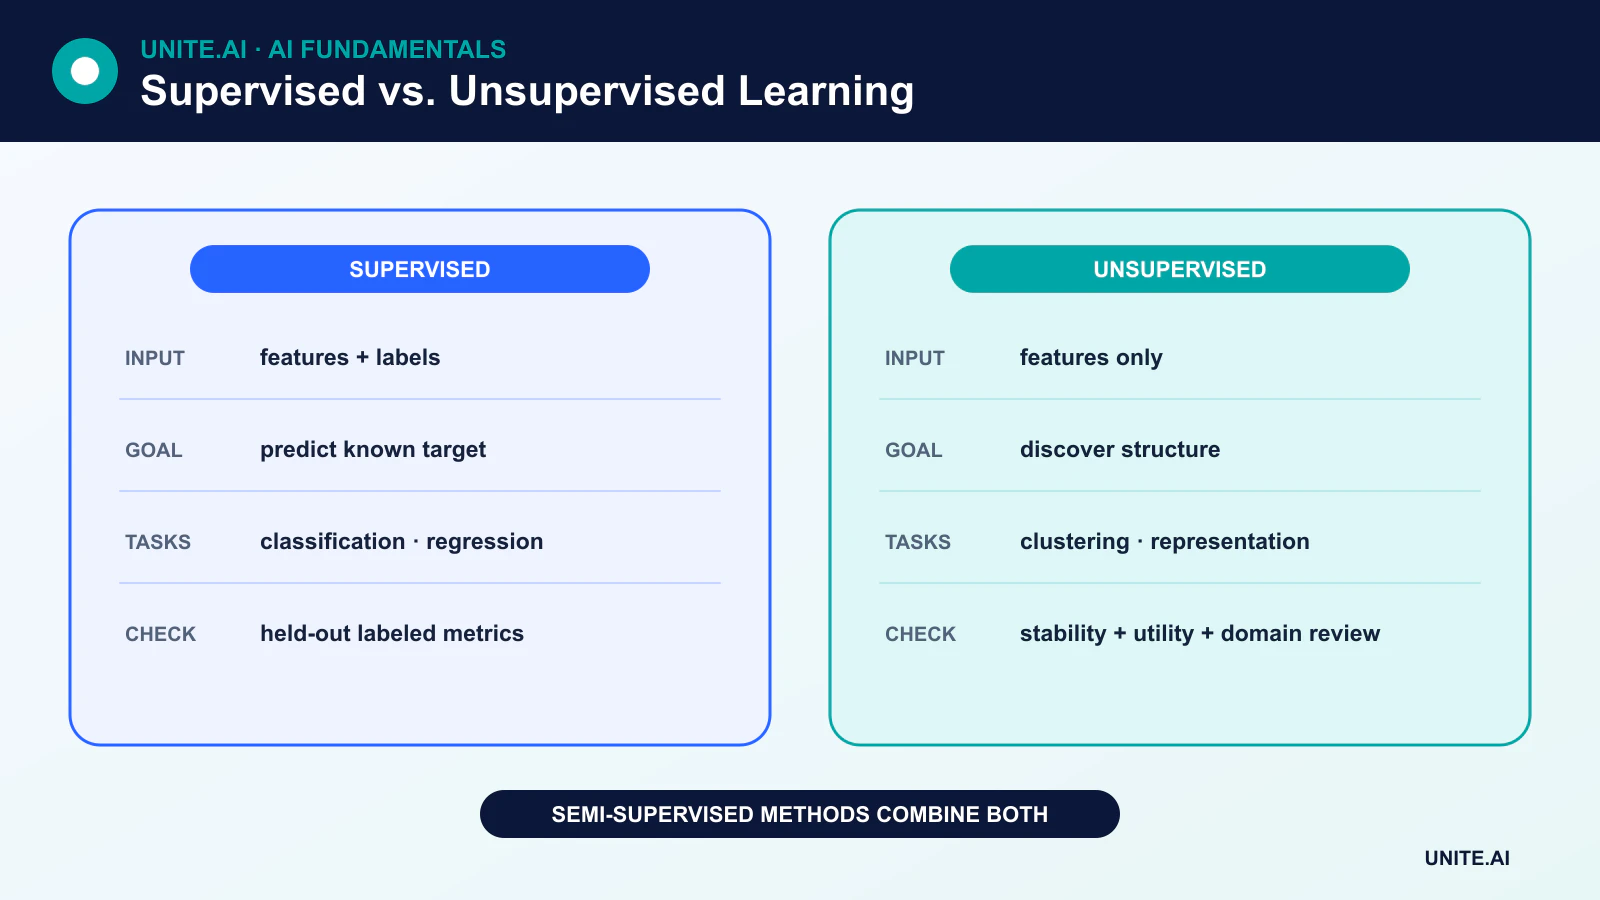
Обучение с учителем обучается на примерах, сопоставленных с целевыми ответами. Обучение без учителя ищет структуру в данных без целевых меток. Разница заключается не в том, какой подход более интеллектуален или точен; а в типе доступного сигнала обучения и в вопросе, на который система предназначена отвечать.
Это два основных парадигмы в рамках машинного обучения, однако современные системы также используют полунаблюдаемое, самонаблюдаемое и обучение с подкреплением.
Ключевые выводы
- Обучение с учителем предсказывает известную цель; обучение без учителя обнаруживает шаблоны или представления.
- Классификация и регрессия — задачи обучения с учителем; кластеризация, оценка плотности и многие методы уменьшения размерности — задачи обучения без учителя.
- Выходы обучения без учителя не являются автоматически реальными классами и могут быть сложнее в оценке.
- Стоимость вычислений и точность зависят от алгоритма, данных, задачи и оценки — а не только от парадигмы.
Как работает обучение с учителем
Набор данных для обучения с учителем содержит признаки X и цель y. Обучение настраивает модель так, чтобы её предсказания приближались к целям. Оценка использует отложенные помеченные примеры для оценки того, насколько хорошо модель обобщается.
Классификация
Классификация предсказывает категорию: спам или не спам, одну тему документа среди нескольких, или один или несколько объектов на изображении. Важные метрики включают точность (precision), полноту (recall), F1, калибровку и меры, чувствительные к стоимости. Точность может вводить в заблуждение, когда один класс редок; матрица ошибок показывает, какие классы путаются.
Регрессия
Регрессия предсказывает непрерывное значение, например спрос, продолжительность или температуру. Линейная регрессия может использовать один или несколько признаков; она не ограничивается построением зависимости между двумя переменными. Метрики регрессии включают среднюю абсолютную ошибку, корень из средней квадратичной ошибки и специфические для задачи затраты.
Распространённые алгоритмы обучения с учителем
Методы обучения с учителем включают линейные и логистические модели, деревья решений, случайные леса, градиентный бустинг, машины опорных векторов, k-ближайших соседей и нейронные сети.
Логистическая регрессия выдаёт оценку или вероятность, которую можно преобразовать в класс с помощью выбранного порога. Лист дерева решений содержит предсказание, основанное на регионе пространства признаков, а не обязательно на одной обучающей наблюдении. k‑ближайшие соседи предсказывают на основе близких помеченных обучающих примеров и всё ещё требуют надёжного дизайна разделения на обучение/валидацию/тест.
Как работает обучение без учителя
Обучение без учителя получает признаки без целевого столбца. Его цель определяется косвенно — например, минимизировать расстояние внутри кластеров, восстанавливать входные данные, оценивать плотность данных или сохранять как можно большую дисперсию при уменьшении размерности.
Кластеризация
K‑means распределяет точки по выбранному числу кластеров и обновляет центры кластеров, чтобы уменьшить квадратичное расстояние внутри кластера. Алгоритм обнаруживает геометрические группы при заданной метрике расстояния и представлении признаков. Эти группы не автоматически соответствуют значимым типам клиентов, диагнозам или другим меткам домена.
Уменьшение размерности
Уменьшение размерности представляет данные с помощью меньшего числа переменных. Метод главных компонент (PCA) находит ортогональные направления, сохраняющие как можно большую дисперсию при линейной проекции. Другие методы сохраняют разные представления структуры и могут давать совершенно разные визуализации.
Аномалии и оценка плотности
Методы без учителя могут оценивать плотность данных и помечать необычные наблюдения. Оценка аномалии не доказывает мошенничество, сбой или вредоносное поведение; она лишь выявляет отклонение в выбранном представлении и модели.
Как оценивается обучение без учителя
Нет универсального понятия «точности» обучения без учителя. Практик может использовать внутренние метрики, такие как силуэт, сравнивать стабильность по образцам, проверять полезность в последующей задаче или спрашивать экспертов домена, имеет ли обнаруженная структура смысл. Если для оценки существуют истинные метки, можно применять внешние метрики кластеризации, не превращая процесс обучения в обучение с учителем.
За пределами двустороннего сравнения
Полунаблюдаемое обучение
Полунаблюдаемое обучение сочетает небольшой набор помеченных данных с большим набором непомеченных. Примерами являются псевдо‑метки, регуляризация согласованности и методы на графах. Непомеченные данные всё же должны достаточно близко соответствовать целевому распределению, чтобы быть полезными.
Самонаблюдаемое обучение
Самонаблюдаемое обучение выводит цели из самого входа, например предсказывая скрытые токены или сопоставляя преобразованные представления. Это фундамент современных языковых, визуальных и мультимодальных моделей, включая трансформеры.
Обучение с подкреплением
Обучение с подкреплением оптимизирует решения посредством наград, генерируемых взаимодействием. Оно отличается как от предсказаний по меткам, так и от статического обнаружения шаблонов.
Выбор правильного подхода
Начните с решения или инсайта, который система должна предоставить. Если существуют надёжные цели и цель — предсказание, обучение с учителем естественно. Если цель — исследование, представление или группировка, может подойти метод без учителя. Когда меток мало, предварительное обучение самонаблюдаемым или полунаблюдаемым способом с последующей оценкой в режиме обучения с учителем может быть более эффективным.
В любом случае утечка данных, смещенная выборка, слабые прокси и сдвиг распределения могут определять выбор алгоритма. Технически корректная модель, обученная на неверной цели, всё равно может провалиться.
Сигналы обучения, цели и представительные методы
Обучение с учителем использует примеры, сопряжённые с целевыми метками или значениями, и оптимизирует предсказательную ошибку. Классификация, регрессия, ранжирование и структурное предсказание различаются по выходу и функции потерь. Обучение без учителя ищет структуру без целевых меток через кластеризацию, оценку плотности, уменьшение размерности, обучение представлениям или генеративное моделирование. Самонаблюдаемое обучение создаёт цели предсказания из самих данных, тогда как полунаблюдаемое обучение сочетает небольшой помеченный набор с большим непомеченным. Эти категории описывают сигнал обучения; одинаковая нейронная архитектура может быть обучена в нескольких парадигмах.
Метки делают цель явной, но вводят затраты на разметку, шум, предположения политики и временную задержку. Непомеченные данные легче собрать, но они не указывают алгоритму, какая обнаруженная структура полезна. Кластер может отражать освещение, длину документа или источник получения, а не значимую категорию. Оценку следует определять независимо: модели с учителем используют отложенные помеченные результаты, тогда как модели без учителя требуют стабильности, восстановления, правдоподобия, поиска, полезности в последующей задаче или экспертной валидации. Одно лишь визуальное разделение не доказывает корректность структуры.
Выбор парадигмы и предотвращение типичных ошибок
Применяйте обучение с учителем, когда существует стабильная цель и репрезентативные метки. Используйте обучение без учителя для суммирования, обнаружения новизны, сжатия или генерации гипотез, но рассматривайте результаты как предварительные. Предобучение самонаблюдаемым способом ценно, когда сырые данные в избытке и последующие задачи используют те же представления. Полунаблюдаемые методы помогают только при выполнении предположений о непомеченных данных и структуре классов. Сравнивайте с простыми базовыми моделями и учитывайте общие затраты на сбор, разметку, проверку, вычисления и ошибки, а не полагайтесь на то, что непомеченные данные автоматически дешевые.
Предотвращайте утечки, разделяя связанные сущности до создания меток, аугментаций или псевдо‑меток. Следите за балансом классов, согласованностью разметки, стабильностью кластеров, их схлопыванием и дрейфом. Псевдо‑метки могут закреплять ранние ошибки; кластеризация может кодировать чувствительные атрибуты; предварительно обученное представление может переносить исходный смещённый характер. Человеческая проверка должна сосредотачиваться на граничных случаях и их последствиях. В продакшене документируйте, как был создан сигнал обучения и когда он устареет. Парадигма определяет, где в системе появляется надзор, а не отсутствие человеческих решений и ценностей.
Практический пример: обнаружение и маркировка тем поддержки
Компания сначала использует несупервизированные эмбеддинги и кластеризацию для исследования тем в анонимных сообщениях поддержки. Аналитики изучают репрезентативные и граничные примеры и обнаруживают, что некоторые кластеры отражают длину сообщения и канал, а не проблему. Затем они разрабатывают супервизированную таксономию с неизвестным классом, руководством по разметке и измеренным согласием. Классификатор затем оценивается на более поздних периодах, языках и продуктах в сравнении с базовыми подходами на основе ключевых слов и ближайших соседей.
Непомеченные новые сообщения позволяют обнаруживать дрейф, но не переобучают классификатор автоматически. Рецензенты маркируют выбранные неопределённые и новые случаи через активное обучение, с проверками качества и закрытым набором для оценки. Мониторинг отслеживает распространённость тем, уверенность, разногласия и результаты маршрутизации. При запуске нового продукта таксономия и возможности последующих команд обновляются совместно. Рабочий процесс использует методы без учителя для генерации гипотез и супервизированные доказательства для операционной маршрутизации.
Доказательства внедрения и готовность к эксплуатации
Производственное решение требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочую среду, входы, выходы, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базовую линию и версионированный набор для оценки до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входы, сдвиг распределения, отказ зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Измеряйте качество задачи совместно с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развёртывание, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно введёнными сбоями. Оперативная телеметрия должна показывать качество входов, поведение выходов, версию модели или правила, состояние зависимостей, вмешательства людей и подтверждённые результаты без сбора лишних конфиденциальных данных. Определите пороги тревоги и ответственного за реакцию, затем проверяйте реальные доказательства после внедрения, а не полагайтесь на то, что офлайн‑производительность сохранится. Переоценивайте систему при изменении источников данных, пользователей, моделей, поставщиков, политик, аппаратуры или целей. Поддерживаемая система также требует документированного восстановления, обучения на инцидентах, процедур удаления и хранения, а также чёткой точки, в которой её следует отключить или заменить.
Основные ссылки












