
Основы ИИ
Что такое опорные векторные машины?

 Добавьте Unite.AI в избранные источники в Google
Метод опорных векторов (SVM) — это метод обучения с учителем, который находит границу решения с максимально возможным зазором между классами. Обучающие примеры, определяющие эту границу, называются опорными векторами.
SVM может выполнять линейную и нелинейную классификацию, регрессию и обнаружение новизны. Метод особенно полезен для малых и средних наборов данных с информативными признаками, включая многомерные разреженные данные, но стоимость обучения может стать непрактичной на очень больших выборках.
Ключевые выводы
- SVM максимизирует минимальный зазор между границей и ближайшими обучающими точками.
- Опорные векторы — это точки данных, а не дополнительные гиперплоскости.
- Параметр C уравновешивает ширину зазора и штрафы за нарушения.
- Ядра вычисляют сходство в неявном пространстве признаков, не материализуя явно каждый преобразованный признак.
Идея максимального зазора
Для линейного бинарного классификатора границей решения служит гиперплоскость:
w · x + b = 0
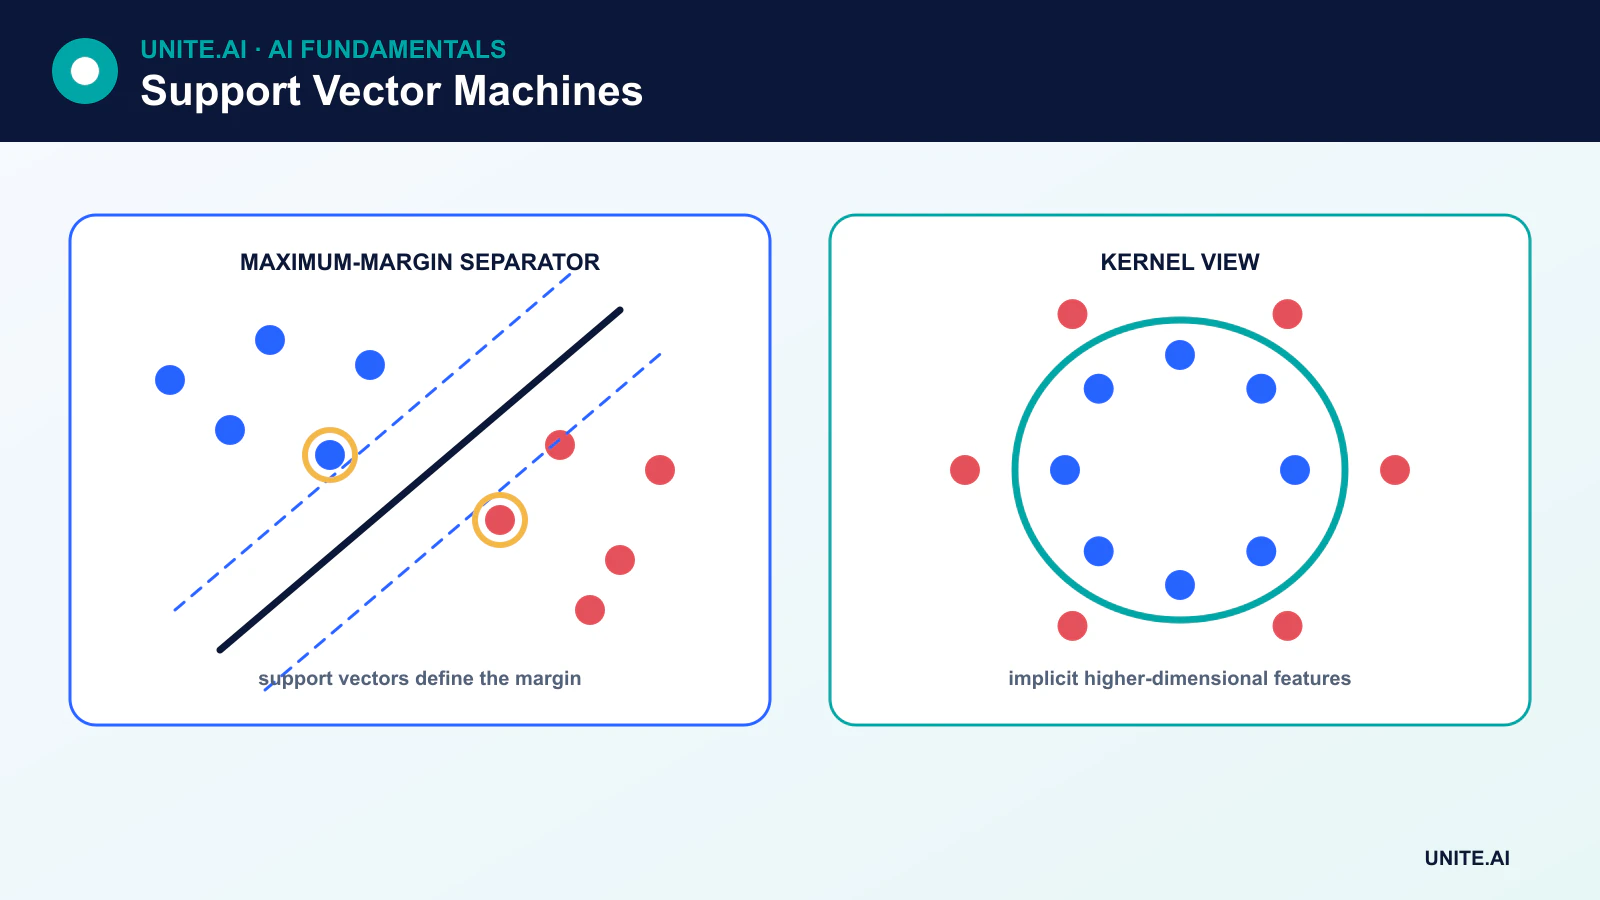
Вектор w задаёт ориентацию, а b — смещение. Обучающие классы могут разделять многие гиперплоскости. SVM выбирает ту, которая максимизирует расстояние до ближайших примеров с обеих сторон. Эти ближайшие примеры и есть опорные векторы; именно они сильнее всего влияют на найденную границу.
Цель состоит не в том, чтобы независимо максимизировать расстояние от границы до каждой точки. SVM максимизирует минимальный зазор, одновременно соблюдая ограничения классов или назначая штрафы за их нарушение.
Жёсткий и мягкий зазор
SVM с жёстким зазором требует идеальной линейной разделимости и чувствителен к выбросам. Для реальных данных обычно нужен мягкий зазор, вводящий переменные ошибок для наблюдений внутри зазора или по неверную сторону границы.
Гиперпараметр C управляет штрафом за такие нарушения:
- Большее значение C сильнее штрафует нарушения и часто создаёт более узкий зазор, точнее повторяющий обучающие примеры.
- Меньшее значение C допускает больше нарушений в обмен на более широкий и сильнее регуляризованный зазор.
Число опорных векторов определяется данными и решением задачи; увеличение C не гарантирует конкретного количества опорных векторов.
Ядерный трюк
Некоторые классы нельзя разделить прямой гиперплоскостью в исходном пространстве признаков. Ядро вычисляет скалярное произведение, соответствующее другому пространству признаков. Благодаря этому SVM строит нелинейную границу без явного вычисления каждой преобразованной координаты.
К распространённым ядрам относятся:
- Линейное: эффективно для многомерных разреженных признаков, например текста.
- Полиномиальное: моделирует взаимодействия до выбранной степени.
- Радиально-базисная функция (RBF): создаёт гибкие локальные границы на основе расстояния.
- Сигмоидальное: напоминает нейронную активацию, но реже выбирается по умолчанию.
В SVM с ядром RBF параметр gamma определяет, насколько локально каждый обучающий пример влияет на границу. Большое gamma может создавать чрезмерно подробные области и приводить к переобучению; малое gamma формирует более плавное влияние.
Многоклассовая классификация
Классическая целевая функция SVM бинарна. Библиотеки расширяют её стратегиями один против остальных, где обучается по одному классификатору на класс, или один против одного, где классификаторы обучаются для пар классов, а их решения объединяются. Многоклассовый SVM не сводится к рисованию на одну линию меньше, чем число классов.
Регрессия опорных векторов и одноклассовый SVM
Регрессия опорных векторов (SVR) аппроксимирует функцию, игнорируя ошибки внутри коридора шириной эпсилон и штрафуя более крупные отклонения. Одноклассовый SVM оценивает границу вокруг типичных данных и может использоваться для обнаружения новизны. Необычная точка не обязательно означает мошенничество или сбой; она лишь нетипична для выученного представления.
Практические требования
SVM зависит от расстояний и скалярных произведений, поэтому числовые признаки обычно требуется масштабировать. Параметры C, ядро, gamma и веса классов следует выбирать с помощью валидации. Вероятностные оценки не являются свойством самого зазора и часто требуют отдельной калибровки, которая увеличивает стоимость и должна оцениваться независимо.
Обучение ядерного SVM может иметь квадратичную или кубическую сложность по числу примеров в зависимости от данных и реализации. Для очень больших наборов лучше подходят линейные варианты SVM или стохастические линейные модели. Для необработанных изображений, аудио или языка эффективнее могут быть представления, выученные с помощью глубокого обучения, хотя SVM по-прежнему способен классифицировать фиксированные эмбеддинги.
Сильные стороны и ограничения SVM
SVM может хорошо работать с большим числом признаков, имеет ясную регуляризованную целевую функцию и при прогнозировании опирается главным образом на опорные векторы. К ограничениям относятся чувствительность к масштабированию и гиперпараметрам, потенциально дорогое обучение, меньшая интерпретируемость нелинейных ядер и необходимость калибровки вероятностей.
Зазоры, ядра и цель оптимизации
Метод опорных векторов ищет разделяющую гиперплоскость с большим зазором между классами. Границу определяют только опорные векторы на зазоре или внутри него. SVM с мягким зазором вводит послабления для перекрывающихся и ошибочно размеченных точек; параметр C задаёт компромисс между более широким зазором и нарушениями на обучении. Входные данные обычно следует масштабировать, потому что решение определяется расстояниями и скалярными произведениями. Веса классов или повторная выборка помогают при неодинаковой стоимости ошибок и распространённости классов, но пороги и вероятности всё равно требуют отдельной проверки.
Ядерный трюк вычисляет сходство так, как если бы входы были отображены в пространство большей размерности. Линейные, полиномиальные, радиально-базисные и специализированные ядра кодируют разные предположения. Для ядра RBF gamma определяет локальность влияния точки: высокое gamma может создавать сложные области и переобучаться, а низкое — недообучаться. Матрица ядра растёт квадратично с числом примеров, поэтому нелинейные SVM дороги на больших данных. В масштабе часто предпочтительны линейные решатели или приближённые отображения признаков.
Многоклассовое применение, калибровка и эксплуатационные ограничения
Бинарные SVM расширяют до нескольких классов с помощью схем один против остальных, один против одного или структурированных формулировок. Гиперпараметры нужно настраивать внутри кросс-валидации, используя при необходимости групповые или временные разбиения. Следует оценивать точность и полноту по каждому классу, распределения зазоров, калибровку и поведение при сдвиге данных. Необработанные оценки решающей функции не являются вероятностями; масштабирование Платта или изотоническая калибровка используют отдельные данные и могут ухудшаться при изменении распространённости классов. Сравнивайте метод с логистической регрессией, деревьями и современными подходами на основе представлений при одинаковых усилиях по обработке данных и настройке.
Для эксплуатации необходимы точные версии масштабирования, порядка признаков, параметров ядра, опорных векторов и сопоставления классов. Стоимость предсказания ядерного SVM растёт с числом опорных векторов, поэтому задержку и память нужно измерять на реалистичных пакетах. Входы, далёкие от обучающей выборки, всё равно могут получать уверенные метки; при необходимости добавьте обнаружение выхода за распределение или политику отказа от ответа. Проверяйте ошибки на чувствительные косвенные признаки и артефакты данных. SVM остаётся сильным выбором для средних по размеру многомерных задач, но максимальный геометрический зазор не доказывает причинность или безопасность.
Практический пример: SVM для маршрутизации редких документов
Юридическая операционная группа классифицирует короткие документы по категориям маршрутизации с помощью признаков TF–IDF и линейного SVM. Разбиение выполняется по делу и времени, чтобы шаблоны не просачивались между выборками; веса классов настраиваются с учётом проверенной стоимости ошибок, а C подбирается внутри вложенной валидации. Линейную модель сравнивают с логистической регрессией и трансформером. Точность, полнота, калибровка и нагрузка на проверяющих по каждому классу важнее общей доли правильных ответов.
Оценки решающей функции калибруются на отдельных данных, а документы с малым зазором или неподдерживаемым языком направляются на ручной приём. Производственный артефакт включает токенизатор, словарь, веса, модель, калибровку и карту меток. Мониторинг отслеживает новые термины, распространённость категорий, зазоры и исправленные маршруты. Документы и опорные векторы защищаются, поскольку текстовые признаки могут раскрывать конфиденциальную информацию. Нелинейное ядро отвергается, если небольшой прирост качества не оправдывает задержку, память и потерю интерпретируемости.
Доказательства реализации и готовность к эксплуатации
Для решения о промышленном запуске недостаточно успешной демонстрации. Определите целевых пользователей, рабочую среду, входы, выходы, зависимости, владельца и последствия каждого существенного отказа. До настройки создайте воспроизводимый базовый вариант и версионируемый оценочный набор. Проверяйте обычные случаи, граничные условия, повреждённые или отсутствующие входы, сдвиг распределения, отказ зависимостей, злоупотребления, а также группы и среды с наибольшим риском недостаточного обслуживания. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, приватностью и безопасностью. Фиксируйте каждое преобразование и порог, чтобы независимый эксперт мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
До запуска распределите полномочия по выпуску, исключениям, изменениям, откату и выводу из эксплуатации. Используйте поэтапное развёртывание, сохраняйте безопасный резервный вариант и проверяйте мониторинг с помощью намеренно внесённых сбоев. Операционная телеметрия должна показывать качество входов, поведение выходов, версию модели или правил, состояние зависимостей, вмешательства человека и подтверждённые результаты, не собирая лишних чувствительных данных. Задайте пороги оповещений и владельца реагирования, а после запуска анализируйте реальные свидетельства вместо предположения, что офлайн-качество сохранится. Переоценивайте систему при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемой системе также нужны документированное восстановление, разбор инцидентов, процедуры удаления и хранения данных и ясное условие отключения или замены.
Часто задаваемые вопросы
SVM выполняет только классификацию?
Нет. Регрессия опорных векторов предсказывает непрерывные целевые значения, а одноклассовый SVM может оценивать границу новизны. У каждого варианта своя целевая функция и набор гиперпараметров.
Когда линейный SVM является сильным выбором?
Линейные SVM часто эффективны для многомерных разреженных признаков, включая традиционные текстовые представления, где гибкое ядро увеличило бы стоимость без явной пользы.
Основные источники












