
Основы ИИ
Что такое линейная регрессия?

 Добавьте Unite.AI в избранные источники в Google
Линейная регрессия моделирует непрерывную целевую переменную как линейную комбинацию одного или нескольких входных признаков. Она используется для предсказания, оценки и как прозрачный базовый уровень для понимания, добавляет ли более сложная модель значимую ценность.
Термины независимая переменная и зависимая переменная описывают роли в модели, а не доказанную причинно-следственную связь. Регрессия может выявлять ассоциацию, хотя конфаундинг, отбор, обратная причинность или ошибка измерения объясняют связь.
Ключевые выводы
- Целевая переменная y моделируется из входных признаков X; в более старой версии статьи эти метки были перепутаны в одном объяснении формулы.
- Метод обычных наименьших квадратов минимизирует сумму квадратов остатков.
- Диагностика остатков и предположения важны для вывода и оценки неопределённости.
- Регуляризация Ridge и Lasso помогает, когда предикторов много или они коррелированы.
Простая линейная регрессия
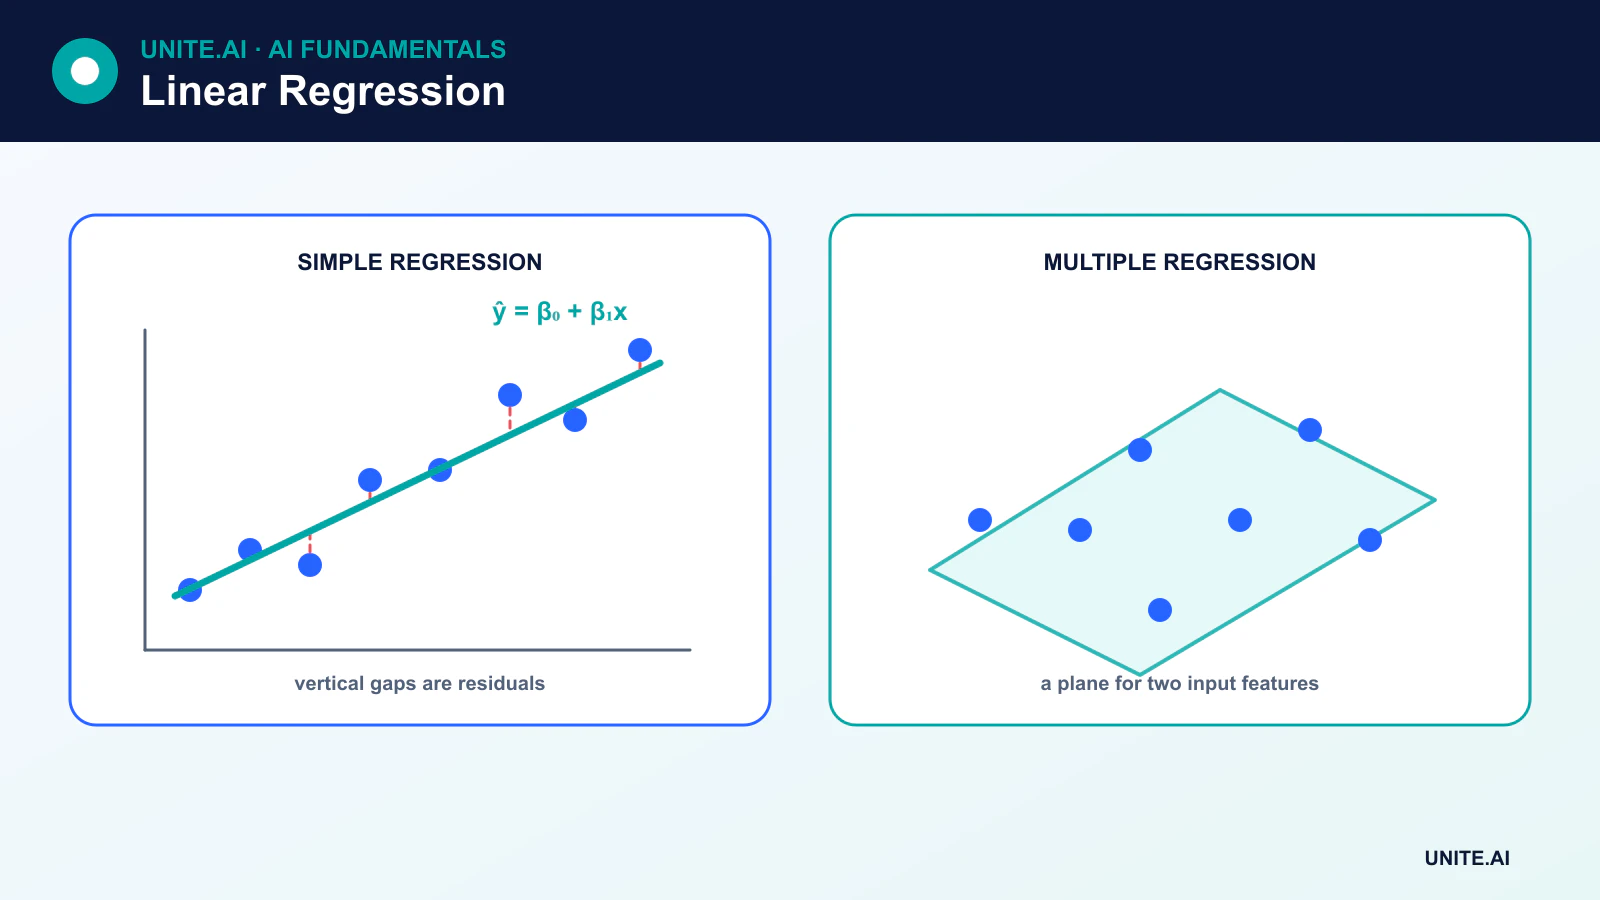
При наличии одного признака модель выглядит так:
ŷ = β₀ + β₁x
β₀ — это свободный член, а β₁ — наклон. Остаток для наблюдения i равен yᵢ - ŷᵢ. Метод обычных наименьших квадратов (OLS) выбирает коэффициенты, минимизирующие сумму квадратов остатков.
Наклон оценивает ожидаемое изменение целевой переменной, связанное с изменением признака на одну единицу в построенной модели. Его нельзя трактовать как причинный эффект, если дизайн исследования и предположения не поддерживают причинную идентификацию.
Множественная линейная регрессия
При наличии p признаков:
ŷ = β₀ + β₁x₁ + β₂x₂ + … + βₚxₚ
Каждый коэффициент интерпретируется условно, учитывая остальные включённые признаки. Множественная регрессия может включать категориальные переменные через кодирование, полиномиальные члены и взаимодействия. Она остаётся «линейной», потому что линейна по коэффициентам, даже если в неё входят преобразованные признаки, такие как x².
Предположения и диагностика
Для предсказания основной вопрос — насколько хорошо модель обобщается. Для классических тестов коэффициентов и их доверительных интервалов важны дополнительные предположения:
- Линейность: условное среднее представлено выбранной линейной формой.
- Независимые или корректно смоделированные ошибки: повторные, сгруппированные, пространственные или временные наблюдения могут требовать иной структуры ошибок.
- Постоянная дисперсия ошибок: гетероскедастичность влияет на стандартные ошибки и оценки неопределённости.
- Ограниченная мультиколлинеарность: сильно коррелированные предикторы делают отдельные коэффициенты нестабильными.
- Распределение остатков: нормальность важна для некоторых выводов при небольших выборках, но не является требованием, чтобы каждый признак был нормально распределён.
Графики остатков, меры рычагов и влияния, а также экспертный обзор могут выявлять выбросы, нелинейность, меняющуюся дисперсию или наблюдения, доминирующие в подгонке.
Оценка предсказаний
- Средняя абсолютная ошибка (MAE) — среднее абсолютное значение остатков.
- Среднеквадратичная ошибка (MSE) придаёт больший вес более крупным ошибкам.
- Корень среднеквадратичной ошибки (RMSE) переводит квадратную ошибку обратно в единицы целевой переменной.
- R² сравнивает вариацию остатков с постоянным базовым уровнем на оценочных данных.
R² не измеряет точность, не устанавливает причинность и может быть отрицательным на отложенных данных. Валидация должна соответствовать реальному сценарию предсказания, включая временные или групповые разбиения при необходимости.
Ridge, lasso и elastic net
Ridge‑регрессия добавляет L2‑штраф, который сжимает коэффициенты и стабилизирует коррелированные предикторы. Lasso добавляет L1‑штраф и может обнулять коэффициенты. Elastic net сочетает оба подхода. Обычно признаки требуют совместимого масштабирования перед сравнением этих штрафов.
Регуляризация вводит смещение в обмен на снижение дисперсии и может уменьшать переобучение. Сила штрафа подбирается с помощью валидации, а не на финальном тестовом наборе.
Когда линейная регрессия — неверный инструмент
Линейная модель может провалиться, когда зависимости сильно нелинейны, ошибки зависят от прошлых значений, распределения целевой переменной требуют специализированного моделирования, или несколько выбросов доминируют над квадратичной потерей. Деревья решений, обобщённые линейные модели, модели временных рядов, робастная регрессия или нелинейные методы могут подойти лучше.
Даже когда более сложная модель выигрывает, линейная регрессия остаётся ценным базовым уровнем. Если крупная система не может надёжно превзойти её, добавленная сложность может не оправдываться.
Предположения модели, оценка и диагностика
Линейная регрессия моделирует условное среднее числового результата как свободный член плюс взвешенные предикторы. Метод обычных наименьших квадратов выбирает коэффициенты, минимизирующие квадраты остатков. Коэффициенты описывают ожидаемое изменение результата при изменении предиктора на одну единицу при фиксированных остальных переменных в заданной модели. Это ассоциация, если только предположения о причинной идентификации и дизайн исследования не позволяют сделать выводы о причинности. Единицы измерения, кодировка, преобразования, взаимодействия и референтные категории определяют интерпретацию, поэтому коэффициенты без словаря данных являются неполными.
Классический вывод опирается на предположения о функциональной форме, независимых ошибках, постоянной дисперсии и распределении ошибок для конкретных тестов и интервалов. Графики остатков против предсказанных значений выявляют нелинейность или гетероскедастичность; Q–Q‑графики оценивают хвостовое поведение; меры рычагов и влияния выявляют наблюдения, сильно влияющие на оценки. Коррелированные предикторы увеличивают неопределённость и делают отдельные коэффициенты нестабильными, даже если предсказания остаются приемлемыми. Может потребоваться использование робастных стандартных ошибок, преобразований, сплайнов, иерархической структуры или иной модели вместо удаления неудобных точек данных.
Регуляризация, оценка и ответственное использование
Ridge‑регрессия сжимает коэффициенты L2‑штрафом, тогда как Lasso может обнулять некоторые из них L1‑штрафом; Elastic net объединяет оба подхода. Стандартизируйте предикторы, когда шкалы штрафов должны быть сопоставимы, и выбирайте силу штрафа с помощью валидации или кросс‑валидации. Оценивайте среднюю абсолютную ошибку, корень среднеквадратичной ошибки, распределение остатков, калибровку по диапазонам и неопределённость, используя временные или групповые разбиения, отражающие практику. Сравнивайте с простым средним базовым уровнем и нелинейными альтернативами, но сохраняйте линейные модели, когда важны прозрачность и стабильность.
Экстраполяция за пределы наблюдаемых диапазонов предикторов следует по построенной линии без доказательств и может быть опасной. Следите за диапазонами признаков, пропусками, остатками и ошибками подгрупп в продакшене. Прогностические интервалы описывают неопределённость отдельного результата и шире, чем интервалы доверия для среднего; оба требуют предположений. Избегайте контроля переменных, вводящих причинную смещённость, когда цель — оценка эффекта. Линейная регрессия — точный инструмент для заданной зависимости, но не универсальная гарантия, что мир линейный или что коэффициент представляет собой вмешательство.
Практический пример: оценка времени доставки
Команда логистики моделирует длительность доставки по расстоянию, уровню сервиса, региону, дню недели и известным погодным условиям. Она проверяет нелинейные паттерны остатков и добавляет обоснованные сплайны и взаимодействия, а не рассматривает линейное уравнение как буквальную физику. Группы перевозчиков и маршрутов определяют валидационные фолды. Сообщаются средняя абсолютная ошибка, ошибка хвоста, покрытие интервалов и систематическое смещение. Отменённые доставки и данные, записанные после прибытия, исключаются или моделируются явно.
Коэффициенты документируются с указанием единиц и проверяются на нестабильность при коррелированных предикторах. Модель отказывается от экстраполяции за пределы проверенных диапазонов расстояний и регионов. Прогностические интервалы сопровождают оценки, а последующее планирование использует их неопределённость. Мониторинг отслеживает диапазоны признаков, остатки, покрытие интервалов и смещение после изменений сети. Утверждение о причинной связи между перевозчиком или погодой не делается на основе предиктивных коэффициентов; для поддержки вмешательства потребуются операционные эксперименты или более сильная идентификация.
Доказательства внедрения и готовность к эксплуатации
Производственное решение требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочую среду, входы, выходы, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базу и версионированный набор оценок до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входы, сдвиги распределения, отказ зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, затратами ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развёртывание, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно введёнными сбоями. Операционная телеметрия должна показывать качество входов, поведение выходов, версию модели или правила, состояние зависимостей, человеческие переопределения и подтверждённые результаты без сбора лишних чувствительных данных. Определите пороги оповещений и ответственного за реакцию, затем после развертывания проверяйте реальные данные, а не полагайтесь на офлайн‑показатели. Переоценивайте систему при изменении источников данных, пользователей, моделей, поставщиков, политик, оборудования или целей. Поддерживаемая система также нуждается в документированных процедурах восстановления, обучении на инцидентах, удалении и хранении данных, а также в чёткой точке, когда её следует отключить или заменить.
Часто задаваемые вопросы
Требует ли линейная регрессия только одну входную переменную?
Нет. Простая регрессия использует один предиктор, тогда как множественная линейная регрессия может включать множество числовых, закодированных категориальных, преобразованных и взаимодействующих признаков.
Может ли линейная регрессия доказать причинность?
Нет. Причинная интерпретация требует надёжного исследовательского дизайна и предположений о конфаундинге, отборе, измерении и вмешательстве. Один лишь предиктивный коэффициент описывает ассоциацию в построенной модели.
Основные ссылки












