
Основы ИИ
Что такое KNN (K-ближайших соседей)?

 Добавьте Unite.AI в избранные источники в Google
K-ближайших соседей (KNN) предсказывает результат, используя помеченные обучающие примеры, ближайшие к точке запроса. Для классификации соседи голосуют за класс. Для регрессии их целевые значения усредняются или комбинируются другим способом.
KNN — это метод, основанный на примерах, без обобщения: обучение в основном сохраняет обучающие примеры и необязательный поисковый индекс. Это не отменяет необходимость разделения данных на обучающие, проверочные и тестовые наборы. Оценка на отложенных данных необходима для выбора k, метрики расстояния, обработки признаков и правила голосования.
Ключевые выводы
- KNN делает предсказания локально; он не делит набор данных на кластеры заранее.
- Масштабирование признаков критично, поскольку расстояние определяет, какие примеры считаются соседями.
- Малый k может быть шумным, тогда как большой k может сглаживать локальную структуру.
- Высокая размерность, нерелевантные признаки, дисбаланс классов и медленный поиск могут ограничивать производительность.
Как работает классификация KNN
- Представить запрос и обучающие примеры в одном пространстве признаков.
- Вычислить расстояние от запроса до обучающих примеров.
- Выбрать k ближайших примеров.
- Предсказать класс большинства или использовать голосование с взвешиванием по расстоянию.
Взвешенное голосование дает более сильное влияние более близким соседям. При равенстве необходимо задать документированное правило, а соседи одинакового расстояния с разными метками могут заставить результаты зависеть от порядка или деталей реализации.
Регрессия KNN
Для регрессии предсказание обычно представляет собой среднее значение целевых переменных соседей. Взвешивание по расстоянию может уменьшить влияние более удалённых наблюдений. Медиана или робастная агрегация могут быть полезны, когда локальные цели содержат выбросы.
Метрики расстояний
Евклидово расстояние часто используется для непрерывных признаков, манхэттенское расстояние суммирует абсолютные разницы, а косинусное расстояние учитывает направление, а не величину. Другие метрики применимы к бинарным, категориальным, географическим, последовательностным или полученным эмбеддингам.
Называть KNN «непараметрическим» означает, что он не предполагает фиксированную конечномерную функциональную форму границы решения. Однако он всё же предполагает, что выбранное представление и метрика делают близкие точки релевантными друг для друга.
Почему важна масштабировка
Если один признак варьируется от 0 до 1, а другой — от 0 до 100 000, обычное евклидово расстояние будет доминироваться вторым признаком. Стандартизацию, нормализацию или специфические для домена преобразования следует подгонять на обучающей части и применять к проверочным, тестовым и производственным данным.
Нерелевантные признаки также искажают соседства. Выбор признаков, снижение размерности или обученные представления могут помочь, но каждый выбор должен быть проверен без утечки данных.
Выбор k
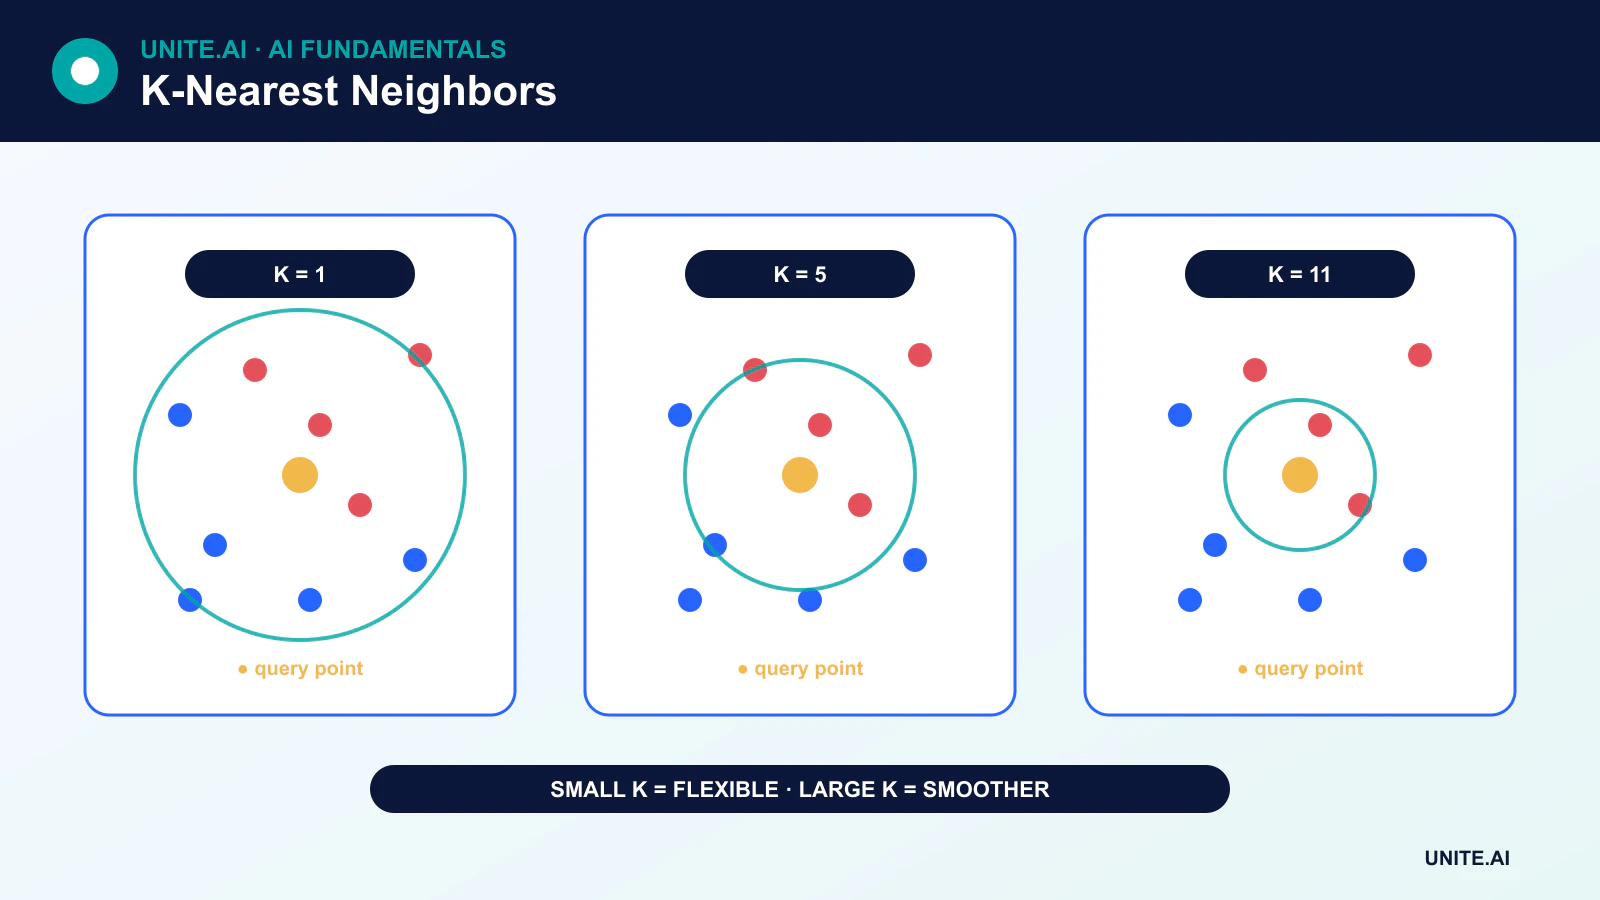
При k = 1 модель может следовать за шумом и ошибочно размеченными примерами. По мере роста k предсказания становятся более сглаженными и менее чувствительными к отдельной точке. Если k становится слишком большим, доминируют отдалённые классы или регионы, и модель недообучается.
Выбирайте k с помощью кросс‑валидации на обучающих данных. Для бинарной классификации нечётный k уменьшает, но не устраняет ничьи. Взвешивание классов, стратифицированные разбиения, выбор порога и соответствующие метрики важны при дисбалансе классов.
Проклятие размерности
В пространствах высокой размерности расстояния могут стать менее информативными, поскольку примеры разрежены, а ближайшие и дальние расстояния становятся относительно похожими. KNN может требовать огромных объёмов данных, чтобы поддерживать значимые локальные соседства. Это и есть проклятие размерности.
Снижение размерности или специализированные эмбеддинги могут помочь, но геометрию эмбеддинга следует проверять в соответствии с предполагаемым понятием схожести.
Производительность поиска
Запрос с полным перебором сравнивает новую точку со всеми сохранёнными примерами. Деревья KD и ball‑trees ускоряют некоторые точные поиски, хотя их преимущества уменьшаются в высокой размерности. Индексы приближённого ближайшего соседа жертвуют небольшим уровнем полноты ради значительного ускорения и экономии памяти. Эта идея также лежит в основе поиска векторного сходства.
Сильные и слабые стороны
KNN прост, поддерживает нерегулярные границы решений и предоставляет интуитивно понятное объяснение на основе примеров. Однако он может требовать значительной памяти, раскрывать чувствительные обучающие примеры, делать предсказания медленно и плохо работать, когда расстояние не имеет смысла. Это полезный базовый метод, а не подход, автоматически обеспечивающий высокую точность на большинстве задач.
Расстояния, соседства и поведение гиперпараметров
K‑ближайшие соседи хранят обучающие примеры и предсказывают, используя k ближайших согласно выбранному расстоянию. Для классификации используется большинство голосов или взвешивание по расстоянию; для регрессии — усреднение целей соседей. Масштабирование необходимо, поскольку признак с большим диапазоном может доминировать в евклидовом расстоянии. Категориальные, разреженные, последовательные или географические данные могут требовать расстояния Хэмминга, косинусного, редакционного, большого круга или обученных расстояний. Метрика представляет собой предположение модели о схожести и должна проверяться относительно реального смысла близких случаев.
Малый k создаёт гибкие границы с высокой дисперсией и чувствительность к шуму; большой k сглаживает предсказания и может стирать структуру меньшинств. Нечётный k лишь избегает некоторых бинарных ничьих и не является общим правилом. Выбирайте k, метрику, взвешивание, набор признаков и предобработку в рамках кросс‑валидации. Дисбаланс классов может заставить локальное голосование большинством игнорировать редкие исходы, поэтому следует проверять полноту по каждому классу и состав соседства. В высоких размерностях расстояния стремятся концентрироваться, а нерелевантные признаки ухудшают соседства; отбор, снижение размерности или обученные эмбеддинги могут помочь.
Индексация, неопределённость и эксплуатация в продакшене
Наивный вывод сравнивает запрос со всеми обучающими точками. Деревья KD и ball‑trees помогают в подходящих низкоразмерных пространствах; индексы приближённого ближайшего соседа меняют точность на скорость и масштабируемость. Оценивать полноту поиска соседей следует отдельно от качества предсказаний. Память включает сохранённые признаки, метки и структуры индекса. Обновления концептуально просты, но могут требовать перестройки индекса, согласованности версий и распространения удалений. Защищайте чувствительные обучающие примеры, поскольку возврат соседей или расстояний может раскрыть записи.
KNN может показывать примеры, делающие предсказание понятным, но близость не означает причинность или справедливость. Предоставляйте расстояние, маржу голосования и правило отказа, когда соседства разрежены или противоречивы. Отслеживайте расстояние запроса, метки соседей, дрейф признаков, задержку и подтверждённые результаты. Синхронизируйте версии предобработки и индекса и проверяйте точные против приближённых результаты после изменений. KNN является эффективным локальным базовым и поисковым методом, когда расстояние имеет смысл; он сталкивается с трудностями, когда схожесть нельзя представить доступными признаками.
Практический пример: KNN для замены товаров
Ритейлер описывает товары с помощью стандартизированных числовых атрибутов, категориальной совместимости и обученного текстового эмбеддинга, после чего определяет взвешенное расстояние, проверенное мерчендайзерами. K и веса выбираются на основе последующих запусков продуктов, а не случайных строк товаров. Оценка проверяет релевантность замены, несовместимые рекомендации, расстояние, покрытие категорий и результаты для редких товаров. Базовый показатель популярности показывает, добавляет ли локальная схожесть ценность.
Приблизительный индекс сравнивается с точными соседями по полноте и задержке. Запросы без близкого совместимого товара не возвращают предложение, а возвращают отсутствие результата вместо принудительного соседа. Удаления товаров и исправления атрибутов распространяются в индекс через версионные обновления. Мониторинг отслеживает распределения расстояний, пустые результаты, переопределения и коммерческие результаты, не путая продажи с истинной совместимостью. Конфиденциальные условия поставщиков исключаются из объяснений, а возвращённые примеры остаются доказательством схожести — а не утверждением, что товары эквивалентны.
Доказательства реализации и готовность к эксплуатации
Решение о вводе в продакшн требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочую среду, входные и выходные данные, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базу и версионный набор для оценки до настройки. Тестируйте обычные случаи, граничные условия, некорректный или отсутствующий ввод, сдвиг распределения, отказ зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и различить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный релиз, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно внесёнными сбоями. Операционная телеметрия должна раскрывать качество входных данных, поведение вывода, версию модели или правила, состояние зависимостей, человеческие переопределения и подтверждённые результаты без сбора ненужных конфиденциальных данных. Определите пороги оповещений и ответственного за реакцию, затем проверяйте реальные доказательства после развертывания, а не полагайтесь на сохранение офлайн‑производительности. Переоцените всё, когда меняются источники данных, пользователи, модели, поставщики, политики, оборудование или цели. Поддерживаемая система также требует документированного восстановления, обучения на инцидентах, процедур удаления и хранения, а также чёткой точки, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Есть ли у KNN этап обучения?
Он почти не требует подгонки параметров, но всё равно имеет процесс разработки: предобработка обучается на тренировочных данных, может быть построен индекс, а k, метрика, веса и признаки выбираются с помощью валидации.
Является ли KNN тем же, что и K‑means?
Нет. KNN в первую очередь является методом надзорного локального предсказания. K‑means — это алгоритм неконтролируемой кластеризации, в котором K обозначает количество центров кластеров.
Основные ссылки












